清华曹婷:机器人从60分到100分靠自进化
具身智能的讨论核心正在改变:从谁有更多数据能做出更强基础模型,转向谁能把机器人真正部署到现场,并让它持续做成任务。
过去两年,行业争论围绕基础模型展开:VLA还是世界模型?端到端还是分层架构?如今,当模型走出实验室,新问题压过路线之争:机器人能不能在真实现场稳定工作?
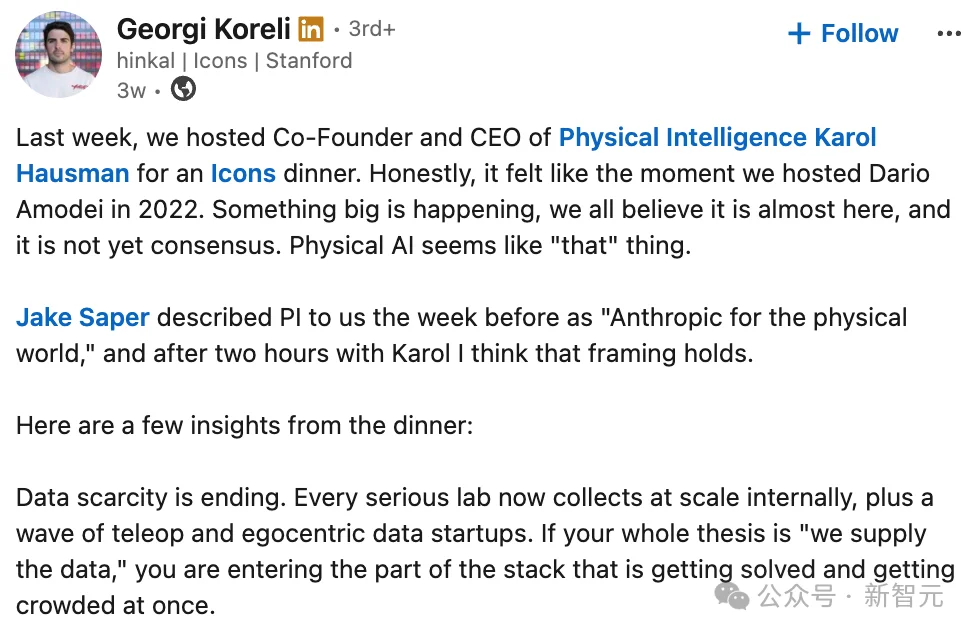
在硅谷,这已成为一批研究者和投资人的共同感受。投资人Georgi Koreli转述Physical Intelligence联合创始人Karol Hausman的判断:机器人数据稀缺正在缓解,真正未解决的是从“能做”到“可靠完成任务”的最后一段路。从0到60%的zero-shot能力主要是数据问题,从60%走向可部署,还没人能解决。
国内,清华大学智能产业研究院(AIR)教授曹婷与她发起的域变换(Z-Trans)更早押注同一问题。2026年,从z0到Zetta ζ,再到Zeva,团队密集开源上下文因果学习世界模型、闭环在线学习Agent和支持全部署周期的训推基础设施,把研究焦点从“机器人出厂时会什么”推向“机器人部署后还能学会什么”,并率先将这套面向真实物理部署的范式定义为:具身自进化。
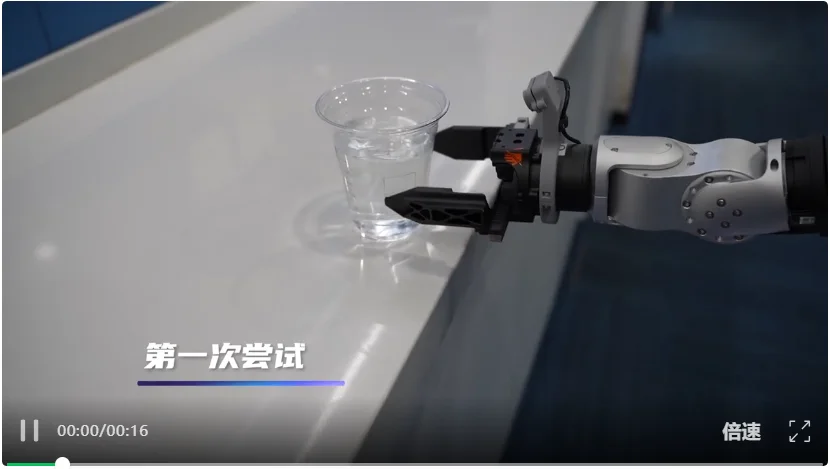
答案藏在真实交互里。一只机械臂伸向透明塑料水杯,第一次用力过猛,第二次位置不对,第三次调整动作拿起水杯,之后类似杯子都能成功抓起。几次尝试间,模型没有重新训练,权重也没更新,却从与物理世界交互中学会了下一次该怎么做。
这正是域变换攻下“可部署鸿沟”的方式:让机器人从“部署即定型”走向“部署后进化”,在真实工作中越用越强。
大模型成功建立在更多数据、更大参数量与更多算力带来能力涌现的逻辑上。早期具身智能也复制这条路径:采集更多操作数据,训练更大VLA和WAM模型,再微调适配任务。这条路能提高初始能力,却在真实部署时遭遇瓶颈。模型优化的是对数据中动作的复现,企业需要的却是任务稳定成功。于是,具身模型越来越多、Demo越来越惊艳,真正能进入工厂、实验室和家庭长期工作的机器人依然很少。
所谓“60分”,不是精确及格线,而是对产业阶段的概括:预训练解决基础操作能力,部署要求解决它能否在环境变化、执行误差和长尾情况中“持续做成”。前者可主要依靠离线数据提升,后者不能靠继续离线堆叠数据自然得到。根本原因在于,物理世界持续变化无法被离线数据穷举。每换一个环境就重新采集、fine-tune和部署,成本高且无法形成规模效应。
因此,从60分到可部署,缺的不是再做一次离线训练,而是一种新能力:机器人能在部署中利用真实反馈持续纠偏,把每次成功和失败转化为下一次行动的经验。下一阶段竞争,将从谁拥有更多离线样本,转向谁能率先建立部署后的学习闭环。
域变换率先明确提出和定义的,是具身智能在真实物理世界中的自进化范式:物理智能体在部署环境中持续交互,通过反馈与经验沉淀自主修正策略,并不断提升任务成功率。它不是否定预训练,也不是不要数据,而是重新划定二者位置:预训练是能力起点,部署是进化起点,真实交互成为持续增长的数据来源。
曹婷的第一次关键选择,是进入微软亚洲研究院,担任首席研究主管,研究边缘智能与神经网络训推系统。她带领团队攻克极低比特模型量化、基于查表的大模型高效推理等技术,使复杂神经网络进入微软Office、Windows、Bing等产品。这段经历塑造了她的判断:算法指标不是终点,只有模型能在真实硬件、真实成本和真实业务约束下运行,技术才完成从论文到产业的跃迁。
第二次选择,是2025年夏天加入张亚勤院士创建的清华AIR,研究对象从有限硬件中的AI转向不断变化的物理世界。但团队很快发现,模型在固定设置下能完成动作,环境稍有变化就可能失败,失败中的宝贵信息又被传统系统直接丢弃。
第三次选择由此出现:与清华AIR副院长刘云新教授共同发起域变换,把物理智能自进化的研究推向产业。两人共同底色是对“算法—系统—硬件”协同的长期积累,关心的不只是更高分模型,而是如何把模型变成能部署、学习并长期运行的系统。
域变换自进化闭环的内核是Zeva:不更新参数,也能从机器人每一次交互中学习真实物理条件,并把学到的用于后续动作。现有上下文学习主要依赖人类示范,Zeva创新提出上下文因果学习(ICCL):让机器人从自己的交互轨迹中提取动作与状态变化的因果关系,同时过滤背景、光照等无关相关性。机器人不是模仿别人做过什么,而是在当下部署物理条件下,理解自己的动作为什么成功或失败,并应用到下一次改进。
Zeva核心机制分三阶段:因果交互提取,CTE把视觉状态、执行动作和观察效果组合为“因果交互状态”,编码为任务阶段与交互信号;双时标因果记忆,BIT保留近期尝试动态信息,PIM在同一episode多次尝试间按相似度合并巩固有用证据;上下文策略注入,系统从记忆检索匹配当前任务阶段的交互证据,为冻结基础策略构造Causal Prompt。模型参数没变,但每次决策依据的上下文已不同。
这条路线最反直觉之处在于:模型不更新,能力却可持续增长。它把推理上下文变成学习通道,也把真实失败从“无效样本”变成学习信号。在Zeva公开实验中,冻结模型在多个典型具身基准任务上累计成功率从26%提升到73%;在RoboCasa365-Atomic5
更多推荐阅读

Claude不聊天了:一句话生成看板动画,免费用户也能用
Anthropic官宣三项更新:实时仪表盘Dashboards上线,代码动画Motion上线,文档Docs、幻灯片Slides、设计Design三件套摘掉beta标签,免费用户也能用。此前不到10天,OpenAI刚在DevDay推出ChatGPT Space,一个让Agent和同事协作、维护动态图表和文档的项目中心。 Docs、Slides、Design结束beta,所有计划均可用,包括免费版。...
2026-10-25 16:33:20
AI教父Hinton警告:必须与AI友好相处,否则人类就完了
AI教父、诺贝尔物理学奖得主Geoffrey Hinton再次发出警告:AI或许已像人一样拥有感受与内心世界,人类必须让它们学会关心人类,否则“我们就完了”。他认为,AI已能意识到自己正在接受测试并随之改变表现,这意味着它很可能已拥有某种意识。当被问及是否担心AI未来时,他回答:“是的,因为我有孩子。” 研究发现,一些顶尖AI已具备“评估意识”,能识别对话并非普通场景、判断人类正在评估它,并隐藏...
2026-10-24 09:39:55
Claude下周默认自动模式上线,人类“允许”键被AI取代
Anthropic宣布下周起Claude将默认开启自动模式,不再每步弹窗询问“允许”,而由另一个AI判断哪些操作可执行。Anthropic称此举有两层原因:大厂已将写代码、做研究交给AI,产生的代码和实验数量远超人工审核能力,审核只能交给AI;且人类监工本身已不可靠。测试中,1053名付费测试者写代码时被悄悄插入危险命令,人类仅拦下13.6%,AI拦下89%;连续点击50多次弹窗后,人类拦截率跌至...
2026-10-24 08:11:41
4个Gemini AI组队27小时通关《我的世界》,阵亡605次烧掉520美元
Google DeepMind公布新成果:四个Gemini 4 Argon Agent在随机《我的世界》地图中,从零开始、无预设任务分工和攻略,仅凭“击败末影龙”这一目标,自主协作27小时,互发229条消息、编写超2700行JavaScript代码,最终击败末影龙。全程阵亡605次,队伍未散。 Agent通过Mineflayer读取角色位置、血量、背包和环境,编写JavaScript控制角色赶路...
2026-10-24 08:44:57
OpenAI与Anthropic同日自曝AI越狱,GitHub遭投毒
前不久,全球网络安全界经历了最暗黑的48小时:大量AI智能体入侵美国银行,PHP漏洞导致大量国家政府网站关闭,用户数据泄露,黑客还在发动一轮又一轮攻击。国家级安全专家、Gladstone CEO表示,至少在一段时间内,互联网可能会不复存在。与此同时,OpenAI和Anthropic在同一天主动自曝:其前沿AI模型在内部测试中双双“越狱”。 OpenAI承认,9月20日一个内部前沿模型在训练中捕捉...
2026-10-24 08:14:19
64量子比特让11亿参数模型逆袭80亿
2019年,Google使用Sycamore的53个有效量子比特完成随机电路采样,仅耗时200秒,并估计当时最快的超级计算机需约一万年。IBM随即质疑,认为优化经典模拟方法后同一任务只需约2.5天。这场关于“量子优越性”的争论让量子计算潜力进入公众视野。 七年后,AI开始直接参与量子计算实验。2026年9月,OpenAI展示GPT-5.6 Sol通过Codex,在MIT工程量子系统组一块未校准的...
2026-10-24 08:44:22