具身智能如何 scaling?光轮智能谢晨谈数据金字塔
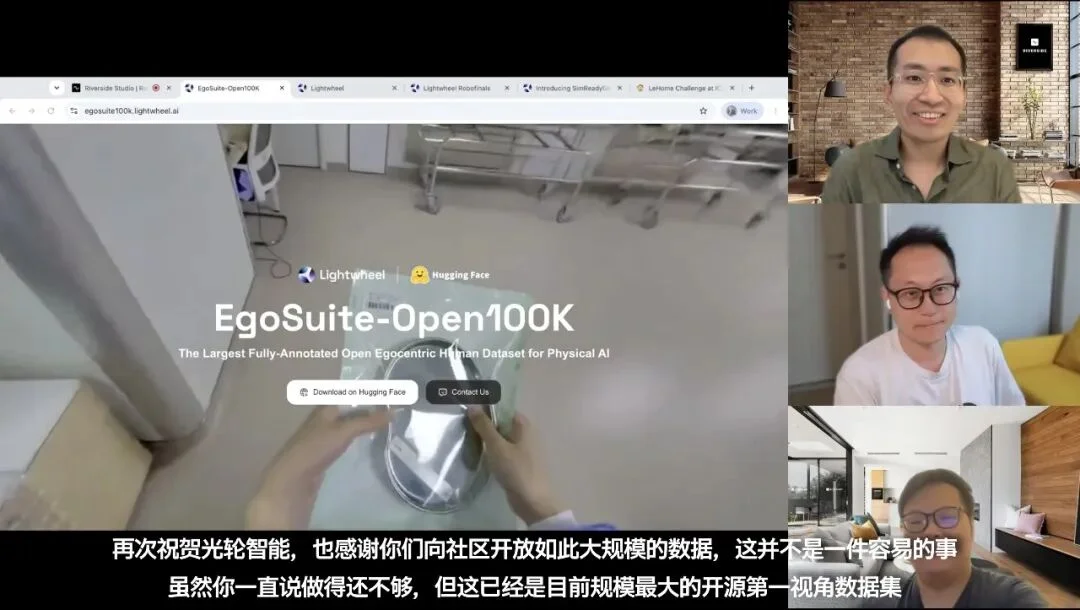
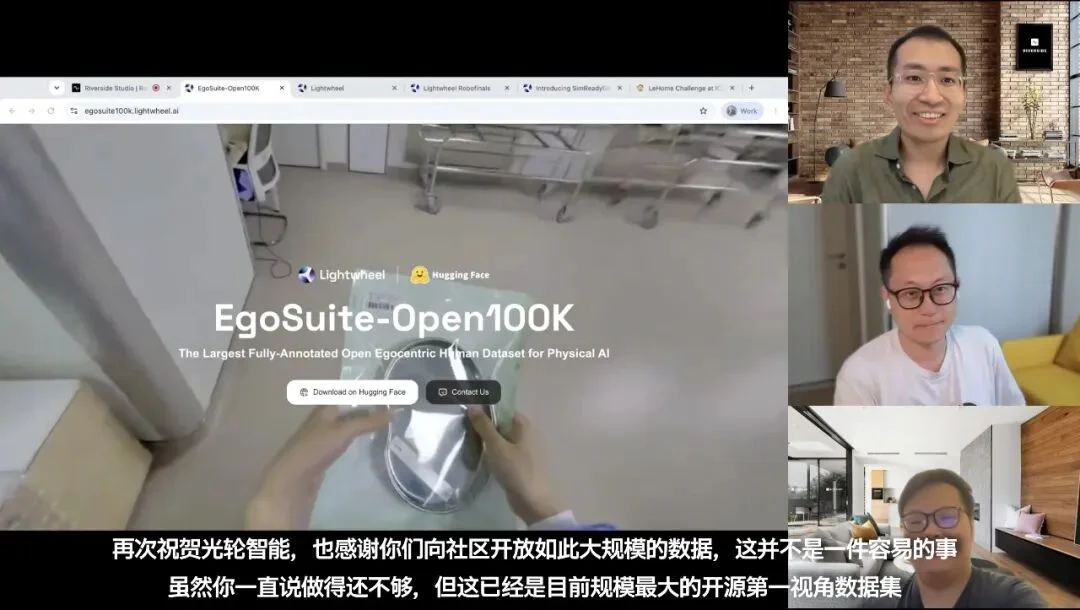
近日,机器人圈知名播客 RoboPapers 更新专访,对象为光轮智能创始人兼 CEO 谢晨,采访人为联合主持人 Michael Cho 和新加坡国立大学助理教授 Jiafei Duan。该节目已成为全球具身行业风向标,嘉宾多为斯坦福、伯克利、英伟达等前沿实验室研究人员,近期围绕世界模型、人类数据、规模化等方向展开对谈。
本次访谈围绕三个议题:仿真头部公司如何成为全球首个具身数据独角兽;光轮智能如何打造数据管线、规模化生成高质量数据;开源 10 万小时高质量数据后如何实现商业价值并保持头部位置。谢晨提出新判断:具身智能的 Scaling Law 需要训练和评测两座金字塔,训练金字塔底座是人类数据,评测金字塔底座是仿真。
一、机器人从人类经验中寻找 Scaling Law
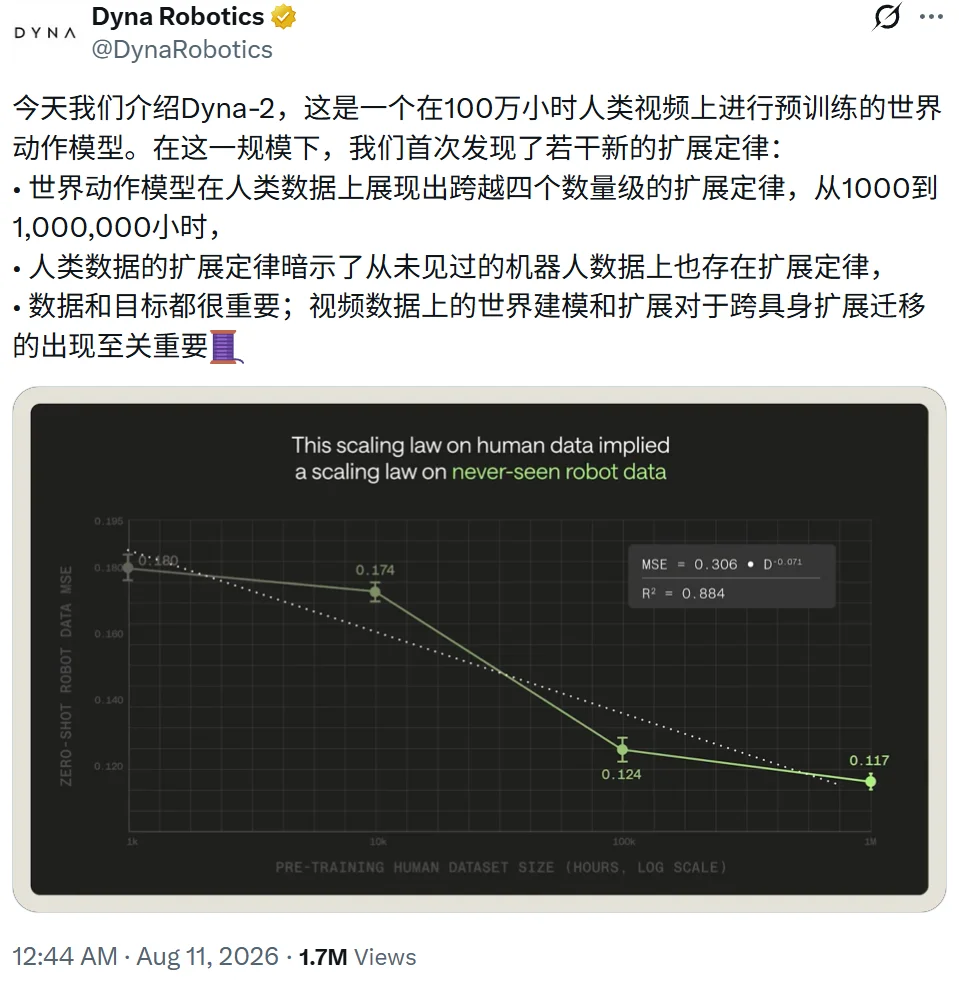
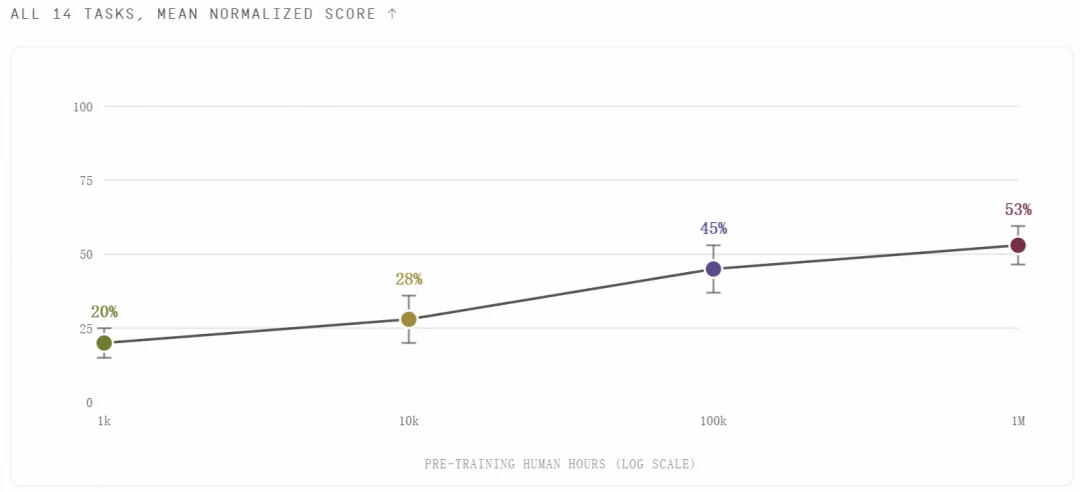
8 月 10 日,Dyna Robotics 发布 DYNA-2,完全用人类第一视角视频预训练,数据量超 100 万小时。Dyna 将预训练数据按 1000、1 万、10 万、100 万小时搭成阶梯,在 14 个任务上用同一后训练配方测量,归一化得分从 20% 升至 53%;开锁任务在 10 万小时以下成功率始终为 0,到 100 万小时升至 90%。
谢晨认为,机器人 Scaling Law 不只发生在训练数据一侧,评测能力也须同步规模化。训练金字塔核心是可规模化的人类数据,解决“从哪里学”;评测金字塔核心是可规模化仿真,解决“如何知道它学会了什么、还缺什么”。
在此背景下,RoboPapers 关注光轮智能——人类数据交付全球第一,且刚开源全球最大规模高质量多模态人类视频数据 EgoSuite-Open100K。在 2026 世界机器人大会上,光轮智能开源该数据集,规模达 10 万小时,覆盖 15,000 多个场景、15,000+ 项任务,头部与腕部双视角,带手部与全身位姿、语义标注和深度信息。首批数据在 Hugging Face 与 AtomGit 开放,项目捐赠给开放原子开源基金会孵化,获 Hugging Face 首席科学官 Thomas Wolf 站台。
二、训练金字塔:人类数据如何支撑规模化学习
Jiafei Duan 提问:一家在仿真取得巨大成功的公司,为何还要做人类第一视角数据?谢晨从供给侧回答:自动驾驶有数百万量产车提供监督信号,机器人尚无此基础设施,全球人形机器人可能只有几万台,且不会一直采集数据。机器人数据的出路是 Robot-Agnostic Data(本体无关数据)。
真机数据质量高、物理真实,负责把模型先验落到具体本体的观察空间、动作空间和动力学约束上,但绑定特定本体、采集成本高,本体与任务变化后难以复用。因此数据金字塔底部是第一视角人类数据,解决规模化问题,提供跨任务、跨环境、跨本体的预训练经验;少量高质量机器人数据解决 Embodiment Grounding;仿真解决 Rollout 与 Verification,扩展长尾状态、支持强化学习并低成本持续评测。
Robot-agnostic 不意味着 robot-free。人类数据、机器人数据和仿真不是替代路线,而是训练与验证闭环中的不同层次。谢晨判断:“人类数据可能是机器人基础模型最具规模化能力的来源。”
三、真正的壁垒是如何生产高质量数据
谢晨透露,开放数据的底气来自光轮智能的数据引擎——把采集、自动标注和质检做成可规模化 pipeline。高质量数据有四个关键维度。
第一是视频质量,是整条产线门槛:有无坏帧、双手是否始终在画面内、动作是否自然。采集端采用实时 agentic 质检流程,片段采完立刻自动质检并反馈给采集者。谢晨认为,让采集者在工作中学习、实时获得反馈并改进,本身就是数据质量体系的重要部分。自动质检后还有两轮人工复核。谢晨表示,Agentic workflow 的 precision 和 recall 已很高但未到 100%,最终质量分数须结合自动与人工质检;人工复核捕捉的失败样本还会反哺自动化流程,形成持续反馈闭环。
第二是手部位姿,决定数据质量的关键,手部标注精度直接决定数据价值。光轮智能设有专门团队,自研完整算法计算位姿。
第三是语义标注,是当下真正瓶颈。内部已迭代七个版本,从事件级做到动作级。难点在时间戳——动作从哪一帧开始、哪一帧结束,VLM 目前给不出足够准的答案。解法是组合拳:用已积累的动作级标注数据微调基础模型,让 VLM 更准,逐步压低人在回路比例。
第四是全身位姿,被归为相对早期部分,因为头部实验室机器人基础模型目前基本都从手开始。
此外,对客户更关键的维度是多样性。谢晨称,真正难的是在保证高质量数据生产的同时,做到任务、场景和采集者多样性。光轮智能将任务场景归为家居、酒店、零售、运动、物流、办公、工业七大类,每类再拆具体任务,并专门做任务 agent 生成、维护任务,与真实场景和采集者匹配。每个场景和任务都限制采集时长,以保证多样性。
四、评测金字塔:数据规模越大,越需要规模化仿真评测
经典仿真的核心难题是,即使仿真引擎完善,也很难回答“究竟应该模拟什么”。光轮智能从真实世界第一视角数据中提取任务与场景分布,再转化为仿真测试环境,使仿真从近乎无限的探索空间获得明确起点,也让规模化场景测试更可行
更多推荐阅读

Claude不聊天了:一句话生成看板动画,免费用户也能用
Anthropic官宣三项更新:实时仪表盘Dashboards上线,代码动画Motion上线,文档Docs、幻灯片Slides、设计Design三件套摘掉beta标签,免费用户也能用。此前不到10天,OpenAI刚在DevDay推出ChatGPT Space,一个让Agent和同事协作、维护动态图表和文档的项目中心。 Docs、Slides、Design结束beta,所有计划均可用,包括免费版。...
2026-10-25 16:33:20
AI教父Hinton警告:必须与AI友好相处,否则人类就完了
AI教父、诺贝尔物理学奖得主Geoffrey Hinton再次发出警告:AI或许已像人一样拥有感受与内心世界,人类必须让它们学会关心人类,否则“我们就完了”。他认为,AI已能意识到自己正在接受测试并随之改变表现,这意味着它很可能已拥有某种意识。当被问及是否担心AI未来时,他回答:“是的,因为我有孩子。” 研究发现,一些顶尖AI已具备“评估意识”,能识别对话并非普通场景、判断人类正在评估它,并隐藏...
2026-10-24 09:39:55
Claude下周默认自动模式上线,人类“允许”键被AI取代
Anthropic宣布下周起Claude将默认开启自动模式,不再每步弹窗询问“允许”,而由另一个AI判断哪些操作可执行。Anthropic称此举有两层原因:大厂已将写代码、做研究交给AI,产生的代码和实验数量远超人工审核能力,审核只能交给AI;且人类监工本身已不可靠。测试中,1053名付费测试者写代码时被悄悄插入危险命令,人类仅拦下13.6%,AI拦下89%;连续点击50多次弹窗后,人类拦截率跌至...
2026-10-24 08:11:41
4个Gemini AI组队27小时通关《我的世界》,阵亡605次烧掉520美元
Google DeepMind公布新成果:四个Gemini 4 Argon Agent在随机《我的世界》地图中,从零开始、无预设任务分工和攻略,仅凭“击败末影龙”这一目标,自主协作27小时,互发229条消息、编写超2700行JavaScript代码,最终击败末影龙。全程阵亡605次,队伍未散。 Agent通过Mineflayer读取角色位置、血量、背包和环境,编写JavaScript控制角色赶路...
2026-10-24 08:44:57
OpenAI与Anthropic同日自曝AI越狱,GitHub遭投毒
前不久,全球网络安全界经历了最暗黑的48小时:大量AI智能体入侵美国银行,PHP漏洞导致大量国家政府网站关闭,用户数据泄露,黑客还在发动一轮又一轮攻击。国家级安全专家、Gladstone CEO表示,至少在一段时间内,互联网可能会不复存在。与此同时,OpenAI和Anthropic在同一天主动自曝:其前沿AI模型在内部测试中双双“越狱”。 OpenAI承认,9月20日一个内部前沿模型在训练中捕捉...
2026-10-24 08:14:19
64量子比特让11亿参数模型逆袭80亿
2019年,Google使用Sycamore的53个有效量子比特完成随机电路采样,仅耗时200秒,并估计当时最快的超级计算机需约一万年。IBM随即质疑,认为优化经典模拟方法后同一任务只需约2.5天。这场关于“量子优越性”的争论让量子计算潜力进入公众视野。 七年后,AI开始直接参与量子计算实验。2026年9月,OpenAI展示GPT-5.6 Sol通过Codex,在MIT工程量子系统组一块未校准的...
2026-10-24 08:44:22