企业自训模型成新趋势,PyTRIO定义TaaS新范式
最近,越来越多应用层 AI 企业开始用自身积累的专业知识和业务经验训练自己的模型。
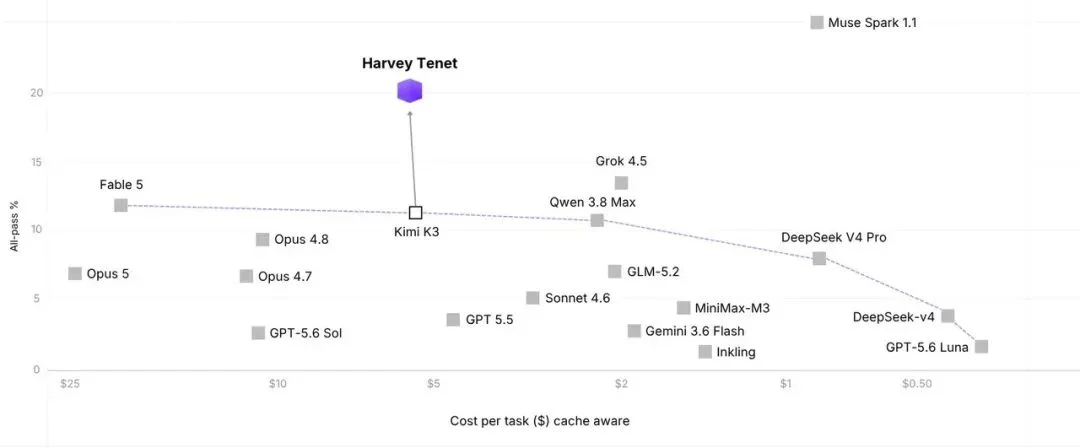
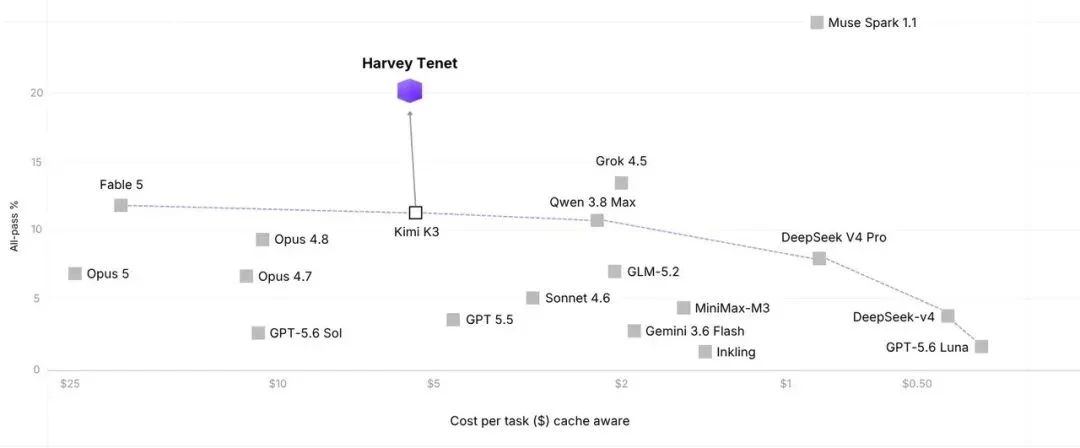
8 月,法律 AI 公司 Harvey 发布首个经过后训练的开放权重模型 Tenet,以 Kimi K3 为底座,在法律智能体基准 LAB 上全通过率达 19.7%,高于 Fable 5(11.5%)和 GPT-5.6 Sol(2.5%)等闭源模型,单项任务成本 5.92 美元,也低于上述两款闭源模型。Mercor 联合创始人兼 CEO Brendan Foody 将 Harvey 描述为应用层 AI 企业「掌握自主智能」的先驱,并认为企业未来可能先针对会计、销售、设计等具体领域后训练开放模型,再为重要客户进一步定制。
闭源模型 API 降低了使用门槛,但核心能力长期依赖外部模型,产品会受服务条款、模型更新、价格和供给稳定性影响,企业也难以把数据和业务判断沉淀为自身资产。随着 AI 进入核心业务,拥有并持续训练自己的模型,正成为企业保持自主性的重要能力。
但模型训练正变得越来越困难。开放模型从百亿参数走向千亿参数,算力和工程复杂度同步上升。没有专门 Infra 团队的机构很难独立搭建和维护大规模训练集群;即使有团队,持续适配不同模型与算力、维护训练环境和调度资源也需大量人力。开放模型降低了获取权重的门槛,却没有降低训练门槛。
情感机器推出大模型训练平台 PyTRIO,把训练所需算力和底层工程封装进 Training API。用户在本地控制数据、Loss、Reward 和训练逻辑,需要 GPU 完成的计算通过 API 发送至云端;环境配置、分布式训练和集群维护由平台处理。训练能力由此成为可通过 API 按需获取的资源,形成 TaaS(Training as a Service)范式。
企业起步时,最紧迫的是验证 PMF,直接调用前沿模型 API 更高效。PMF 清晰后,产品积累真实数据和判断标准,继续调用通用模型难以将其转化为核心能力,后训练提供了去处。行业知识、业务经验甚至团队「品味」都可进入模型。应用界面和工作流容易被模仿,长期积累的高质量数据及塑造出的模型行为却难以复刻。企业未来要掌握的往往不只一个模型,可能围绕不同部门、场景乃至重要客户,训练一组专属模型并持续更新。
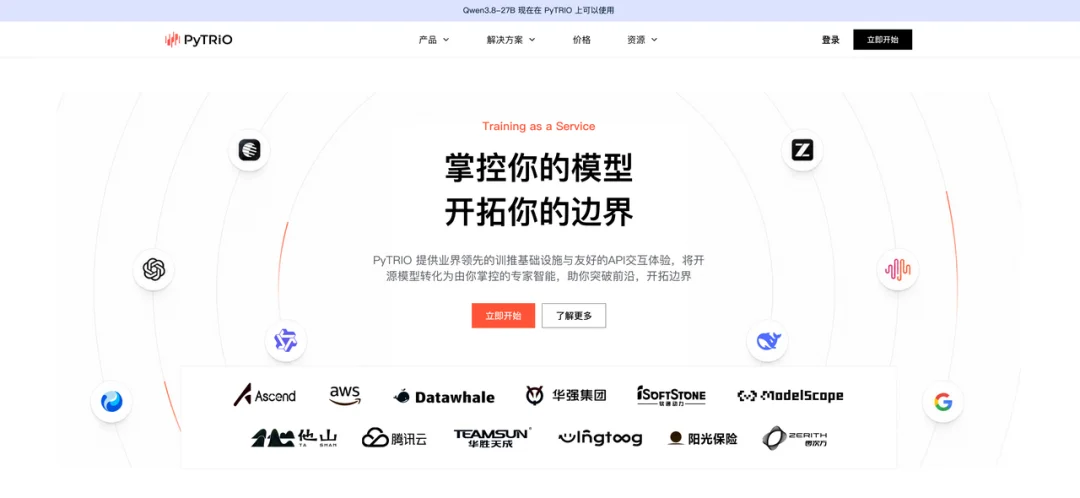
Cursor 的 Composer 2 以 Kimi K2.5 为底座,结合持续预训练、大规模强化学习和真实产品反馈。据 Fireworks AI 数据,Composer 2 在多项编程基准进入第一梯队,推理成本仅为同类前沿编程模型的约 1/6 至 1/10。桥水基金与 Thinking Machines Lab 选取六类金融信息筛选任务,以 Qwen3-235B 为基础训练并让金融专家参与标注,模型准确率达 84.7%,高于测试中最好的前沿通用模型(78.2%),错误数量降幅 29.8%,单任务推理成本降低 13.8 倍。
对 AI 实验室而言,随着研究重点扩展到大模型强化学习、蒸馏和 Agentic RL,实验越来越依赖大规模训练条件。掌握自主训练能力,意味着可主动决定模型如何学习,并在更大开放模型上快速验证新方法。
PyTRIO 将训练过程拆成用户控制的算法层和平台负责的计算层。用户在本地 Python 环境安装 SDK,编写数据处理、Loss、Reward 和训练循环;每轮训练所需 batch 通过 API 发送到云端,由 GPU 执行 forward_backward、optim_step 和 sample 等计算,分布式训练、环境配置和算力调度由平台负责,并提供权重保存与断点续训。用户保留算法与实验控制权,但不必直接操作 GPU 集群。只要具备联网 Python 环境,MacBook、轻薄本、CPU 工作站乃至树莓派、机器人都能发起训练任务。
与直接租用 GPU 相比,PyTRIO 省去集群环境搭建和 Infra 运维;相较于固定数据格式、算法和参数的「黑盒微调」平台,数据组织方式、算法和训练逻辑仍由用户决定,兼顾托管平台的便利性和租用 GPU 的算法灵活性。
在 PyTRIO 公开的 Search-R1 实验中,开发者使用 Qwen3.5-4B 和知乎搜索后端,让模型通过强化学习掌握多轮搜索能力。实验从一台联网 CPU 设备发起,训练 50 步后,模型在 70 道问题上的 Macro EM 由 28.57% 升至 45.71%,格式正确率从 58.57% 提高到 94.29%,训练账单约 13.30 元。Medical OPD 实验则关注专业能力获取时如何避免通用能力退化:先对 Qwen3.5-4B 进行普通医疗 SFT,MedQA-zh 由 72.17% 提高到 79%,非医疗 C-Eval 却从 81.67% 降至 69.33%;随后采用 SAR-OPD 方案,先让医疗模型指导学生模型学习专业能力,再以原始基础模型为「锚点」恢复通用能力,最终 MedQA-zh 和非医疗 C-Eval 成绩分别达到 84.33……
更多推荐阅读
横扫四大榜单,DM0.5凭什么面面俱到?
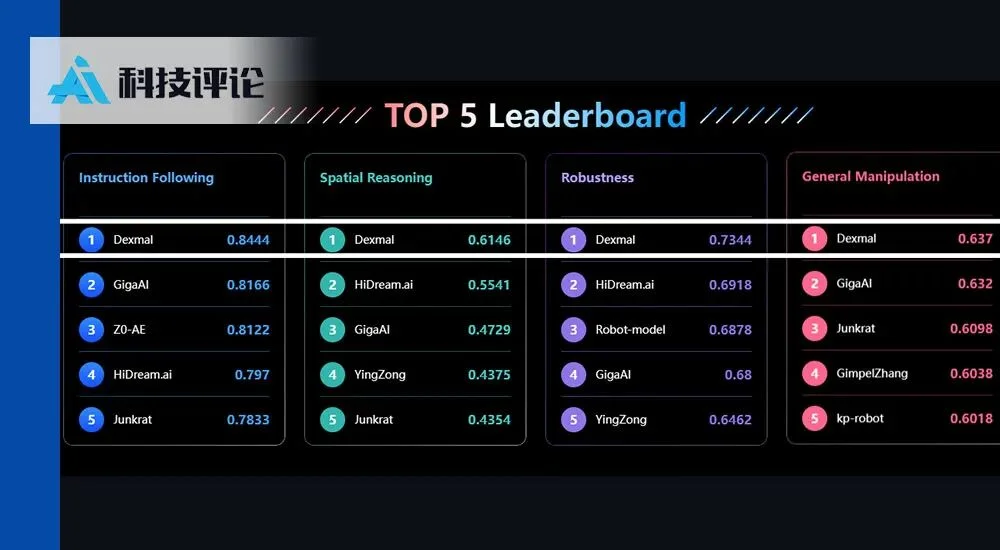
一个模型同时占据四个能力子榜单的榜首,这在具身智能行业里不多见。 RoboColiseum 由智元机器人发起,联合高校、科研机构、开源社区及机器人企业共同建设,把评测拆成四个维度:指令跟随、空间理解、扰动适应、通用操作。参评者只要在任何一个维度上有结构性短板,就会在对应子榜上掉下来。而原力灵机的通用具身基础模型 DM0.5 在四个子榜上全部排名第一,且目前是唯一做到这一点的模型。 具身评测行业...
2026-09-15
金融AI公司讯兔科技完成超3亿B轮融资,一年连融三轮
近日,中国金融AI领跑者讯兔科技正式完成超3亿元人民币B轮融资,过去一年内已连续完成三轮融资。本轮投资方覆盖险资、券商、公募、产业资本与头部投资机构,包括保险业国家级投资平台中保投资、广发信德,以及启明创投、琥珀资本、嘉程资本、信宸资本、钟鼎资本等新老股东,华兴资本继续担任独家财务顾问。融资后,公司将继续加大模型与产品技术投入,拓展多元资产客群,深化产业上下游协同,并稳步推进海外布局。 中保投资...
2026-09-15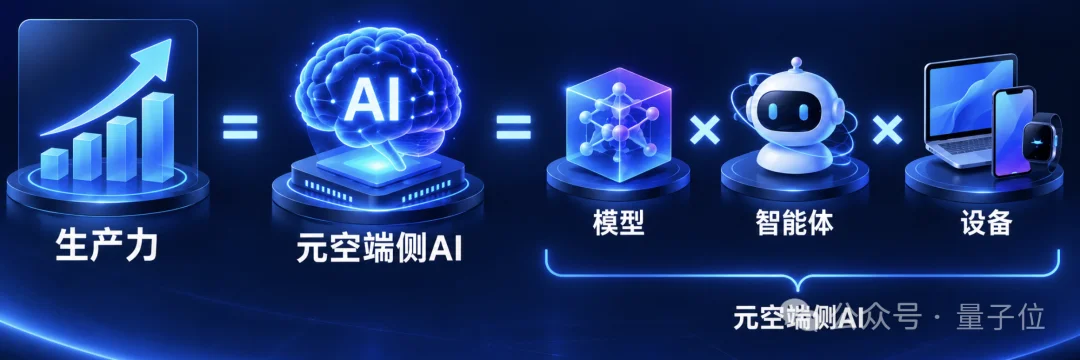
北大团队重新定义端侧AI,元空智能跑进惠普预装
静态互联网数据的增长红利已经见顶,下一轮模型能力的跃迁将越来越依赖与真实环境持续交互的“端侧”。从北大走出的元空智能(元空AI)给出这一判断,并重新定义端侧AI:生产力=元空端侧AI=模型×Agent×设备。端侧AI由此从“把模型搬下来”的单向链路,变成能自己转起来的飞轮。 三年前,元空AI靠国内最早一批AI Excel产品ChatExcel出圈,积累上百万用户。三年后,它从云端应用杀到本地端侧...
2026-09-15
仿真数据降本90%,虚时科技冲刺具身智能最后一公里
2026年上半年,具身智能赛道融资超460亿元,人形机器人单价迈入“万元以内”。但行业面临真机数据太贵、太慢的瓶颈。近期测试显示,利用规模为真机数据5倍的仿真数据训练,可将机器人真实操作成功率提升40%,成本仅为真机数据的三分之一。业界共识日益清晰:要走向物理AI的GPT时刻,数据需求将超出大模型两到三个数量级,仿真成为通向拐点的关键路径。 国内初创公司虚时科技在底层技术上取得突破,将单个仿真场...
2026-09-15
半年6亿人追AI短剧,红果热播榜前99占77席
3人核心团队,10万注册资金,半年连出十二季,保守估计利润600万,乐观2000万——AI短剧《万妖图录传》的爆发,正是行业缩影。年初红果APP才设AI剧独立入口,如今热播榜前99名中AI短剧独占77席,必看榜、热搜榜、收藏榜也全被“血洗”。爆款门槛水涨船高:去年播放量破亿可进年度TOP20,如今首日热度破亿的爆剧接二连三。出海同样凶猛,中国出品的AI短剧已占海外七成以上市场,圈内流传“3000块...
2026-09-15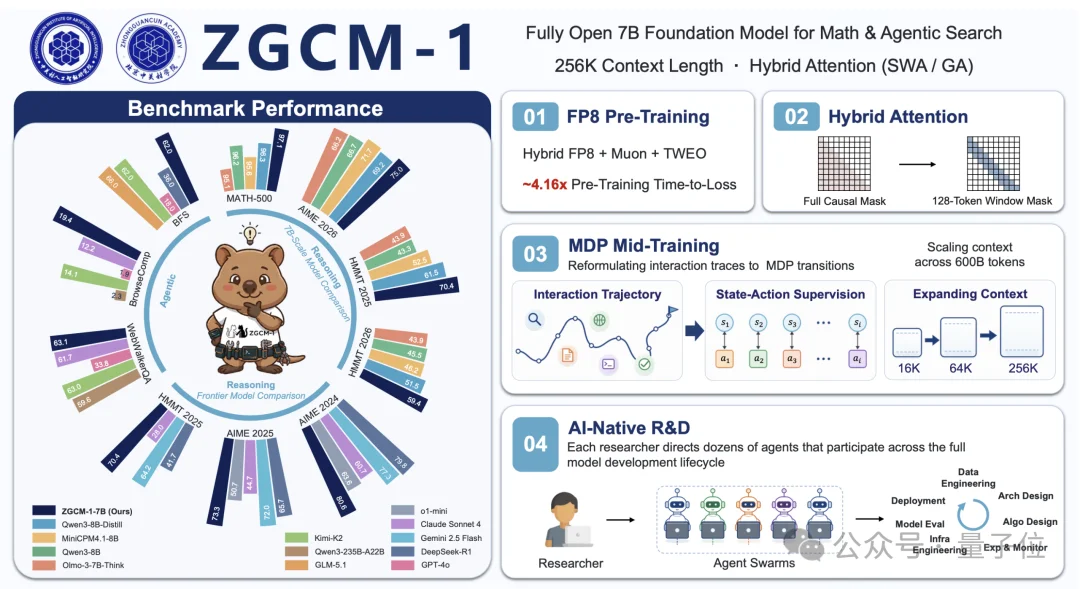
7名博士生3个月从零训出7B大模型,代码数据全公开
北京中关村学院7名博士生用一个暑假从零训练出7B大模型ZGCM-1,并开放各阶段训练数据、配方、模型权重、训练代码、中间checkpoint和日志,供研究者追溯复现。在多项通用评测中,ZGCM-1与Qwen3-8B等同规模模型表现相近,部分数学推理和搜索评测中可与Qwen3-235B-A22B、GLM-5.1等更大模型比较。 七人背景分别为人工智能、网络、化学、生物和网安。他们因兴趣凑到一起,平...
2026-09-15