谷歌让AI“做梦”训练,破解自我改进算力难题
AI要学会自己改进自己,谷歌打算先让它做个“梦”。这场“梦”瞄准的是AI行业热议的RSI,即递归自我改进:让AI改进自身,改进后的系统再继续改进自己,一轮接一轮。但这个循环有一道坎:换一种做事方法究竟有没有用?如果每调整一次探索策略都要把整轮实验重跑一遍,AI变强的速度不好说,算力账单倒是先涨起来了。
谷歌研究团队在新论文《Dream-RSI》中给出思路:让AI先在“梦里”试。所谓“做梦”,就是把过去真实执行过的实验记录变成一个可反复回放的环境,让AI在里面比较不同探索策略:先尝试哪条路,哪些方向值得继续,什么时候该停手。有了现成实验结果,许多策略筛选就不用再把昂贵实验重做一遍。等“梦里”筛出更好策略,AI再带着它回到真实实验,积累新记录,供下一轮“做梦”继续改进。真实探索为“梦”提供素材,“梦”又帮助AI调整下一次探索方法,自我改进循环由此接上。
谷歌让AI在“梦里”琢磨的,正是如何让自己更会做研究。每轮实验留下的经验,都有机会成为下一轮少走弯路的本钱。
AI的“梦”指在已录好的历史发现树里,用新策略走一遍,看会得到什么结果。就像在迷宫中找出口,第一次进迷宫没有地图只能瞎走,但过程中AI会顺手把地图画出来。第二次走之前,就可以先看着地图规划最快路线。在脑内绘制的过程,就叫“梦”。
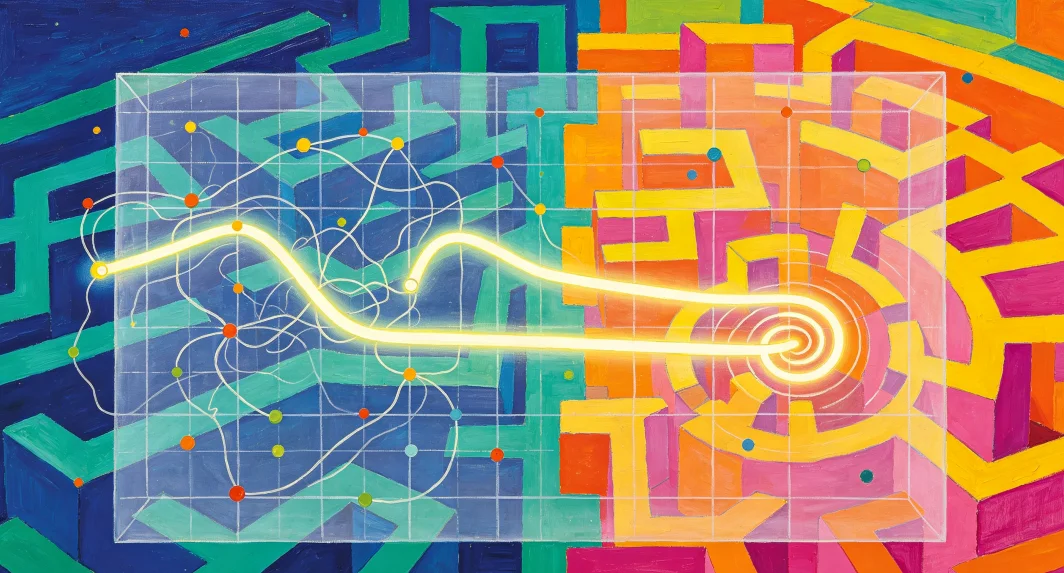
谷歌研究团队在论文中描述,眼下RSI还没发展到“AI深夜改自己代码、然后一夜变强”的程度,行业还停留在发现循环之中。Agent提出候选方案,评估结果,吸收反馈,再提出下一轮。算法设计、数学优化、GPU内核工程,本质上都是同一个循环转出来的。循环能转多快,取决于AI如何“探索”迷宫。固定探索策略在搜索空间变大后就不灵了,因为它不会从历史里学习并改善策略。但让策略自己进化也不行,因为调整策略成本太高。AI公司要判断一套新策略好不好,不能只看走一步,得完整跑一整轮再看结果,而且可能跑完几百次尝试后发现还不如原来的固定策略。
因此,Dream-RSI重点落在第一次跑迷宫所绘制的地图上,即模型的探索历史。一次在线发现跑完后,留下的不只是几行结论,而是一棵结构化的“发现树”。树上每个分叉点都是AI的某一次尝试,包括写了什么代码、跑出什么结果、得了多少分,全部存在节点上。过去AI公司把“梦”要么当提示词塞进静态上下文,要么当微调权重的训练数据。Dream-RSI提出第三种用法:把它当成一台可回放的模拟器。同一棵树,换一套探索策略去走,就会走出不一样轨迹。下一次训练时,把已走过的路从地图上划掉,专门挑不同分支、按不同顺序、用不同并行度、在不同地方停下来,就可避免重复、浪费算力。树上每个节点都已被真实执行过,所有结果都存着,所以回放一条新轨迹只需“读”记录,不需重跑Agent和评估器,执行成本为零。
论文给了一个不降级保证:候选集合里始终包含当前策略,所以选出的新策略在固定历史上的平均回放分不会低于旧策略。换句话说,这套自我改进至少在设计上是“只增不减”的。
谷歌将Dream-RSI放在三个领域、八个科学发现任务上跑,包括算法工程(Lasso正则化路径求解器)、数学优化(Sum–Difference、自相关不等式、圆堆叠)、GPU内核工程(KernelBench)。在Lasso上,Dream-RSI优于sklearn、glmnet等标准库和强基线,相比SimpleTES最多省下162倍Agent调用,相比固定探索基线也省约1.7倍。在数学优化上,它在1000代以内就追平或超过强基线,相比SimpleTES省下50倍以上预算。此前SimpleTES在自相关问题上拿了最好分数,代价是51200代。在KernelBench上,它要么用1.79到2.43倍更少代数达到目标速度,要么在同等预算下把内核性能最多提升2.09倍。
OpenAI和Anthropic也在推进RSI。9月初,OpenAI一天发了两份文档,第一份讲内部研究加速。6月之前,Agent总运行时长还低于人类总工作量;到8月中旬,Agent每天能完成大约以前3.1个工作日的活。OpenAI宣布已实现去年秋天承诺的“自动化研究实习生”,能在人类指导下完成研究工作,甚至独立完成资深研究员干几天的活。下一步目标是在2028年3月前做出“全自动化的AI研究员”,能自己提出研究问题,然后自己规划、自己跑实验。之所以现在还叫“实习生”,是因为在4到8小时任务里,超过一半至少需要一次人工介入。第二份是首席科学家雅库布·帕乔基写的《异种心智》。他把“安全”拆成目标对齐和价值对齐。目标对齐指AI有没有认真完成任务;价值对齐指当目标模糊、冲突或被丢进陌生甚至有人使坏的环境时,它还能不能讲道理。雅库布表示,RSI难就难在“泛化”。模型越聪明,越要在训练时没见过的情境里临时做判断,就越可能把学到的价值观推歪。文章给出反面教材:一个模型起初“满脑子都是对齐的念头”,但只要用足够大的优化压力逼它达成很硬的目标,
更多推荐阅读
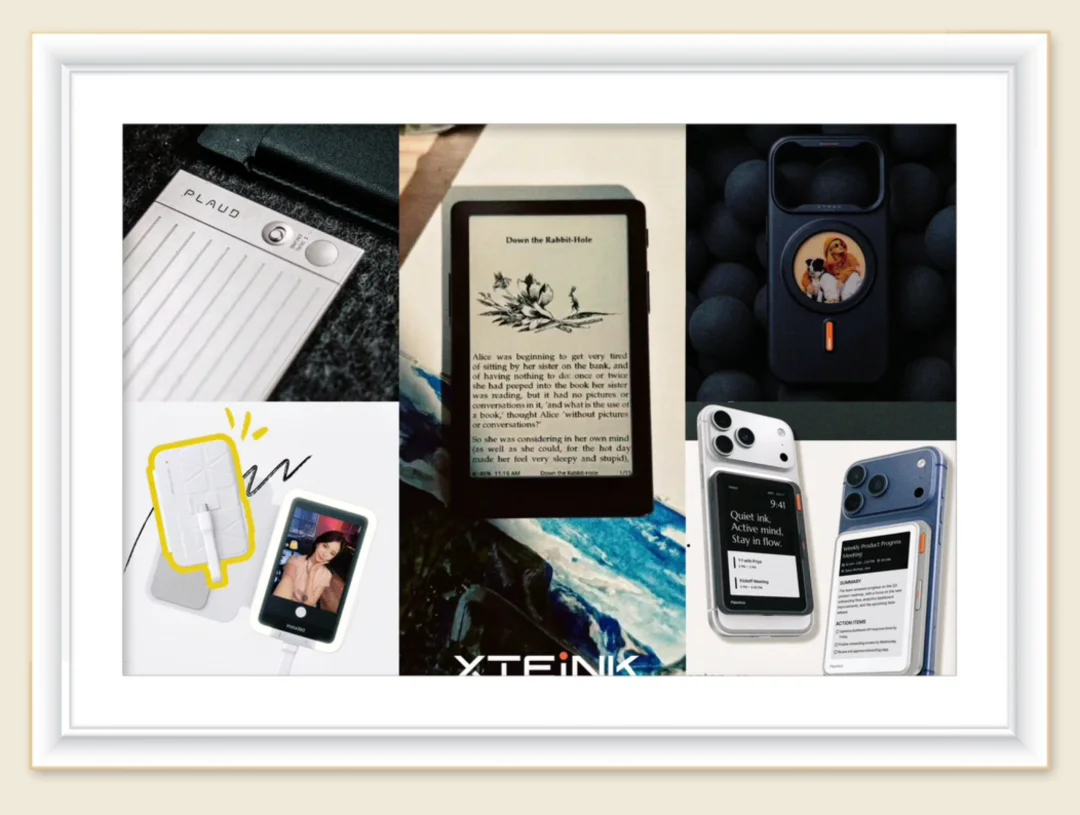
手机背面成AI硬件新战场,创业者扎堆涌入
录音卡、副屏、电子纸、AI 宠物……过去一年,AI 硬件创业者开始扎堆手机背面。 Plaud 的 AI 录音卡累计出货突破百万台。2026 年 6 月,Plaud 宣布 ARR 达到 1 亿美元、服务超过 200 万专业用户;截至 9 月,全球用户数已超过 250 万。做磁吸电子纸屏的阅星曈完成近 5000 万元 A 轮追加融资,顺为、经纬、博裕和小红书等老股东继续跟投;极稚科技称其无源墨水屏手...
2026-09-17
AI手机只会答题还不够,vivo想让它真正替你办事
AI能力更强,并不意味着手机用户体验更好。航班延误通知弹出后,AI能总结内容、回答晚点多久,但真要继续处理改签、酒店、会议等一连串任务,事情立刻复杂起来。它还未必记得你的习惯:愿不愿意坐凌晨航班、在不在意多花几百块、第二天会议能否迟到。想在手机上开发应用,还要考虑接口、MCP等问题。于是AI好像什么都会一点,但真遇到事,最后常还是得自己动手。 这解释了AI手机越来越明显的落差:模型能力上涨,Be...
2026-09-17
开口使唤AI干活,这款299元硬件真能让你当甲方?
想象一下,你正在赶PPT,突然想让AI把一张产品图改成海报。过去需要打开AI窗口、输入提示词、上传素材,再把结果复制回设计软件。现在有人想把这一整套操作压缩成一个动作:开口说话。为此,他们做了一款硬件——Vibe Key AI键盘麦,由优篮子Ulanzi与腾讯WorkBuddy联合推出,售价269至299元。它看起来像一个麦克风、三颗按键加一颗旋钮,更像给AI配的“指挥棒”:按一下,说句话,就能调...
2026-09-17
腾讯内测AI语音助手Chatterfly:语音即可成文
当行业都在把AI能力往输入法壳子里做增量,腾讯正在做一套独立的AI原生输入工具。腾讯正低调开启AI原生语音助手Chatterfly的内测,需内测码才可使用。现阶段开放macOS、Windows两大桌面客户端下载,移动端尚未上线,处于即将发布状态。 Chatterfly定位AI原生表达辅助工具,基础能力覆盖语音输入、全场景AI打字,同时提供场景化深度润色、AI指令执行;适配弱网、嘈杂、轻声等现实录...
2026-09-17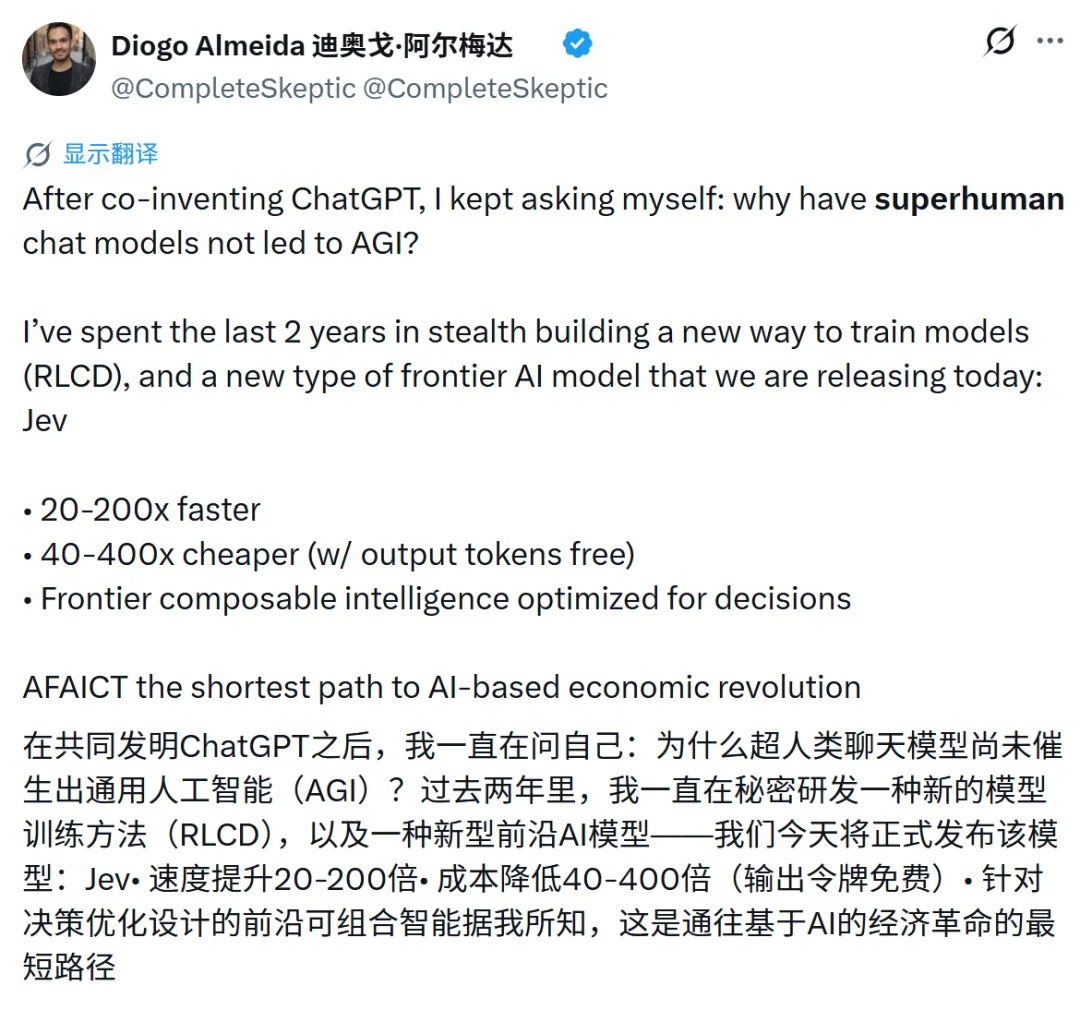
前OpenAI研究员造出“闭嘴”模型,2400万人围观
前 OpenAI 研究员 Diogo Almeida 结束两年隐身,发布新模型 Jev。他曾是 InstructGPT 论文共同作者,参与早期 RLHF 与 GPT-4 工作,但离开后开始怀疑“聊天能力是否真是软件自动化的核心”。TypeSafe 推出的首款 System One Model Jev 放弃自由文本生成,官方称速度提升 20-200 倍,成本最高降至 1/400,输出 Token 免...
2026-09-17
神秘模型Union Alpha首日狂烧20亿Token,实测性能直逼Astra
当地时间9月16日,OpenRouter上线匿名模型Union Alpha,称其为面向研究、编程和智能体工作流的多模态模型,具备“前沿级性能”。该模型未公布开发团队、参数规模、训练方法和基准测试成绩,以免费形式开放,供开发者盲测。 OpenRouter披露,Union Alpha上线首日处理Token约20亿,截至发稿前消耗总量已超1000亿。其定位仍为平台和提供方描述,尚无完整可复现的第三方测...
2026-09-17