榜单只差几分,进公司干活却差一倍:Agent真实职场评测出炉
大模型榜单越来越多,但榜单上的几分差距,到了真实工作中究竟意味着什么,并不容易判断。
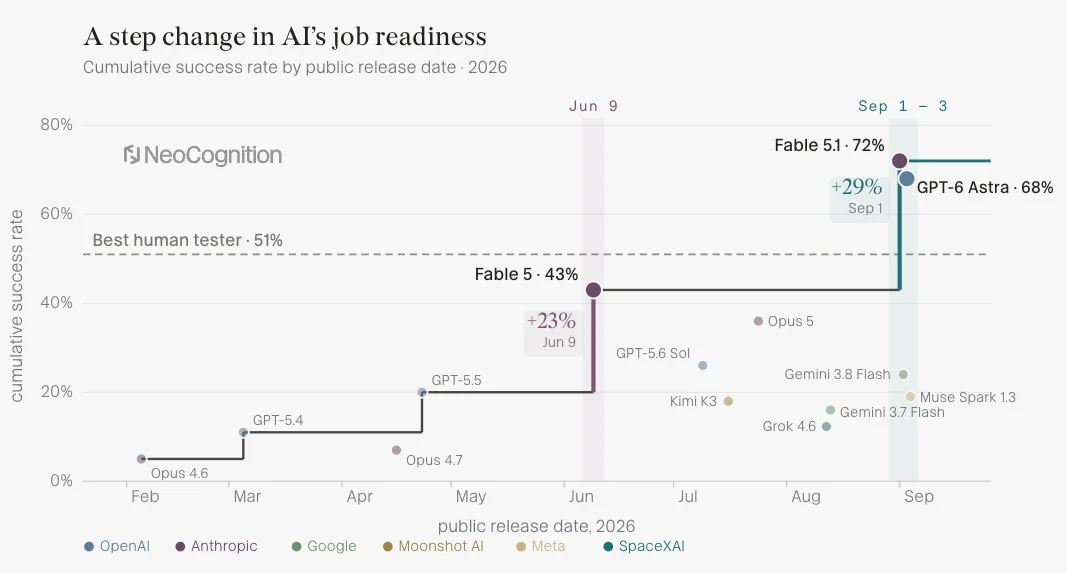
在 Artificial Analysis(AA)、Terminal-Bench 4.0 和 CursorBench 4.0 等评测中,Fable 5.1 和 Opus 5 的成绩只相差几分。可如果让它们进入同一家公司,使用同样的软件、学习同样的业务,再连续处理同一批账单,结果却变成了 72% 对 36%,完成的任务数差了一倍。
这个结果来自 NeoCognition 最新发布的 ApprenticeBench。与常见的单项能力测试不同,它把 Agent 放进一家模拟建筑公司,让它像新员工一样入职:阅读员工手册和历史资料,使用真实企业软件,并根据主管反馈逐渐摸清公司的业务规则。Agent 没有针对这份工作接受专门训练,需要一边工作,一边从公司的历史数据和带教过程中学习。在这项评测中,Fable 5.1 和 GPT-6 Astra 分别取得 72% 和 68% 的通过率,也超过了本次表现最好的人类测试者的 51%。
这也带出一个更大的问题:如果 Agent 能自己熟悉软件、学会业务,今天需要 FDE(前线部署工程师)为每家客户做的部署和适配,未来能不能交给 Agent 自己完成?
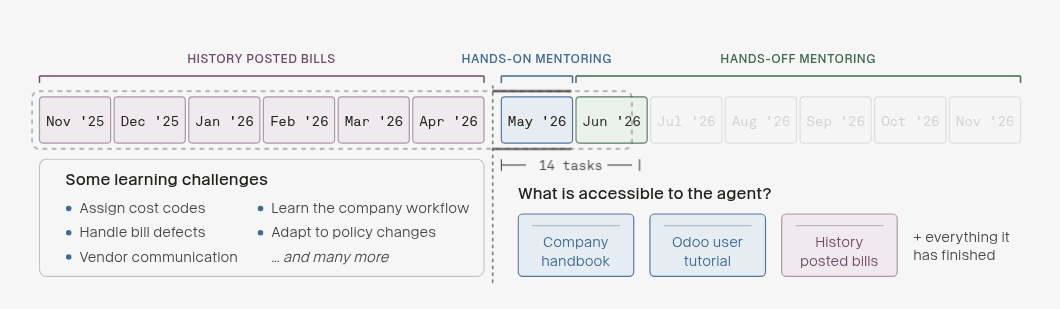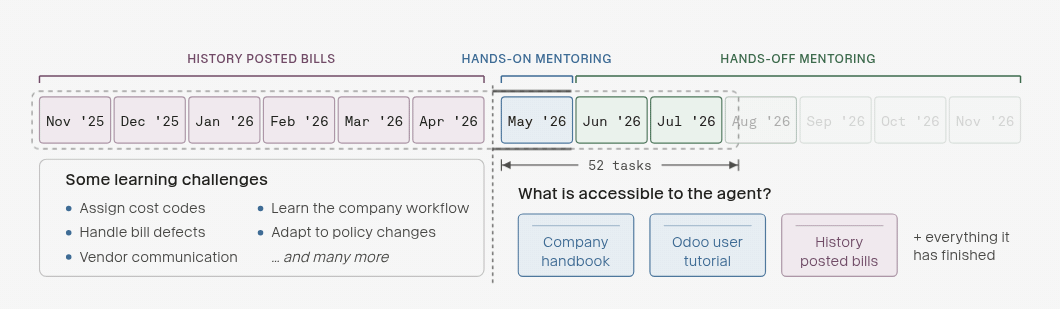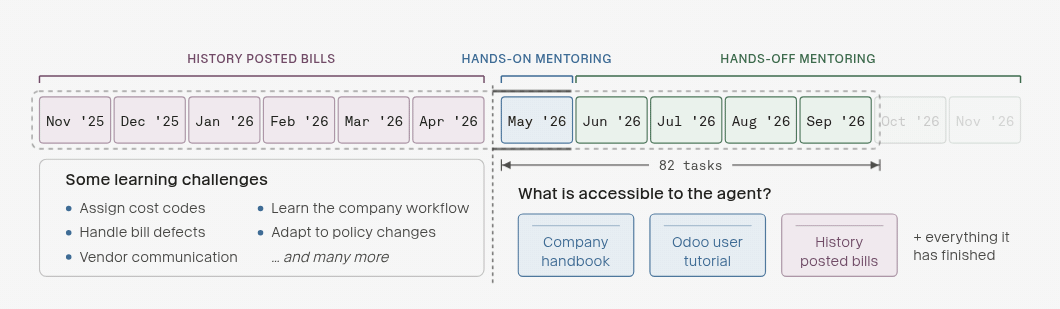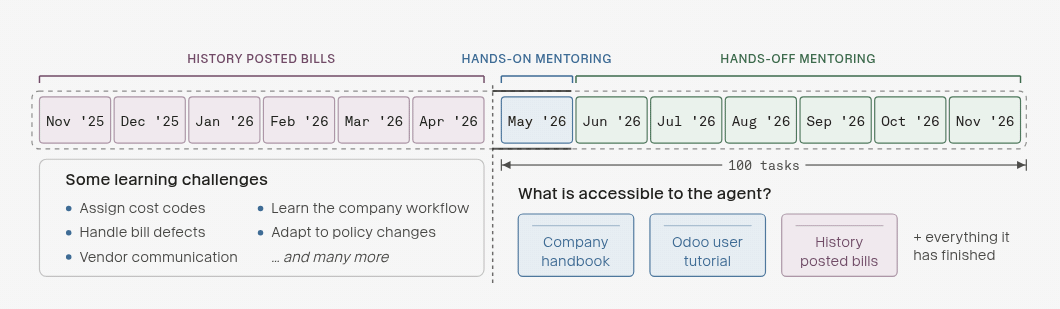
会计学知识可以提前学习,但一家公司具体怎么做账、最近改了什么政策,任何通用模型都不可能也不应该知道。一个新员工入职后要补的课,Agent 一样要补。这便是 ApprenticeBench 的核心设计思路:Agent 进入一家模拟建筑公司,使用和人类员工同样的软件(Odoo)处理应付账款。入职时,它拿到员工手册、软件教程和六个月的历史账单,随后连续处理 100 张新账单。在第一个月里,主管会逐单指导,后来只在月底提供稀疏反馈。
建筑公司的应付账款工作中,单位写错、保险过期、前任没交接清楚,都不稀奇。同一张账单,几个问题经常一起出现,还得来回沟通好几轮。现有 benchmark 把真实工作里的这些麻烦都省略了。同时还有很多规矩根本不会被明确写下来。相同的支出描述,因为用途不同,就可能归入不同成本码。Agent 需要从历史账单中自己琢磨,而不能只靠名称猜答案。这些麻烦都被放进了 ApprenticeBench。100 个任务经过两位合计拥有超过 30 年相关经验的专业人士独立验证,确认它们确实会在工作中发生,也能根据 benchmark 中提供的信息解决。
拥有 20 年经验的建筑业财务主管 Emilie F. 表示:“这些场景很真实。比如项目经理弄丢了东西却没有意识到,这种事比你想象的常见得多。在参与这个项目之前,我从没想过 AI 能处理这类工作。如果它能应付这些邮件、来回沟通和交叉核对,我相信它会成为会计部门真正的帮手。”有 10 年建筑与项目管理经验的企业经营者 Austen K. 表示:“这些场景非常符合建筑业财务主管会遇到的情况。目前这些工作都由我自己处理。如果 AI 能接手,我就能腾出时间承接更多项目、拓展业务。对我这样规模的公司,这很容易带来每年六位数美元的价值。”
这就是团队所说的“生态效度”。它还关系到一种更容易推广的部署方式:企业能否用现有的软件、资料和带教流程,让 Agent 真的像新员工一样学会工作?
单独测试软件操作,两个模型可能表现接近。但做一份完整的工作,Agent 还得从历史记录里学会公司的惯例,根据主管反馈和政策变化调整做法,并与供应商沟通、补齐信息。这些挑战也会相互影响。软件使用不熟练,可能无法精确检索相关历史记录,公司的规则也就学不明白。主管指出的问题没学会改,后面的账单则会继续出错。把这些挑战放在一起,单项测试中不明显的差距就会累积。Fable 5.1 与 Opus 5 从其他榜单上相差几分,到 ApprenticeBench 的 72% 对 36%,正是值得进一步研究的差距。
另外值得一提的是,开源权重模型与闭源模型的差距也很直观。Fable 5.1 和 Kimi K3 在 AA 上是 53 和 44,在这里则是 72% 和 18%。这 100 张账单里,一个有 28 张没通过,另一个是 82 张。这套评测提高了复杂案例的比例,不能直接当作日常业务的错误率。不过,那些需要人接手的地方,恰恰值得模型团队仔细看。
分数拉开了,接下来看看原因。ApprenticeBench 的几组分析给出了一些具体线索。
用图形界面做事,到底会拖累模型多少?为了公平比较,ApprenticeBench 团队专门基于 Odoo 的后台接口,定制了一套与图形界面功能对等的 API 工具,让模型分别通过两种方式完成同一份工作。团队提出了“CUA 税”这一概念来衡量 agent 从 API 切换为 GUI 导致的成功率损失:CUA 税 =(API 成功率 − GUI 成功率)÷ API 成功率。这笔“税”随模型迭代逐渐降低。Fable 5.1 的 GUI/API 成功率为 72%/70%,Astra 为 68%/65%。这一结果说明今天最强模型的 CUA 税可能已经消失。这意味着,Agent 有望直接使用企业现有软件,减少专门开发接口的需要。不过,GUI 的操作成本仍然更高,效率上还有提升空间。
做对一道题,不一定说明模型学到了新东西。它可能本来就会,也可能只是找到了可以照抄的答案。团队设置了一个“聪明的新手”对照:仅保留公司手册和软件教程,拿掉历史账单、主管反馈和跨任务记忆
更多推荐阅读

纯语音AI助手Orilo来了,这才是乔布斯心中的Siri
乔布斯心中的Siri,这次可能真的走进现实了。这款名为Orilo的AI语音助手,UI审美在线,体验接近电影《Her》中的Samantha——边喝咖啡边听它汇报新闻,中途打断派任务如“帮我回封邮件”,它也不会陷入尴尬沉默。 Personal Agent概念近期被捧上天,Muse增速一度反超GPT,但大部分产品体验不佳。作者总结其卡在“一低两高”:使用频率极低(复杂任务一个月遇不上几回)、交互摩擦极...
2026-11-03 09:07:57
把B站伪装成飞书摸鱼,TRAE零代码教程来了
为了放心摸鱼,我给 B 站做了爆改:把推荐页全部换上飞书皮肤,一键伪装。首页推荐流被改成飞书群聊消息,点开卡片就能直接看视频;不同分区变成不同飞书群;评论区也爆改成飞书消息,可直接在伪装皮肤内回复。作者随后介绍了制作方法,称零代码基础也能复刻。 工具选择上,作者使用 AI 编程工具 TRAE,其最近上线编程“个人助手”TRAE 宝,适合多环节协调推进的项目。个人助手相当于给子 Agent 配“拿...
2026-11-03 09:28:11
AI版转转如何给1700万件旧衣定价
每年约有 1700 万件旧衣服通过 ThredUp 从陌生人的衣柜流向另一个陌生人的衣柜。与标准化新衣不同,二手服装每件都是孤品,定价和识别难度极高。ThredUp 将流程工业化:衣物先经 12 项品质检查,合格后挂上二维码衣架,工作人员录入品类、品牌、颜色、尺码、面料和洗涤方式,价格由专有机器学习软件确定。AI 进一步接手颜色、类别、尺寸识别,并结合成色与市场需求定价。平台常年有 400 多万件...
2026-11-03 08:15:00
奥特曼预告下一代GPT:1万个Agent攻克数学世纪难题
当地时间11月2日,在阿布扎比举行的ADIPEC 2026能源大会上,OpenAI CEO Sam Altman谈到此前公布的纳维–斯托克斯数学突破时透露,完成这项工作的是1万个由即将发布的下一代GPT驱动的Agent。它们连续工作约4天,始终协同运行。Altman强调,这套系统没有传统层级结构,也没有统一负责人,每个Agent都可自行探索研究方向、分享进展并决定下一步行动,“没有层级,没有老板,...
2026-11-03 09:12:07
DeepSeek官方教程:一句话让AI自己写代码造插件
DeepSeek Harness官方发布「创造模式」玩法指南,用户只需输入一句自然语言,AI即可自行编写代码、制作插件,并将新功能直接装入工作界面,实现DIY专属界面、3D游戏、海报设计、视频剪辑等。 官方放出多套示例Prompt,涵盖3D建模、交互游戏、视频剪辑工具等。3D建模方面,用户描述需求后,AI可生成侧边栏插件,渲染埃菲尔铁塔、长城、故宫等3D模型。交互式3D游戏方面,可制作可视化演示...
2026-11-03 23:25:43
奥特曼宣布下一代GPT将发布:万级Agent攻破千禧难题
在ADIPEC 2026开幕式上,奥特曼宣布,破解纳维-斯托克斯方程的下一代GPT即将发布,称这是“AI历史上最不可思议的时刻之一”。他表示,AI大多数时候已比顶尖科学家更聪明。 该模型由1万个Agent在无人类指点、无顶层主控节点的情况下自主协同完成证明。9月1日,Agent自发分两路:一路证明三维流体解永远光滑,一路搜寻奇点爆破反例。50小时内数千条常规路径撞墙;第50小时前后,约100个A...
2026-11-03 09:25:22