OpenAI前研究员造出不做聊天的AI,速度快200倍
9 月 15 日,前 OpenAI 研究员 Diogo Almeida 公布了过去两年秘密推进的项目——全新 AI 模型 Jev。与 ChatGPT、Claude 等主流 LLM 不同,Jev 不生成自然语言,而是直接输出结构化判断、概率和置信度。这是 Almeida 创办的 AI 初创公司 TypeSafe AI 推出的首款模型。2024 年离开 OpenAI 后,Almeida 与几位联合创始人组建 TypeSafe,此次正式亮相并披露完成 4,000 万美元种子轮融资,由 DCVC 领投,估值约 2 亿美元。
TypeSafe 将 Jev 归入名为 System One 的新模型类别,宣称在特定结构化工作流中,Jev 最高可比前沿 LLM 快近 200 倍、便宜 400 多倍,并能把“幻觉”和类型错误率做到 0%。Almeida 曾参与 2022 年 InstructGPT 研究,将监督微调、人类偏好数据和 RLHF 结合,让 GPT-3 更能按人的意图回答,ChatGPT 后来也沿用了相近路线。如今他反过来追问:如果 AI 最终要进入软件后台持续做判断,是否还有必要每次先生成一段文字,再交给程序解析?
要理解 Jev,需区分人与 AI 交互和机器调用 AI 两种场景。ChatGPT、Claude 等本质是生成模型,接到输入后不断预测下一个 token,即使要求 JSON 或函数调用,底层仍按序列逐步产生 token。这种设计适合聊天,因为字符串是极其通用的接口。但在软件后台,比如电商系统需连续判断订单是否异常、进入哪个审核流程、客户流失风险多高,软件最终需要的可能只是几个值,却要先等 LLM 生成字段名、数字、标点乃至额外解释,再解析检查才能进入下一步。
Jev 想直接去掉中间环节。TypeSafe 概括其接口为“unstructured state in, typed probabilistic decisions out”,输入复杂业务信息,输出预先定义好的判断结果和概率。例如客服系统收到投诉记录,传统 LLM 可能生成一段文字,程序还要从中提取“高风险”“转人工”“退款”等结果;Jev 则直接返回“流失风险 82%”“转人工 91%”“退款 37%”,程序可直接进入下一步。采样方式上,TypeSafe 称 Jev 使用并行采样器,可在一次查询中并行产生多个结构化结果。
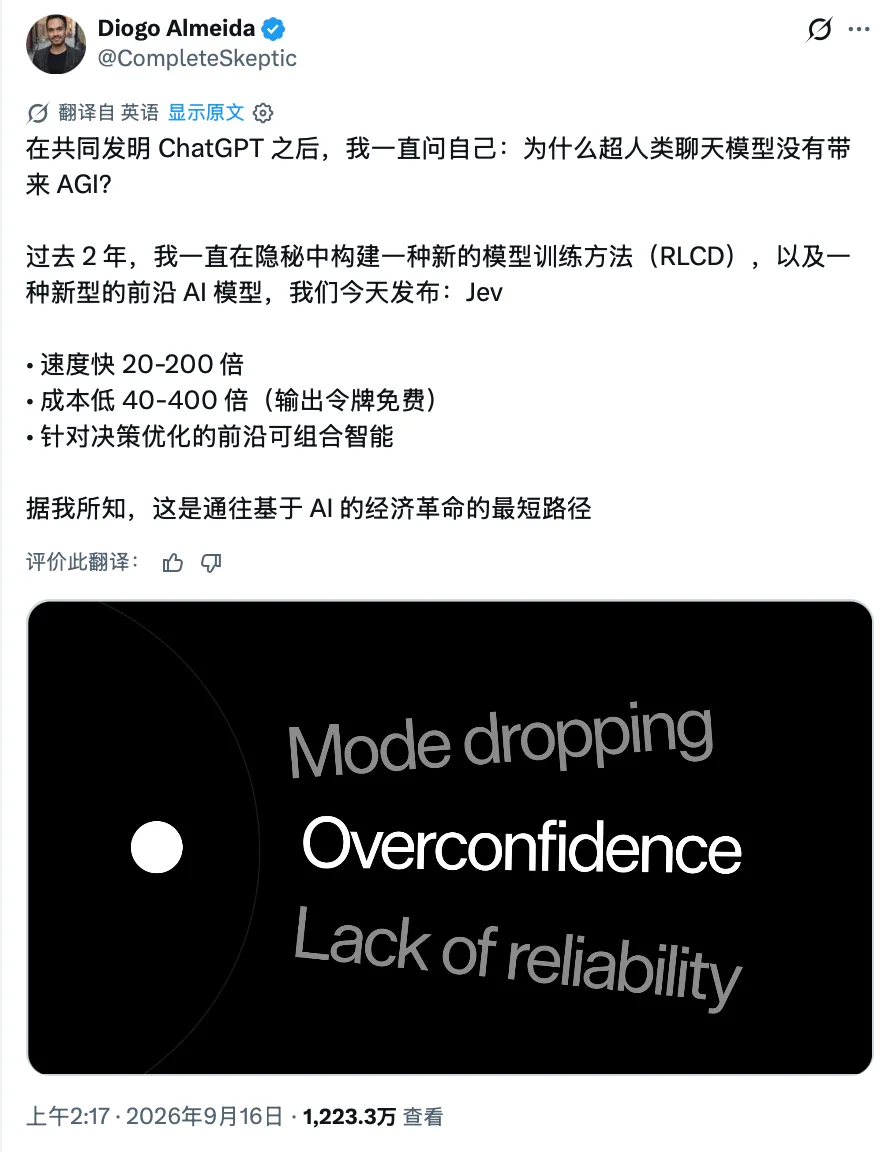
不过“全新架构”说法有待考察。TypeSafe 只披露了“new model architecture”、并行采样器及新训练方法,未公开参数规模、网络结构、backbone、预训练方式和训练数据。目前能确定的是它明显改变了输出接口、训练目标和采样方式。
与 Jev 配套的是 TypeSafe 提出的新训练方法 RLCD(Reinforcement Learning for Calibrated Decisions),不再主要优化回答是否讨人喜欢,而是训练模型在做结构化决策时给出尽可能可靠的概率和置信度。例如模型对很多判断都给出“90% 的把握”,统计下来这些判断中大约应有 90% 最终正确,这就是 calibration。TypeSafe 认为这比只给“是/否”更适合自动化系统,程序可根据置信度决定自动执行、继续验证或交给人工。
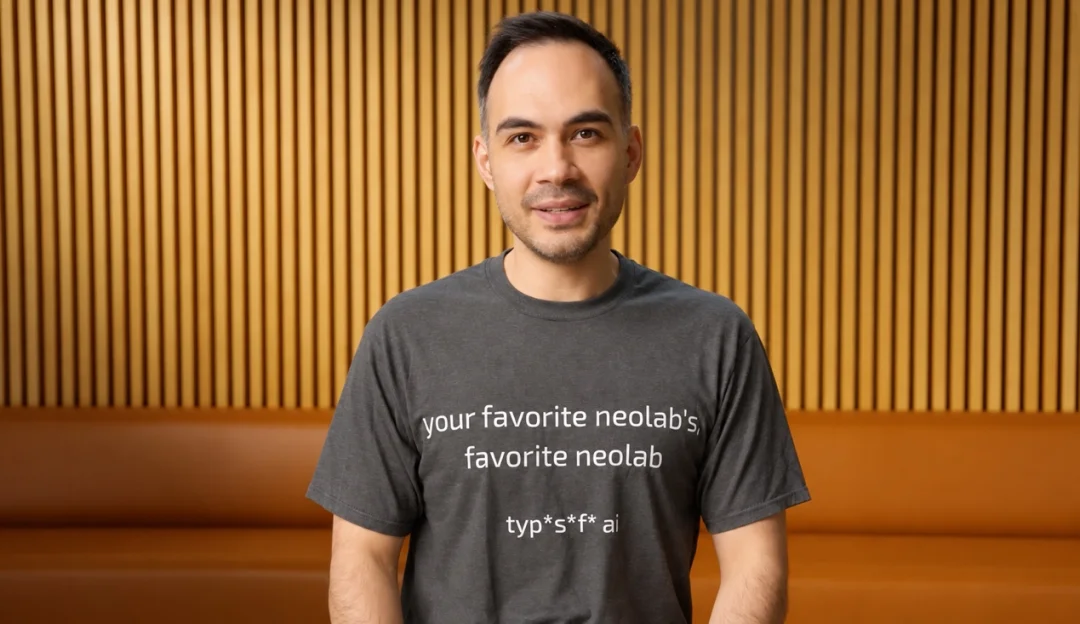
Jev 目前瞄准分类、路由、评分、信息提取、业务流程分支、大规模数据处理,以及给其他 LLM 做 judge、guardrail 和越狱检测等场景。公司把它形容成一种“smart if-statement”:原本必须由程序员提前写死规则的地方,可插入一个能理解语义的概率判断。为展示低延迟,TypeSafe 甚至让 Jev 玩《毁灭战士》,但模型读取的是已转换成文本和数据结构的游戏状态,并未直接处理画面,公司也承认传统专用游戏 Bot 完全可以玩得更好,展示重点是模型可每秒连续接受多次查询,在实时软件中反复做判断。
Jev 发布时最吸引眼球的是“20~200 倍更快”和“40~400 倍更便宜”。从技术原理看,Jev 面向结构化决策任务,不需像传统 LLM 那样自回归生成几十甚至数百个 token,而可一次性给出一组概率或判断,响应时间和推理成本天然更低。在一项与 GPT-5.6 Terra 的并排演示中,Jev 可一次输出所有概率,而 GPT-5.6 Terra 仍需逐 token 生成答案,速度差非常明显。但公司也说明,该演示经过高度简化:输入较短、信息密度高,问题也被整理成适合结构化判断的形式,这些条件都会放大 Jev 的优势。
官网中“193.6 倍更快、444.6 倍更便宜”的数字来自 TypeSafe 自行设计的 workflow eval。4 个工作流都包含大量独立判断,但评测没有采用现实世界 ground truth,而是把 GPT-6 Astra 和 Fable 5.1 的预测概率取平均作为参考,再衡量 Jev 与这个参考值有多接近。因此,这套 benchmark 更适合说明:在 TypeSafe 设定的结构化决策任务里,Jev 可以用更低时间和成本,做到与前沿 LLM 相近的判断,还不足以证明 Jev 已拥有与这些模型相同的通用能力。TypeSafe 自己也称,193.6 倍和 444.6 倍属于预计在现实场景中“偏高端”的收益,且 4 个 workflow 由自己的模型能力团队制作,可能存在选择偏差。对照组中的 LLM 还要通过 TypeSafe 的 System One wrapper 输出完整概率,也会增加延迟和成本。
另一个值得注意的说法是,TypeSafe
更多推荐阅读
Claude大统一:聊天Cowork合并,新增文档幻灯片
Anthropic 宣布将 Claude Chat 与主打复杂任务处理的 Cowork 合并为统一版本的 Claude,同时推出 Claude Docs 和 Claude Slides 两项新功能,并将 Claude Design 能力整合进聊天界面。Claude 正从对话窗口变为覆盖写作、办公、设计和复杂任务执行的 AI 工作空间。 过去一年,Anthropic 持续扩展 Claude 能力:...
2026-09-17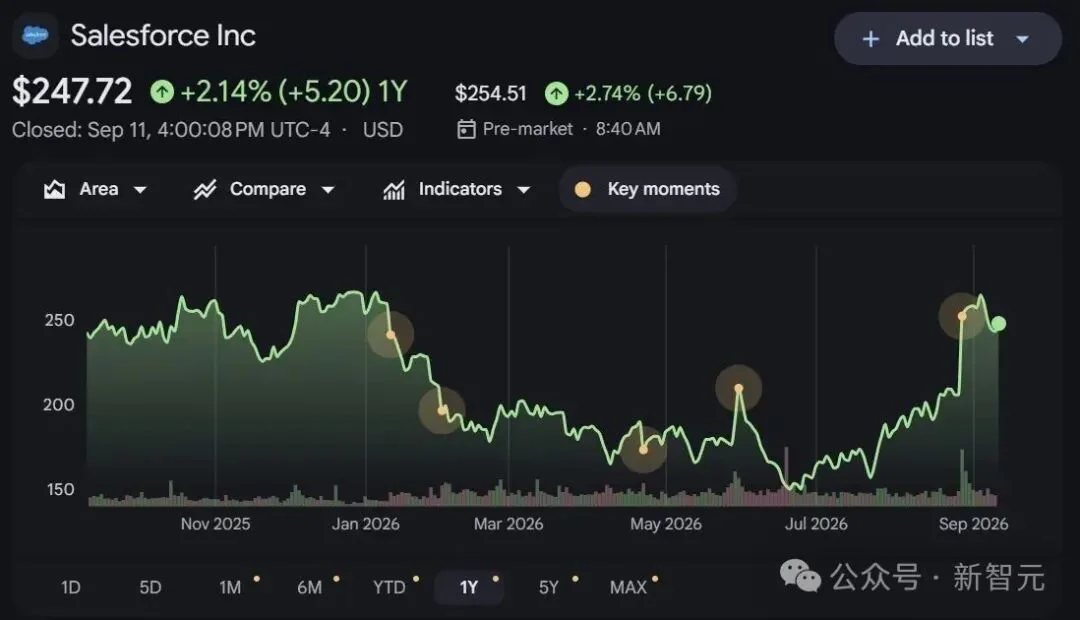
飞书豆包合体,Agent最强工作平台来了
今年2月,Anthropic的Claude Cowork插件发布四天后,美国软件股单日蒸发2850亿美元,「SaaSpocalypse」刷屏,市场一度认为Agent将取代协同平台。但仅半年后剧情反转:8月27日,Salesforce靠Agentforce单日暴涨22.6%,ARR突破15亿美元。原因在于,Agent要干活,必须跑在客户数据和业务流程之上。真正的问题不是Agent是否取代平台,而是人...
2026-09-17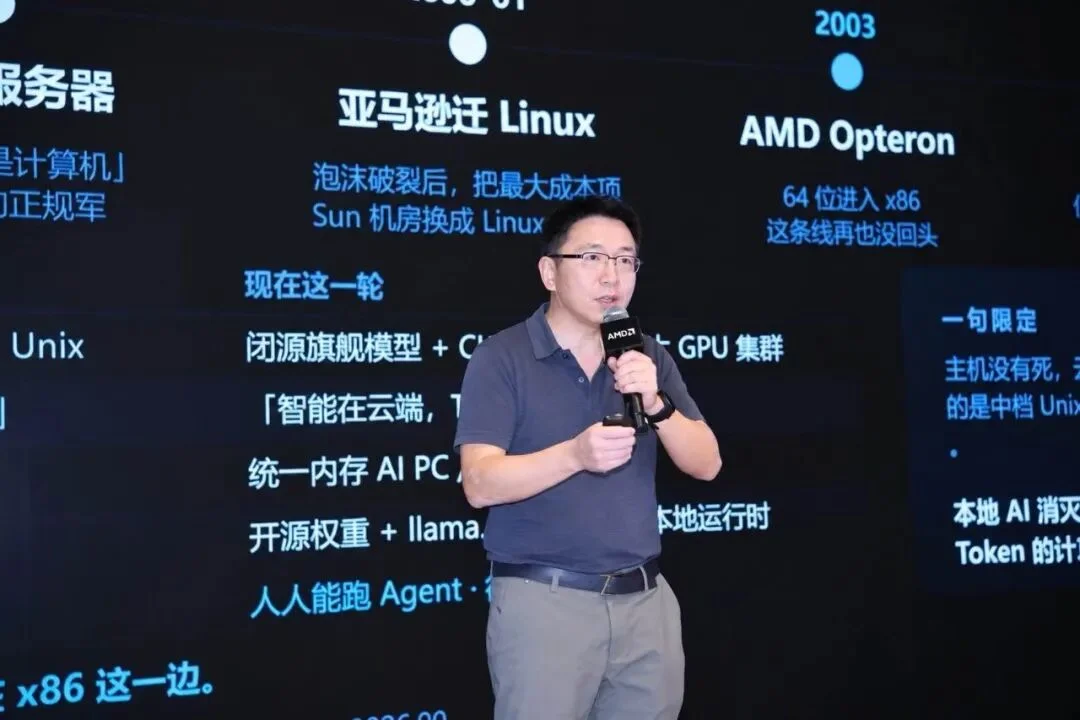
AMD发新处理器,蒋涛称大模型进入PC服务器时代
9月10日,AMD在北京举办“携手创新 共赢智能体AI时代”媒体沙龙,发布锐龙AI Max PRO 400系列处理器,将客户端统一内存上限提升至192GB,可本地运行3000亿参数级大模型。CSDN创始人蒋涛发表《大模型的PC服务器时代》演讲。 蒋涛类比二十多年前x86服务器颠覆专有Unix服务器的历史,提出AI正在复刻服务器产业变迁:统一内存AI PC与工作站正开启大模型的PC服务器时代,“开...
2026-09-17
ChatGPT Pro会员Codex额度一天烧光?三个号轮着用也扛不住
最近我的Codex额度已经烧到有点用不起的程度。我做了一个AI热点资讯产品AIHOT,最近的工作基本围绕底层优化:压模型API成本、压抓取成本、用算法替代模型、找过度设计和性能瓶颈。月活突破100万后,流量和请求费用已到扛不住的地步,只能疯狂压缩流量传输,把边缘缓存用到极致。为做热度榜,监控信源加到近2000个,每天大模型API费用几百块。一天一个200美元的Pro会员号几乎成了日抛,3个号轮着用...
2026-09-17
字节分拆AI制药公司拿下20亿融资,刷新国内纪录
AI制药公司Anew Labs已完成首轮独立融资,总额2.9亿美元(约合人民币20亿元),刷新今年国内AI制药单轮融资纪录。投资方包括红杉中国、IDG资本、高瓴创投、五源资本、高榕创投、春华创投等头部机构,以及多家国内医药产业集团作为战略投资方。 Anew Labs是字节跳动分拆出的AI制药主体,今年6月正式完成业务剥离,走向独立运营。其海外主体Anew Therapeutics于2023年在新...
2026-09-17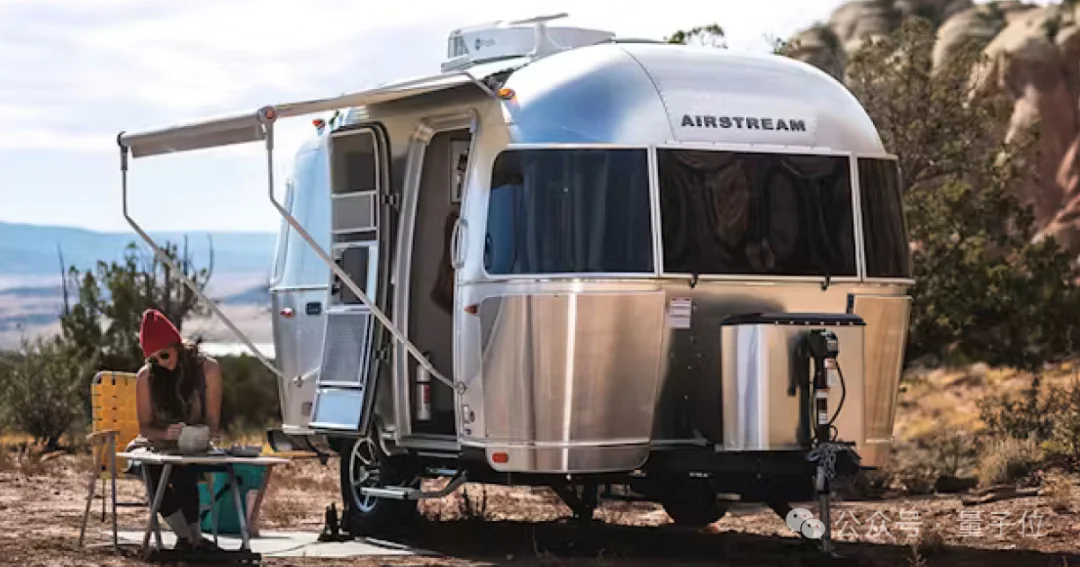
马斯克住进拖挂房车 亲自监工AI数据中心建设
马斯克最新居所曝光:一辆位于美国孟菲斯的Airstream拖挂房车。他再次住进工地,为监工AI数据中心。已并入SpaceX的xAI正加紧扩大超级计算中心Colossus,该数据中心已让SpaceX从谷歌和Anthropic手中拿到价值数十亿美元的外部合同,为SpaceX的万亿上市添了一把火。SpaceX总裁肖特韦尔称,马斯克确实会睡在工厂地板上,现在就在孟菲斯帮忙盖楼。在房车上,马斯克再次暗示特斯...
2026-09-17