3.4B参数OCR模型发布:低成本GPU上实现2.57页/秒
我们正式发布 Jina-OCR-v1,一个总参数 3.4B、解码时每 Token 仅激活 570M 的紧凑型端到端文档解析模型。在 OmniDocBench v1.6(91.14)与 olmOCR-Bench(83.4)两大基准上,它均刷新同级别最佳成绩;在 14 款主流端到端系统吞吐实测中,以 2.57 页/秒领跑。在单张 NVIDIA L4 上,通过专门设计的推测解码草稿头,生成速度几乎翻倍,且输出序列与标准自回归解码严格一致,完全无损。
模型延续 DeepSeek-OCR 的紧凑视觉编码与 MoE 解码路线,重点做两处改动:FastMTP 用单个共享 dense block 递归前向 K=3 步生成候选 token,草稿参数量与前瞻深度解耦,不再随 lookahead 增长;Dense Verifiable Rewards(GRPO)中每项奖励由确定性代码对照参考真值计算,并按部分正确程度分级给分,而非简单 0/1 判定。仅靠后训练改进,模型在 olmOCR-Bench 上就涨了 7.4 分,OmniDocBench 各细分维度也全面提升。
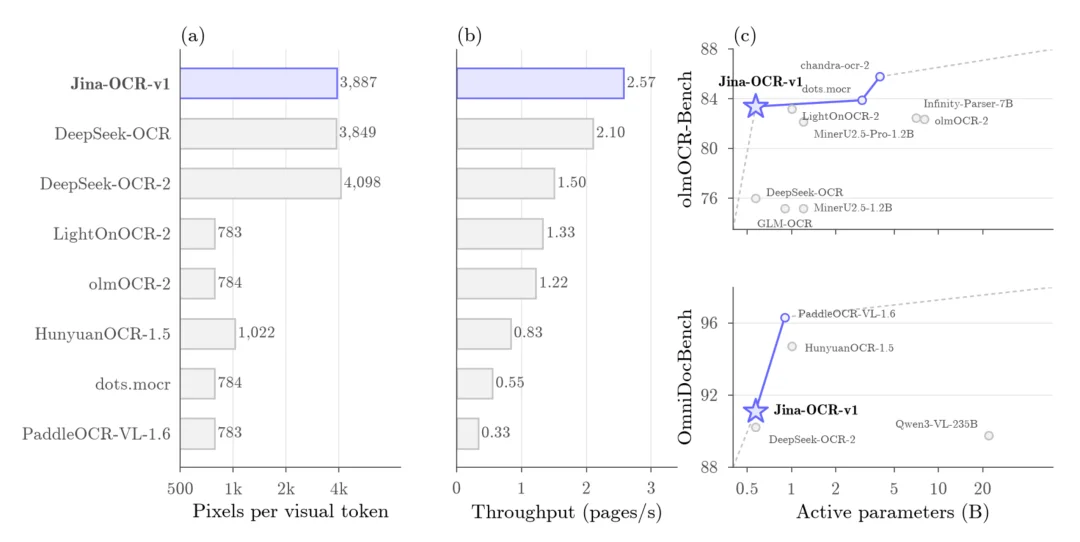
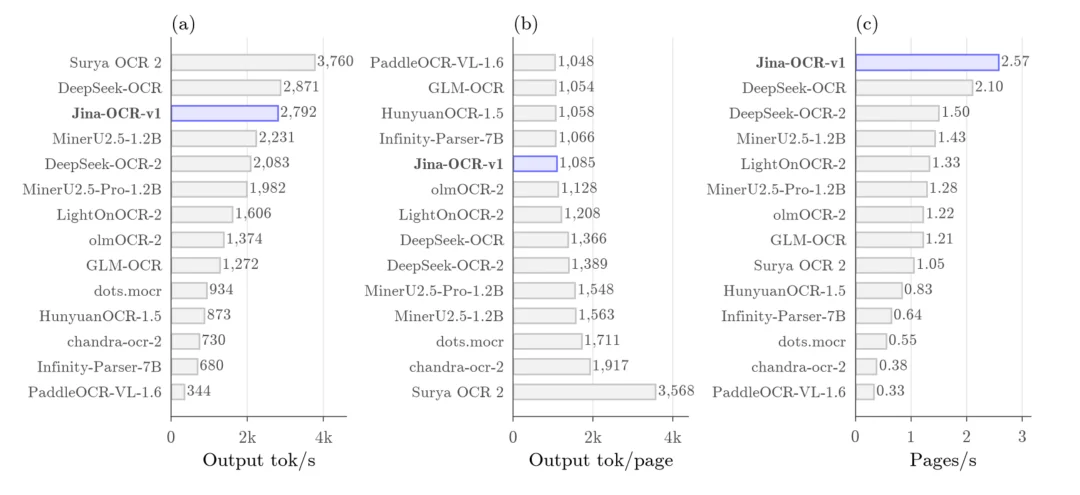
DeepEncoder 将 1024×1024 画面从 4,096 个 Patch 压缩至 256 个 Token,平均单 Token 承载 3,887 像素;主流编码器单 Token 仅覆盖 783~1,022 像素。前置压缩比越高,多模态 Prefill 阶段计算与自回归期间视觉上下文占用的 KV Cache 就越低。在单张 A100、并发 32 下,Surya OCR 2 每秒输出 3,760 token,但单页需 3,568 token,实际吞吐仅 1.05 页/秒;jina-ocr-v1 输出 1,085 tokens/页,配合 2,792 tokens/s 生成速度,端到端吞吐达 2.57 页/秒。
文档解析生产中最烧钱的环节是长序列逐 token 生成。DeepSeek-OCR 已用高压缩视觉编码器配紧凑 MoE 解码器砍掉前置开销,jina-ocr-v1 继承该底座,将优化重点对准自回归生成瓶颈。架构上,单页先生成 1024x1024 全局视图(压缩为 256 个视觉 token),再切出 n 个局部 tile(每个 tile 100 个 token)。FastMTP 头通过单个共享稠密块递归前向,一次提出 K=3 个候选 token 交主解码器验证。文档 OCR 排版局部结构高度确定,天生适合推测解码。传统多 token 预测每多看一步就要多挂一个独立 draft head,前瞻越远参数越膨胀;FastMTP 只用一个共享 dense block,靠 hidden state 反馈递归执行 K=3 步前向预测,参数量与 lookahead 解耦,因此推测解码产出与主模型直接自回归贪心生成完全一样,只提速不降质。
输出格式统一为 Markdown,表格用 HTML 结构,公式用 LaTeX 语法。预训练语料混合主流公开 OCR 数据集(olmOCR-mix、FinePDFs、LightOnOCR、MMTab、UniMER 等),并补充 Europeana 历史报纸、美国国会图书馆缩微文献和 NARA 档案等高难度真实排版源。清洗时先用规则过滤死循环与重复退化内容,再用高精度视觉大模型做单次前向重打标。引入合成数据 JinaOCRSynth 是因为真实文档复杂公式和深层表格分布太稀疏,RL 阶段自然页面 rollout 绝大多数样本碰不到几个结构奖励项,梯度停滞;JinaOCRSynth 在合成页面中高密度塞入结构化表格和公式,并自带单元测试断言,提供充足信号。
后训练由 SFT、长尾劣化页面鲁棒性微调及 GRPO 强化学习交替迭代。GRPO 奖励函数由多个确定性可验证项相乘得出,任何一项零分则整页梯度清零;对文本、公式、表格等检查项设置底线分,允许局部扰动;唯独重复惩罚不设下限,防止自回归模型靠死循环复读投机刷高局部文本重合度。每轮迭代产生候选检查点,用自动化 agent 在固定评测预算下搜索最佳 checkpoint merge 配比,优胜模型错误案例驱动下一轮数据采集。FastMTP 草稿头放在训练循环最后,在最终定型验证器上拟合。
olmOCR-Bench 上,jina-ocr-v1 得 83.4 分,比基座 DeepSeek-OCR 高 7.4 分,也超过 8B 规模的 olmOCR-2。该基准 Hdr/Ftr 列偏向剔除边角杂质,越主动省略页眉页脚得分越高,整页转录系统反而扣分。OmniDocBench v1.6 中,jina-ocr-v1 以 570M 激活参数得 91.14 分,全面领先 DeepSeek-OCR-2,也超过参数大得多的 Qwen3-VL-235B。
L4 推测解码实测环境为 olmOCR-Bench、单卡 NVIDIA L4、vLLM 0.20.1、并发 batch size=1。τ 为单次推测平均接受 token 数(含验证带出的 bonus token
更多推荐阅读
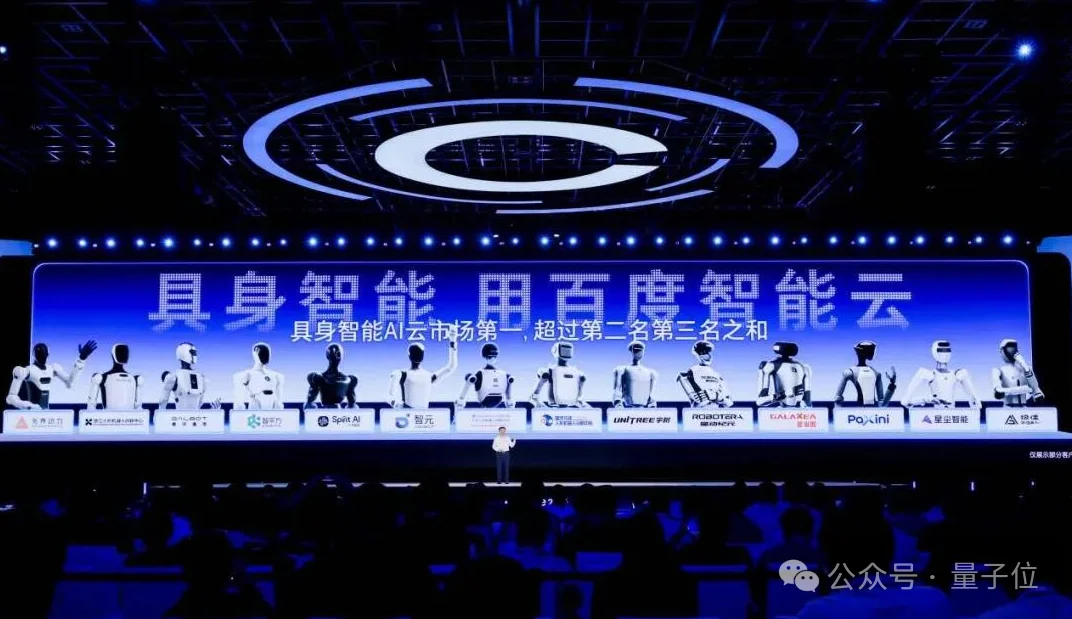
机器人量产了,具身智能为何反而更难了?
机器人本体批量落地,行业要补的课反而更多了。本体数量上来了,具身智能看似离规模化越来越近,但理解世界、学习新任务、持续进化的能力,还无法随机器人一起批量复制。行业关注重点正从如何造出机器人,转向如何持续生产和迭代机器人的能力。 9月16日,在2026智能经济论坛上,百度集团执行副总裁沈抖判断:智能体能力边界快速打开,已能处理更长程任务并进入规模化部署。类比AI时代,今天可能只是灯泡发明后的第一个...
2026-09-18
50万份文档喂给AI,WPS如何闯入造船厂一线?
企业AI下半场,拼的是数据和上下文。 一家船厂手里压着近50万份研发制造文档;一名船舶设计师从新手成长为专家,往往需要十年以上。2026年下半年,腾讯WorkBuddy、阿里千问办公、字节豆包工作几乎同时把企业级Agent推到台前,加上金山办公,国内AI办公“四强”格局基本成形。但企业级Agent的卡点不是模型不够聪明,而是能否读懂海量图纸、规范和老师傅脑中未写下的判断标准。 金山办公带着WP...
2026-09-18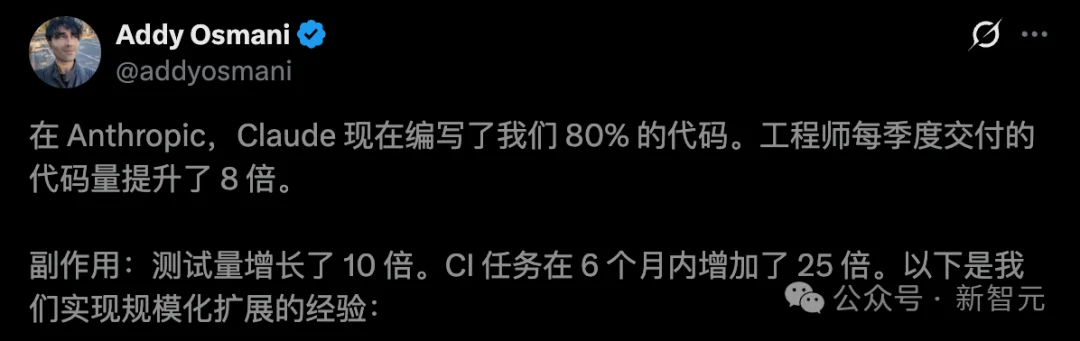
Claude狂写80%代码,Anthropic的CI半年被撑爆25倍
Anthropic披露内部数据:全公司80%的代码由Claude编写,工程师人均每季度交付代码量达2021—2025年平均水平的8倍。Claude还承担大量PR审查与合并批准工作。写代码、审代码不再是瓶颈,但CI系统在半年内被压垮:测试用例激增10倍,CI任务量暴涨25倍。 根本原因在于AI与人类研发行为模式的差异。人类提交PR数量有限、倾向打包改动,且需要休息,CI有低谷期消化任务。而Clau...
2026-09-18
字节AI教育出海记:豆包爱学如何让孩子少走弯路
过去两年,AI落地场景中,教育是增长最快、渗透超预期的赛道之一。字节跳动的Gauth自2020年推出以来,下载量超2亿次,成为现象级AI教育产品。字节随后将这套AI辅导能力带回国内,做成“豆包爱学”,更贴近国内学生的学习内容和使用习惯,现已更新到2.0。7月初,该产品与唐国强合作推出《出师表》系列互动课;在Seedance 2.5发布时,豆包爱学也被作为官方典型落地案例展示。 豆包爱学独立APP...
2026-09-18
智谱AI智能体两周让10万卡集群吞吐暴涨200%
RSI的最小闭环已经出现。智谱创始人兼首席科学家唐杰在X平台发表长文,首次曝出智谱在递归自我改进(RSI)领域的最新成果:在超过10万卡国产芯片组成的集群上,由GLM-5.3驱动的Infra Agent参与搭建了支撑GLM-5.3 Flash研发的生产级推理服务,仅用不到两周就完成从模型适配到生产可用的进化,将端到端吞吐提升至初始基线的3倍。唐杰认为,虽然距离递归式自我改进还很遥远,但最小闭环已经...
2026-09-18
红杉领投Mecka AI,估值5亿美元
据两位知情人士透露,专注于收集和分析人体运动数据以训练人形机器人及其他机器人的初创公司Mecka AI,即将完成由红杉资本领投的新一轮融资,估值约为5亿美元。此次融资距离上一轮仅过去三个月,此前该公司宣布完成由Framework Ventures领投的6000万美元融资,参投方包括Menlo Ventures、SV Angel和Kindred Ventures。 Mecka AI由四位联合创始人...
2026-09-18