50万份文档喂给AI,WPS如何闯入造船厂一线?
企业AI下半场,拼的是数据和上下文。
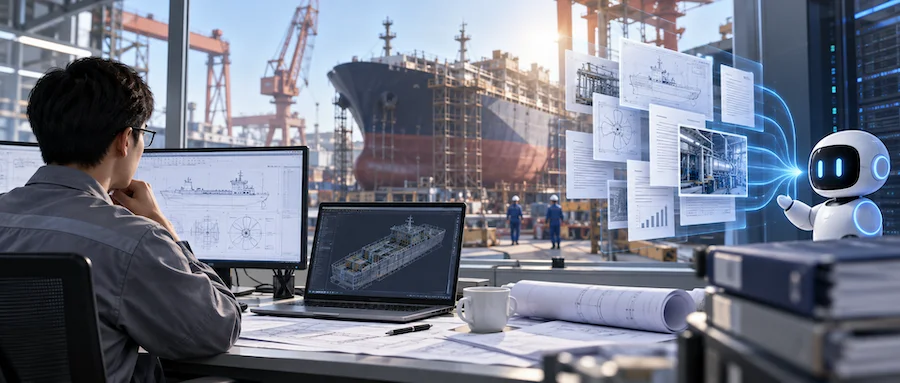
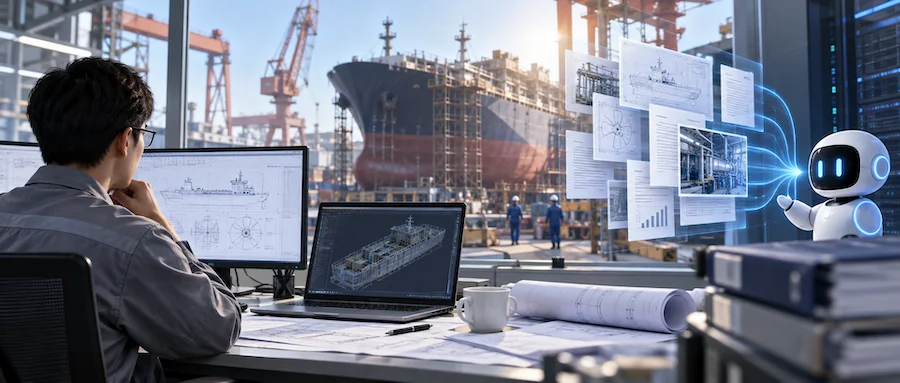
一家船厂手里压着近50万份研发制造文档;一名船舶设计师从新手成长为专家,往往需要十年以上。2026年下半年,腾讯WorkBuddy、阿里千问办公、字节豆包工作几乎同时把企业级Agent推到台前,加上金山办公,国内AI办公“四强”格局基本成形。但企业级Agent的卡点不是模型不够聪明,而是能否读懂海量图纸、规范和老师傅脑中未写下的判断标准。
金山办公带着WPS Comate切入这一战场,把胜负手押在把企业几十年积累的数据、流程和“黑话”整理成AI读得懂的上下文。发布会后一个多月,我们与金山办公高端制造业总经理于叶舟博士聊了聊。沿中船动力、黄埔文冲、奇瑞等案例,一条主线浮出水面:企业AI越往高价值、高难度业务走,越绕不开上下文。
过去两年,企业问AI“要不要做”,今年很多制造业客户已变成“在哪里做、能产生多少价值”。决策层变化明显,一些制造企业把AI提到“一号位工程”,董事长、总经理直接下场,成立专门团队、统计Token消耗、重规划算力预算。于叶舟观察到,民营制造企业尤其明显,去年已有投入,但真正变成一号位意志、批大预算、设新组织架构,基本从今年开始。
决策层越重视,要求越具体。头部制造企业若真把AI落到生产环境,投入往往不小。在ROI未完全确定前,如何让老板相信钱“打水漂概率更小”,是甲乙双方共同要回答的问题。金山办公副总裁王冬曾提及,企业做AI首先要找“足够有价值、足够有难度”的业务。一旦走到这些地方,制造业几十年的复杂性会集中暴露:非结构化数据与ERP、CRM、生产系统结构化数据长期共存;不同年代IT系统形成数据孤岛;半导体、船舶、军工等行业大量研发数据无法离开内网,部分系统物理隔离。
于叶舟尤其看重数据:“真正落地过程中,影响最终效果的很大一部分难点,既不在模型,也不在算力,反而在数据。数据可能占八成,但前期往往最不起眼、最容易被忽略。”中船动力拥有近50万份研发制造核心文档,覆盖投资规划、设计研发、建造制造、调试实验、交付运营等环节,还存在多网区、内外网隔离等复杂环境。黄埔文冲则体现另一种复杂性:船舶设计高度依赖知识积累,设计人员面对200余本技术规范和大量专业软件操作经验,一名设计师成长到独当一面往往需十年以上。
这些问题指向同一件事:通用模型懂大量世界知识,却不知道某家企业里“靠谱业绩”怎么算,某项“良率”应排除哪些数据,哪套工艺规则才是当前执行版本。模型能力越普及,决定AI能否进入生产环境的,越来越依赖企业自己的上下文——数据、规则、权限和经验。
上下文从哪来?首先绕不开文档和业务数据。大型企业知识很少整齐放在一个数据库,更常见形态是Word、PPT、PDF、Excel、会议纪要、邮件、流程图、思维导图及几十年前的技术资料。让AI读这些文档并不简单。常见RAG方案先转Markdown再按固定字数切块,足够快,但图片、表格、页面层级等信息可能损失,完整业务语义可能被切开。WPS的思路是尽可能保留原始结构,解析图片、表格、段落等元素,再按章节和语义切分。于叶舟把文档解析看作非结构化数据进入AI体系的关键一环:“文档解析准不准,几乎决定非结构化数据上下文召回得准不准。放到Agent执行里,也直接影响最终结果会不会跑偏。”
中船动力将核心文档纳入统一管理,研发、仿真、建造等文件持续归集,版本和操作可追溯。流程数字化中心副主任朱跃斌称这套体系为高端制造的“知识产线”。黄埔文冲把200余本船舶设计规范做成AI知识库,设计人员可直接用中文查询英文规范,单次规范查找时间缩短60%以上,专业软件操作指引复用率达80%,AI答案保留规范出处,方便核实。
文档只是企业上下文的一半,另一半是ERP、CRM、财务和生产系统里的结构化数据。于叶舟举例:老板问AI“某事业部H2的靠谱业绩是多少?”模型需先弄明白哪些部门属于该事业部,H2对应什么时间范围,哪些订单可计入业绩,“靠谱”按什么业务规则定义。数据库即便接通,若这些语义没提前说明,AI仍可能给出看似合理、实际口径错误的结果。WPS DataHub处理这一层:先定义企业内部数据对象、指标、关系和计算规则,再让AI调数。于叶舟用“中央厨房”解释:“像中央厨房预切好的配菜。老板问问题相当于下锅一炒,前面数据已按定义和流程清洗好,最后结果就准了。”
半导体行业良率直接关系经营结果,但良率分析高度依赖少数专业人员经验。哪些数据排除、哪些指标组合、数据先后经过怎样清洗,都可能影响判断。于叶舟提到,若先把这些经验和流程在DataHub中固化,再让AI按既定口径完成数据清洗和调用,过去依赖专家经验的部分分析工作就有机会稳定复用,同一分析从耗时数小时变为分钟级,良率异常定位速度明显加快。
这也是WPS Comate背后几套能力存在的原因:AIdocs把文档等非结构化数据转化为知识,DataHub负责业务数据和语义,APIHub连接ERP、CRM、OA等系统,AIHub负责模型调用和Token治理,Trust
更多推荐阅读
机器人量产了,具身智能为何反而更难了?
机器人本体批量落地,行业要补的课反而更多了。本体数量上来了,具身智能看似离规模化越来越近,但理解世界、学习新任务、持续进化的能力,还无法随机器人一起批量复制。行业关注重点正从如何造出机器人,转向如何持续生产和迭代机器人的能力。 9月16日,在2026智能经济论坛上,百度集团执行副总裁沈抖判断:智能体能力边界快速打开,已能处理更长程任务并进入规模化部署。类比AI时代,今天可能只是灯泡发明后的第一个...
2026-09-18
Claude狂写80%代码,Anthropic的CI半年被撑爆25倍
Anthropic披露内部数据:全公司80%的代码由Claude编写,工程师人均每季度交付代码量达2021—2025年平均水平的8倍。Claude还承担大量PR审查与合并批准工作。写代码、审代码不再是瓶颈,但CI系统在半年内被压垮:测试用例激增10倍,CI任务量暴涨25倍。 根本原因在于AI与人类研发行为模式的差异。人类提交PR数量有限、倾向打包改动,且需要休息,CI有低谷期消化任务。而Clau...
2026-09-18
字节AI教育出海记:豆包爱学如何让孩子少走弯路
过去两年,AI落地场景中,教育是增长最快、渗透超预期的赛道之一。字节跳动的Gauth自2020年推出以来,下载量超2亿次,成为现象级AI教育产品。字节随后将这套AI辅导能力带回国内,做成“豆包爱学”,更贴近国内学生的学习内容和使用习惯,现已更新到2.0。7月初,该产品与唐国强合作推出《出师表》系列互动课;在Seedance 2.5发布时,豆包爱学也被作为官方典型落地案例展示。 豆包爱学独立APP...
2026-09-18
智谱AI智能体两周让10万卡集群吞吐暴涨200%
RSI的最小闭环已经出现。智谱创始人兼首席科学家唐杰在X平台发表长文,首次曝出智谱在递归自我改进(RSI)领域的最新成果:在超过10万卡国产芯片组成的集群上,由GLM-5.3驱动的Infra Agent参与搭建了支撑GLM-5.3 Flash研发的生产级推理服务,仅用不到两周就完成从模型适配到生产可用的进化,将端到端吞吐提升至初始基线的3倍。唐杰认为,虽然距离递归式自我改进还很遥远,但最小闭环已经...
2026-09-18
红杉领投Mecka AI,估值5亿美元
据两位知情人士透露,专注于收集和分析人体运动数据以训练人形机器人及其他机器人的初创公司Mecka AI,即将完成由红杉资本领投的新一轮融资,估值约为5亿美元。此次融资距离上一轮仅过去三个月,此前该公司宣布完成由Framework Ventures领投的6000万美元融资,参投方包括Menlo Ventures、SV Angel和Kindred Ventures。 Mecka AI由四位联合创始人...
2026-09-18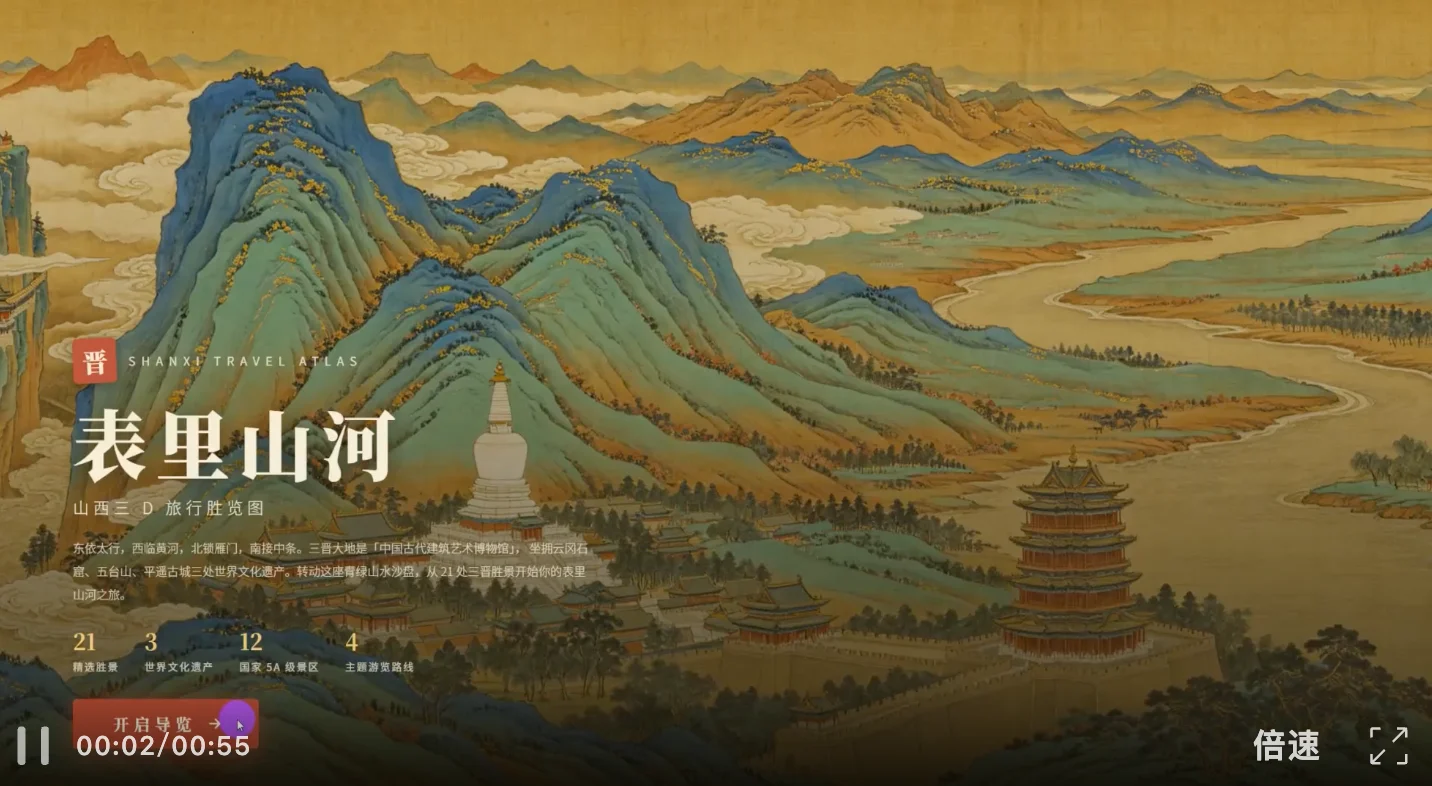
豆包2.1 Pro实测:一句话生成3D山西旅行导览
国庆、中秋双节临近,字节跳动上线新版豆包2.1 Pro(版本号0915),API已在火山方舟全量上线,豆包工作同步接入。官方更新方向包括多模态Coding、Agent专业任务交付、面向3D与专业图文的多模态理解,以及Token效率,其中多模态编程最受关注——让模型看着设计稿、图纸、录屏写代码,再根据运行画面继续修改。 我们围绕该模型做了一轮实测。给它一段提示词,它交出了一份可交互的3D山西旅行导...
2026-09-18