斯坦福教授直播训练535B大模型,模型训练背后的「黑箱」正在被打开?
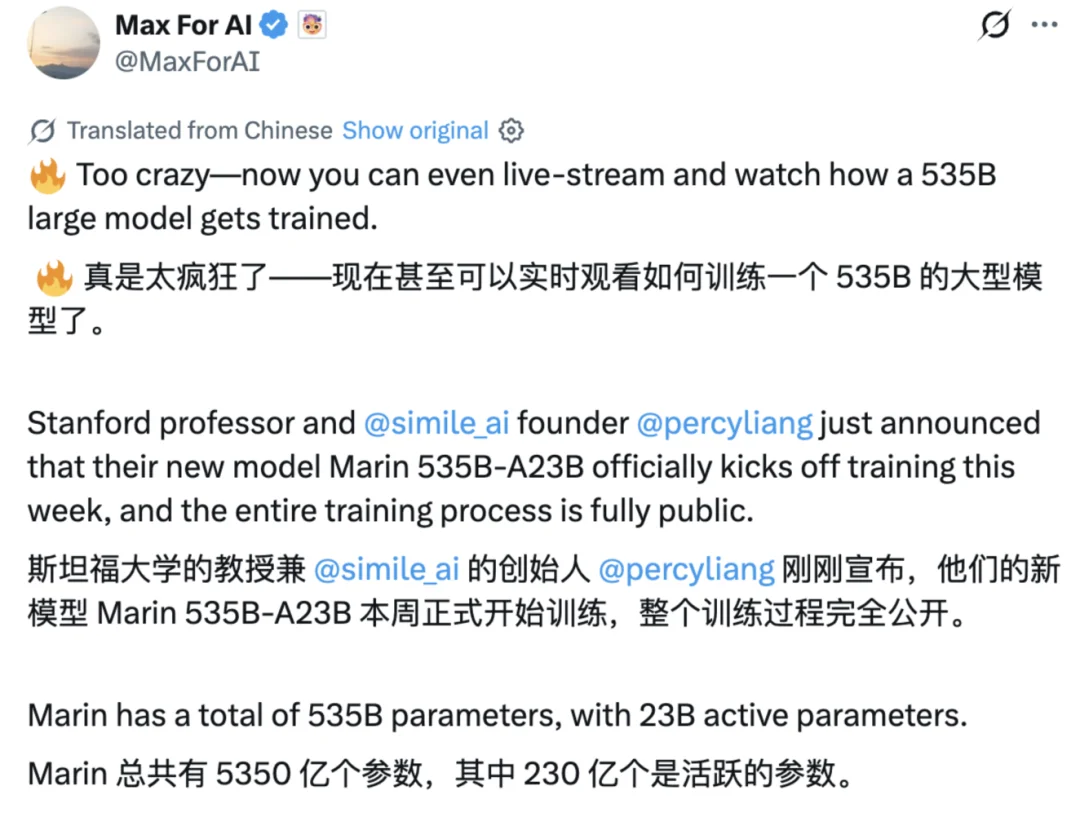
最近两天,X 上网友 Max For AI@MaxForAI 的一篇帖子引发了网友热议:「太疯狂了 ——现在你甚至可以直播围观一个 535B 大模型是如何被训练出来的。」
原来是斯坦福大学教授、Simile AI 创始人 Percy Liang@percyliang 宣布由 Marin 开放实验室启动训练 Marin 535B-A23B 模型,并且整个训练过程将全程公开进行。
Marin 拥有 5350 亿总参数、230 亿激活参数,为此,Percy Liang 和团队准备了总计 18.75 万亿 token 的训练数据,部署了 11 套 GB200 NVL72 系统,约合 792 颗 GB200 GPU。
预计模型将连续训练约 3 个月,总训练计算量约为 2.7e24 FLOPs。训练完成后,团队还将继续进行后训练(post-training)阶段。
换句话说:未来几个月,所有人都可以围观一个前沿大模型如何从零开始成长。
另外值得注意的是,Percy Liang 表示,在正式启动这次训练任务之前,团队已经先训练了一套包含 4 个阶段的 Scaling Ladder(规模扩展阶梯),从 1.6B-A61M(48B tokens) 一直到 27.7B-A1.2B(926B tokens)。
「这样做有两个目的,一是用这些小规模实验提前发现并调试潜在问题;二是根据不同规模模型的训练表现,对我们的「主模型训练」(hero run)进行预测。」
当然,Percy Liang 也表示,「这是迄今为止我们进行过规模最大的一次训练,因此,我们也确实在期待过程中出现一些意料之外的情况。」
目前,该主模型已经正式开始运行,所有人都可以直接查看实时训练曲线。后续,训练数据、实验日志以及工程问题也会持续公开。
比如数据层面,包括训练数据混合比例、数据处理方式,以及不同领域数据如何进入模型;工程层面,包括训练配置、代码以及实验设计;训练过程,包括实时 loss 变化、模型状态以及不同阶段预测结果等。
同步,Percy Liang还公开了的具体的观看渠道。
查看数据构成:https://storage.googleapis.com/marin-public/held/harrier-k40-cluster-overview/2026.08.18/index.html?revision=uniform-sampling
在 Weights & Biases(wandb)上实时观看训练过程:https://wandb.ai/marin-community/marin_moe/reports/535B-A23B-18T-Token-Hero-Run-Scaling-Ladder--VmlldzoxNzc2MDM5Ng
在 GitHub 上查看所有详细信息:https://github.com/marin-community/marin/issues/8435
详细了解之后不难看出,为什么 Percy Liang 的这一操作能够引起大家的围观。因为过去,对于 GPT-4、Claude、Gemini 这类模型来说,根本不知道背后具体是怎么训练的,像个「黑箱」一样。
大家只能看到最终模型能力、benchmark 分数、少量论文描述等。而对于数据配比、训练失败过什么、哪些超参数有效、loss 如何变化、Scaling law 是否预测准确等,都是未知的。
Marin 正试图改变这一点。或许,模型训练也可以像论文、开源软件一样:可观察、可讨论、可协作。
而自从这个消息公布以来,网友们的热情还在持续高涨。
有网友认为,这才是真正的开源精神,「即使训练过程出现问题、偏离预期,也毫不隐藏。」
有网友则表示,即便训练模型本身已经很庞大,但真正令人震撼的是,大家现在居然可以通过 WandB 平台,实时观看一个价值数十亿美元规模的大模型训练过程如何一步步成长?
「这就像顶级 AI 实验室内部原本紧闭的 “暗室” 突然被打开,所有人都能看到里面正在发生什么。」
而在接下来的三个月里,最令人期待的或许不是最终模型能力如何,而是观察这个模型在训练过程中究竟会经历多少次「爆炸」、崩溃和意外情况……
此外,有网友还认为,这一举动不仅是提供了一个观看模型训练全过程的视角,甚至给了大家一个学习、交流的平台。
网友 James Thewlis@jdthewlis 一直在实时跟进训练过程,过程中他不理解「为什么在大约第 500 step 附近,norms(参数范数)会出现一个峰值?」
之后自己搞明白之后,又在评论区自问自答:「这个峰值完全是由 router_bias(路由偏置) 导致的。它并不是通过梯度训练得到的参数,而是 MoE(混合专家模型)中用于 token 平衡机制(token balancing heuristic) 的一部分,因此它具有不同于普通模型参数的动态变化规律。」
像这样的情况还有很多。
此外,值得一提的是,Percy Liang 作为斯坦福大学教授,除了这次真刀真枪的实践,还有一门理论课程:《CS336: Language Models From Scratch》(从零构建语言模型),目标是让学生完整理解一个大型语言模型如何被构建的。
看样子,Percy Liang 是真的想教会所有人「造」大模型。感兴趣的网友可以了解一下。
课程链接:https://www.youtube.com/playlist?list=PLoROMvodv4rMqXOcazWaTUHhq-yembLCV
那么你呢?如何看待这场真正将大模型训练搬上台前的直播?欢迎在评论区留言交流!
https://x.com/MaxForAI/status/2091270116067750089
https://x.com/percyliang/status/2090918065634684997
https://x.com/CopyRebeldia/status/2091231950774112412?s=20
https://www.youtube.com/playlist?list=PLoROMvodv4rMqXOcazWaTUHhq-yembLCV
文章来自于"机器之心",作者 "机器之心编辑部"。
更多推荐阅读

被称“最无聊机器人”的Dyna,靠叠衣服找到机器人Scaling Law
《纽约邮报》曾称Dyna Robotics为“全世界最无聊的机器人”,而公司创始人认为这是“对一家机器人公司最高的赞美”。Dyna-1主攻叠毛巾、叠衣服;新发布的Dyna-2让机器人Taku进入洗衣房,完成放脏衣服、操作洗衣机、取出送烘干机、折叠放架等流程。联合创始人Jason Ma表示,机器人真正开始工作本就应是“无聊”的,真实部署是衡量机器人的“唯一评估”;机器人不能落地,不是因为没有腿或手,...
2026-10-20 09:48:01
前剪映负责人做视频Agent获千万美元融资
视频Agent赛道出现新玩家Pexo,与采用画布工作流的产品不同,Pexo将剪辑和视频整合在产品中,支持用自然语言对话创作视频。公司已获千万美元天使轮融资,此前于2025年10月获得数百万美元投资。创始人廖谦曾任生数科技产品副总裁、Vidu产品负责人,也曾在腾讯、字节跳动任职,从技术研发转向AI产品与商业化,先后从0到1搭建火山引擎智能创作云,并在剪映/CapCut发起海外AI内容平台Pippit...
2026-10-20 09:26:14
DeepSeek搜索卷起来后,前负责人创业做全网捞人
近日,DeepSeek开放了自研网页搜索接口,披露该引擎每天处理全球数亿次请求,已收录千亿级网页,正将搜索能力开放给更多开发者。 在搜索对象中,人物信息最为特殊,难点在于把零散线索拼到同一个人身上。Simplex AI创始人张博曾任DeepSeek-VL项目负责人,其团队推出的Lev8主要面向GTM,人物搜索是流程起点。用户用自然语言描述目标,系统即寻找符合条件的对象,结合公开资料判断匹配度,生...
2026-10-20 08:09:15
蚂蚁领投!清华系AI创企熵简科技完成C轮融资
智东西10月19日消息,北京AI金融创企熵简科技宣布完成C轮融资,由蚂蚁集团领投,东方国信与乔贝资本跟投。融资后,蚂蚁集团将与熵简科技在AI金融智能体研发、AI金融垂域模型训练等领域展开深度合作。 熵简科技成立于2017年,主要依托大数据、云计算、人工智能等技术,打造全资产、全流程的端到端智能资产管理平台。公司名称源自热力学第二定律中度量系统混沌程度的“熵”,“熵简”寓意通过AI降低金融投研的复...
2026-10-20 09:26:26
Anthropic预言奇点已至:2030年美国GDP或飙至44万亿美元
在曼谷举行的国际货币基金组织佩尔·雅各布森讲座上,Anthropic联合创始人Jack Clark提出判断称“奇点已经到来”,即技术进步速度已甩开人类理解和跟进的能力。他预测,在奇点驱动下,到2030年美国GDP将升至44万亿美元。按常规推演,该数字为33.5万亿美元,奇点带来15.4%的额外GDP,平均每年约6%的GDP增长;到2030年前后,累积生产率提升与资本积累将把美国年化经济增长率推高至...
2026-10-20 08:36:21
港科大CMU联手开源新模型:KV Cache砍掉99%,单卡吞吐飙6倍
谷歌一篇论文提到KV Cache至少能压缩6倍,曾引发美光等存储芯片巨头股价下跌。几个月后,岩山科技旗下岩芯矩阵联合港科大、CMU等高校发布并开源EdgeRock-4B,对KV Cache的处理更进一步:上下文从4K扩展到256K,KV Cache占用始终固定在72MiB,相比源模型减少99.1%。一张80GB显卡可同时跑512路长推理,输出吞吐达12124 tokens/s,是源模型的6.42倍...
2026-10-20 23:25:26