AI时代,熬夜写50页文档正在贬值
不管你愿不愿意,你熬夜写的那份50页文档,正在急速贬值。这不是你的锅,只怪现在的AI太能干——几分钟就能吐出一份字数相当、同样工整、几乎挑不出毛病的替代品。所有打工人都撞上这样一个残酷现实:在今天,能写出长文档,已经证明不了你认真思考过。
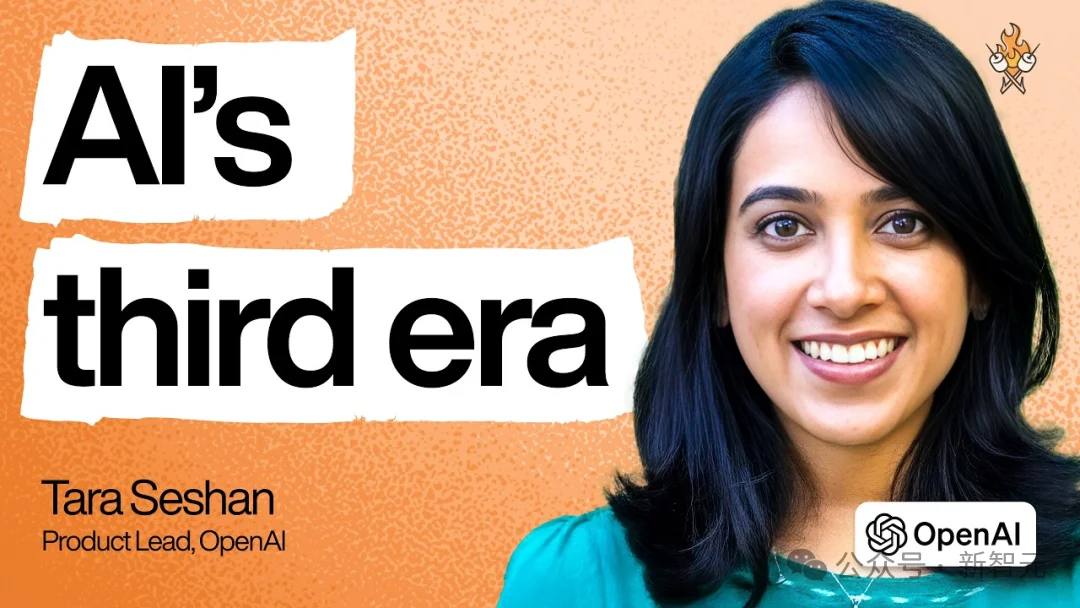
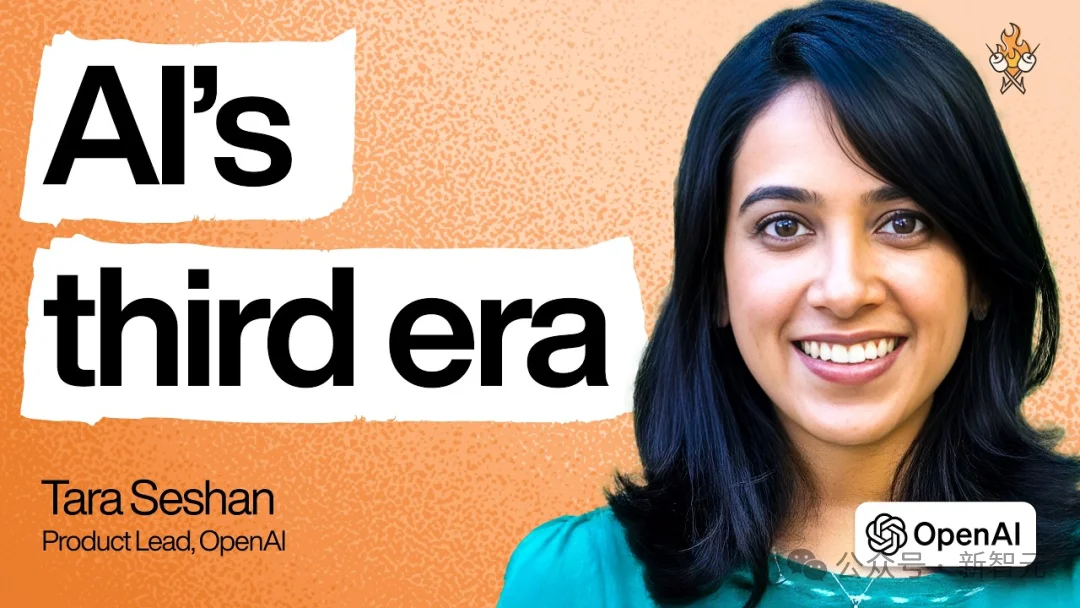
说这话的,是OpenAI Codex与ChatGPT Work的产品负责人Tara Seshan。在Lenny's Podcast上长达81分钟的访谈中,她还抛出了一句更狠的断言:为当下的模型做产品,会失败;为你以为的一年后的模型做产品,同样会失败。
当每个人手里都拿着顶级工具,当AI正在演变为「持久在线的Agent同事」,打工人的护城河究竟在哪里?Tara所分享的,OpenAI内部跑通的这套逻辑,值得每一个不想被淘汰的打工人认真读。
Tara将AI产品的演进分为了三个阶段:对话(Chat)、协作者(Co-pilot)、持久AI同事(Agent)。人与AI的分工边界,正在以肉眼可见的速度向上移。用Tara的话说:Agent负责划船,人类负责掌舵。当划船的活被AI拿走,人类剩下的核心价值,只剩下5件事:定方向、对结果负责、判断质量、注入立场与表达、协作关怀与激励团队。
为什么说「立足当下」或「押注一年后」都是死路一条?贴着当下做,模型的进化速度太快,你为绕开今天模型的短板设计的复杂机制,明天就成了「阑尾」;押注一年后,等于在盲测,把身家性命建立在一堆极大概率落空的假设上。科技圈有句黑话:「你今天用到的模型,是它这辈子最笨的一天。」Tara指出,所有人嘴上认同,但干活时还是不自觉地照着眼前这个「最笨」的模型水平在排期。为了打破这种惯性,OpenAI内部砍掉了僵化的「一年期路线图」,把规划尺子缩短到两三个月,产品必须贴着研究团队的真实进度走,保持极高频沟通,对齐模型接下来会在哪几项能力上变强、何时到位,再敏捷迭代。
Tara曾来自极看重写作文化的Stripe,过去习惯把brief打磨得毫无瑕疵再发。但在OpenAI,她彻底改变了习惯:长文档只写给自己看。因为「完整材料」不再代表「深刻思考」,长文档作为智力凭证的价值已经归零。现在,能直接跑通的原型、A/B测试数据和用户反馈,彻底取代了虚高的大篇幅文档。但她保留了一个高明的工作法则:方案写到七成,就拿去找需要授权的人,剩下三成让他们和你一起补完。理由很现实:一份毫无瑕疵的完美方案摆在面前,别人的想法只会从上面弹开;唯有留着「毛边」,对方才愿意伸手跟你一同打磨。
Tara将写作划分为两类:汇报型写作(周报、总结、摘要、格式转换)统统交给AI;思考型写作(立项逻辑、路线选择、争议判断)绝不外包给AI。因为列提纲、推敲成文、反复修改这一整套动作,本身就是你把想法理顺的过程。交给AI写,文字是有了,但「想清楚」这一步在你脑子里压根没发生。为防止大脑退化,她给自己下了两条硬性纪律:一份文档要发给多少人读,自己就得先读多少遍;一场会要占掉大家多少时间,准备的时间就得凑够这个总和。
当设计、分析、代码、原型的门槛被AI降到极低,过去需要一个团队完成的事,现在一个人就能大致跑通。人和人之间的差距靠什么拉开?「野心(Ambition)」。真正的高级玩家,绝不只是用AI去自动化重复劳动,而是用它把自己的能力边界无限撑大。这也彻底颠覆了产品经理(以及所有知识工作者)的职责:过去功夫花在排期、写文档、评审这些外围仪式上;现在,找出决定成败的关键问题,做最尖锐的假设,以极速去验证它,最重要的是,去把团队的野心往上抬。当别人提出一个方案时,你的价值在于追问:「天花板是不是还能更高?速度能不能快10倍?」
OpenAI内部有三句黑话,正好对应三次自检:一句是这事还能不能再快;一句问野心够不够,目标还能不能再往上抬;第三句最狠:你自己是不是每天睁眼就在用这个产品,是不是已经离不开它了,是不是把全部的品味,都压在了它到底好不好用这个判断上。
Lenny问她,过去三到六个月,Twitter上的风向明显从Claude Code转向了Codex,内部到底改了什么。Tara的回答是:什么都没改。团队一直在高强度自用,一直在收反馈快速迭代,工作方式从头到尾没变过。唯一的变化,只是外面的人开始注意到了。
写代码是结果导向的:Agent改完代码,跑一遍测试,过就是过,没过就是没过。但知识工作完全不同。一份最终PPT上写着「成功率90%」,你不可能只看数字就选择相信。你必须看它的原始输入是什么、中间推理是怎么一步步推过来的。这也是为什么ChatGPT Work的核心设计不是直接递交一个「漂亮成品」,而是把引用、输入和干到一半的活全摊开,让你一路掌控全局。
工具人人都有,底层能力正在被快速拉平。在AI接管「划船」的时代,真正决定你价值的,只剩下一件事——你到底有没有掌舵的本事?你想把这条船,开去哪里?
更多推荐阅读

黄仁勋放话断供不负责任AI客户,算力治理争论升温
10月14日,英伟达CEO黄仁勋接受彭博社采访时被问及,若有客户不负责任地开发AI,英伟达是否会停止供货。他回答:“这是一个假设,但答案是‘会的’。”让算力供应方充当AI治理关口,研究界已讨论多年。2023年,研究者Janet Egan和Lennart Heim提出算力提供方可参照金融业“了解你的客户”规则,核实大规模算力用户身份和用途,保存记录并上报可疑情况。英伟达占AI训练芯片市场约九成份额,...
2026-10-21 08:20:29
具身智能新玩家YITA伊塔动力融资破亿
ZP独家获悉,具身智能操作平台与动力系统公司「YITA Dynamics伊塔动力」宣布完成超亿元种子和种子+轮融资,由经纬创投、商汤国香资本、建银国际、L2F光源创业者基金、银河通用、傅利叶智能联合投资,光源资本担任孵化方和独家财务顾问。 YITA取自希腊字母Eta(η),在新一代强化学习与数据驱动控制范式中代表学习率,在动力、传动与能源系统中代表效率。公司旨在以智能学习效率和物理传动效率为核心...
2026-10-21 09:57:24
图灵奖得主同台,清华系黑马亮出物理AI王牌
10月20日,首届2026物理AI与世界模型大会在南京国际博览中心开幕。图灵奖得主杨立昆与姚期智视频连线,沈向洋、于海斌两位院士发表主旨演讲。成立仅三年、累计完成9轮融资的清华系公司千诀科技,由创始人高海川在开幕式主论坛发布面向真实物理世界的具身智能大脑底座——Polibrain预测式世界模型。其技术底牌源于千诀联合清华大学团队围绕“隐变量可辨识性”发表的公开成果,比LeCun团队同类工作早约一年...
2026-10-21 08:01:48
OpenAI急推300亿美元融资,抢在Anthropic IPO前锁定金主
OpenAI正加速推进约300亿美元融资,目标估值超1.4万亿美元,试图在竞争对手Anthropic预计11月中旬IPO前锁定投资者。软银、阿布扎比MGX及其他现有投资方正洽谈参与。 两家前沿AI实验室正争夺同一批投资者。OpenAI上周与多头基金和主权财富基金会谈,Anthropic同期举办投资者日活动。知情人士称,OpenAI希望在Anthropic财务披露前完成融资,避免被直接比较。有律师...
2026-10-21 08:53:21
DeepSeek开源自家印钞机级推理框架DeepInfer
昨天,DeepSeek 开源了支撑自家百亿级调用的云服务推理框架 DeepInfer,以及生产级分词组件 deepseek-recipe,均采用 Apache 2.0 协议。官方表示,未来新模型的推理代码和性能优化也会持续在 DeepInfer 中开源。 基于 DeepInfer,DeepSeek 单一集群服务吞吐已达每天 155 万亿 Tokens,按最低价格计算,整体收入约每卡每小时 38 ...
2026-10-21 09:59:40
拒绝上下文崇拜的AI墨水屏Flowtica再融数千万
AI 墨水屏赛道正在起势。AI 硬件品牌 Flowtica 完成数千万人民币新一轮融资,由祥峰资本领投,源码资本、五源资本及清水湾基金等老股东跟投。其 AI 墨水屏产品 Verso 已于 9 月在 IFA 宣发,并正式在海外开启定金预售,将于 12 月交付首批产品。 Verso 是一块 78 克、6.5 毫米厚的磁吸墨水屏,贴在手机背面。开会时按一下开始录音,实时转写、实时总结,结束录音时自动生...
2026-10-21 08:02:57