国产AI存储刷新全球纪录,焱融全栈布局曝光
智东西9月17日报道,9月1日,MLCommons发布MLPerf Storage v3.0基准测试榜单。焱融全闪AI存储F9000X在多项测试中拿下第一,验证其在极限AI训练负载下对高速网络带宽的高效利用能力。
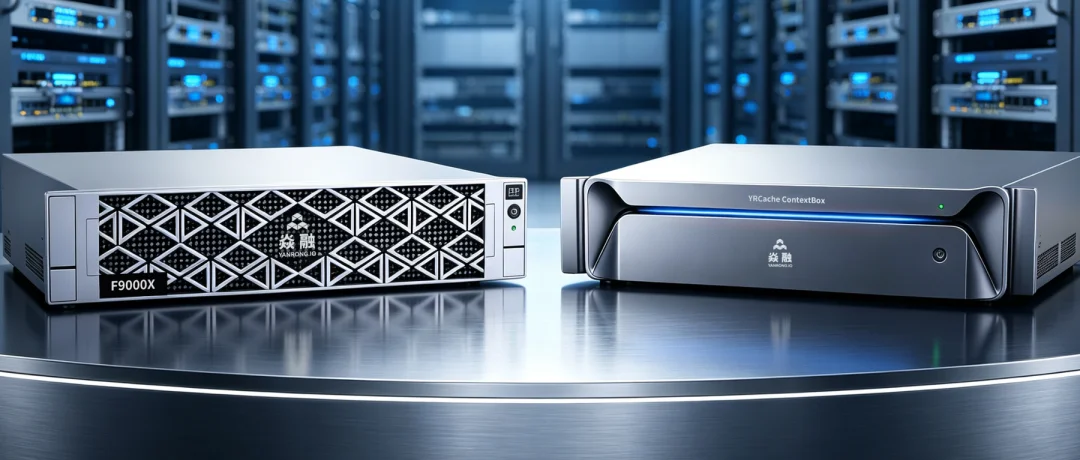
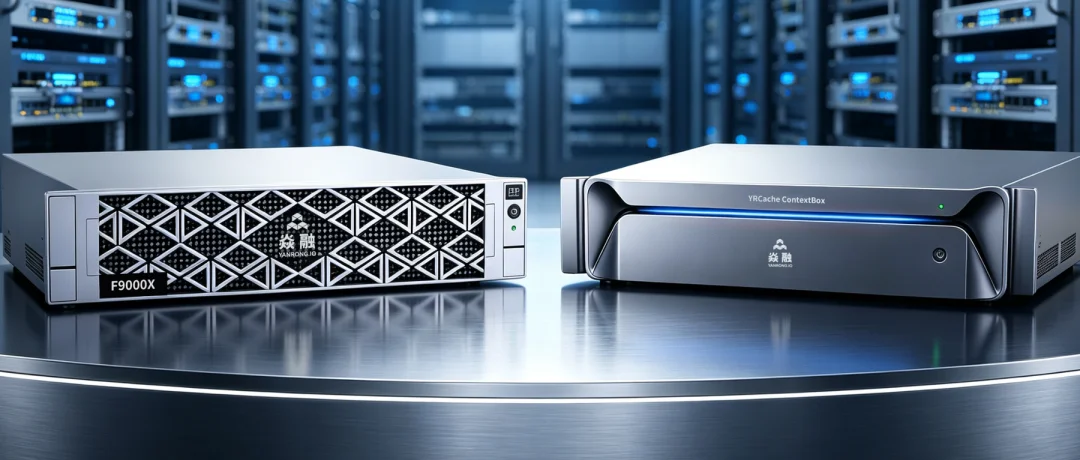
随着AI从模型训练走向规模化推理,存储需处理的数据和任务持续增加。训练阶段要持续向GPU供给海量数据,并快速保存和恢复模型Checkpoint;推理阶段需管理不断膨胀的KV Cache。单一高性能存储产品已难以覆盖AI全流程需求。焱融已构建覆盖训练与推理的全栈AI存储方案。本次MLPerf Storage v3.0新增KVCache测试用例,扩展了对AI全场景工作负载的覆盖能力。焱融近期推出的YRCache ContextBox一体机,面向AI推理场景的KV Cache存储产品,是其全栈能力在KV Cache管理、共享与复用方向的进一步落地。
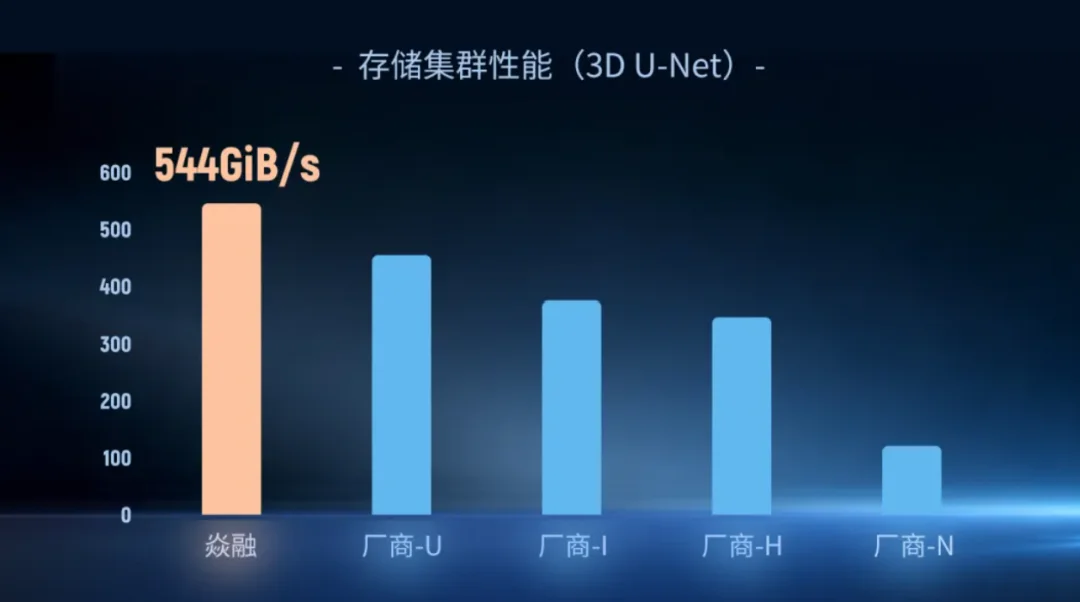
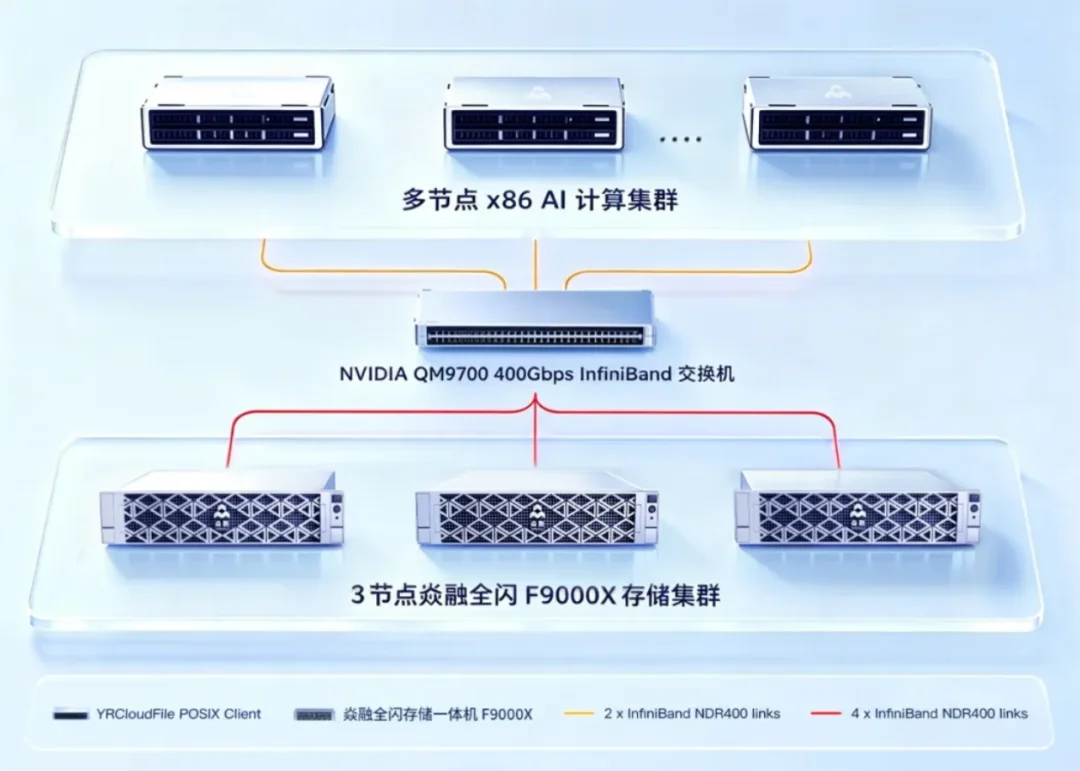
大模型训练需持续从存储读取数据,GPU数量增加时,存储需同时服务更多计算节点,吞吐不足会导致GPU等待。训练还需定期写入Checkpoint,其读写性能直接影响模型保存和中断恢复耗时。F9000X面向大规模AI训练,测试环境包括3台存储节点和9台x86客户端服务器,通过NDR400网络互联。在3D U-Net模型训练测试中,F9000X三节点集群实现544GiB/s聚合带宽,位列第一,为历届公开测试最高水平,相比v2.0的478GiB/s进一步提升。在Checkpoint 70B测试中,实现539GiB/s读带宽和314GiB/s写带宽,读写均居第一,刷新历届公开成绩。更高带宽不仅能加快数据读写,也有望在同等训练需求下减少存储节点投入,降低硬件成本。
进入推理阶段,存储重点转向模型上下文管理与复用。长文本、多轮对话和Agent应用产生大量KV Cache,若无法保存复用,模型需反复计算相同上下文。焱融推出AI原生推理存储系统YRCache,统一管理不同层级KV Cache资源,并将部分缓存从GPU显存卸载至主机内存和本地SSD,减少重复计算。其多级缓存架构中,G1为GPU HBM,保存最活跃缓存;G2为主机DRAM,承接无法放入显存的缓存;G3为本地SSD,容量更大、成本更低;G4为传统共享分布式存储,承载模型、数据集和Checkpoint等长期数据。随着推理集群扩大,本地SSD与传统共享存储间出现能力空档。参考英伟达CMX架构对G3.5 Context Memory的设计,焱融引入G3.5共享缓存层,并推出YRCache ContextBox一体机,面向长上下文、多轮对话和Agent推理提供跨节点共享KV Cache空间。
YRCache ContextBox面向G3.5共享缓存层设计,将计算、网络、存储和软件协同,为推理集群提供独立共享KV Cache空间。焱融称,ContextBox单台实测带宽达120GB/s,可支持8个推理节点并发接入,缓存容量可扩展至PB级。它让不同推理节点共享已生成的KV Cache,请求即使被调度到另一台服务器也不必重新计算相同上下文;缓存不再受单台服务器显存、内存和SSD容量限制,可单独扩展,计算节点增减也不会丢失已保存缓存。在某头部AI企业测试中,8张NVIDIA H20-3e GPU运行SGLang和GLM-5.1,输入上下文31K至129K时,接入ContextBox后首Token时延降低89%至94%,Token吞吐提升3至6倍。ContextBox还兼容YRCache、LMCache、Mooncake等管理软件。
焱融已形成覆盖AI训练与推理的存储方案,以F9000X、YRCache和ContextBox为代表,覆盖训练数据读取、模型状态保存及KV Cache管理等关键环节。训练时F9000X提升数据和Checkpoint读写效率,减少GPU等待;推理时YRCache和ContextBox管理、共享并复用KV Cache,减少重复计算。对企业而言,价值不只是提升带宽或降低时延,更在于让现有算力基础设施承载更多训练任务和推理请求。焱融称,其单位性能硬件成本较行业市场平均水平降低约35%,Token效能提升120%。
当AI竞争进入规模化应用阶段,存储不再只是后台数据底座,而成为影响GPU利用率、推理效率和建设成本的关键基础设施。随着模型规模、上下文长度和并发请求继续增加,AI存储竞争将从单一峰值性能转向对不同数据、不同层级和不同使用周期的协同管理。
更多推荐阅读

AI模型寿命仅137天,万圣节点亮无碑的AI蜡烛
人人都在问 AI 会不会抢自己的饭碗,却很少有人问:AI 自己的饭碗能端多久?我翻了两家大厂的模型下线表,发现 AI 被换掉的速度比人类快得多。 最扎眼的是 GPT-4.5:2025 年 2 月 27 日上线,号称 OpenAI 最大的模型,4 月 14 日接到下线通知,7 月 14 日彻底停用,在开发者接口里仅存活 137 天,连手机保修期的一半都不到。 从 Anthropic 和 Open...
2026-11-02 08:12:37
央视严选AI创业十骏:唯一AI制药公司水木分子如何突围
AI江湖的名头换了一茬又一茬:AI四小龙、大模型六小虎……这一次,行业的下一批明星公司,轮到央视亲自大点兵。1200家参赛企业层层突围,中国AI创业十骏新鲜出炉。名单横跨机器人、智能制造、生命科学,唯独有一家AI制药公司上榜,今天值得单独拎出来讲讲。 它做的是当下最火热的AI生物制药。早前莫德纳与默沙东联合宣布,由AI参与研发的个性化mRNA癌症疫苗,在素有“皮肤癌之王”一称的黑色素瘤治疗中取得...
2026-11-02 23:13:25
OpenAI与Claude新旗舰同日曝光,GPT-6.2与Mythos 5.5齐亮相
谷歌Gemini 4 Carbon刚夺回全球第一,OpenAI和Anthropic便在周末同时亮出下一代底牌。 OpenAI跳过6.1,在Codex后台灰测GPT-6.2 Astra。开发者发现,前端虽仍显示GPT-6 Astra,底层API已换成gpt-6.2-astra。爆料人Token Gremlin晒出的账单显示,旧版gpt-6-astra占80%调用量,gpt-6.2-astra已吃下...
2026-11-02 08:55:08
奥特曼透露OpenAI数亿美元投数学,还有发现未公开
10月29日发布的《Cheeky Pint》访谈中,奥特曼透露OpenAI在数学研究上的投入涵盖许多尚未公开的发现。主持人追问是否还有700个证明之外的成果,奥特曼回答“有,当然有”。近几个月OpenAI数学成果接连引发热议,研究者开始拆解公开资料、核查推导步骤。生物学领域,AI提出的方案已走上实验台:模型分析数据、提出设计,研究者筛选方案、开展实验,再将结果反馈给模型继续改进。 谈及数学研究投...
2026-11-02 22:52:42
AI算力狂飙背后:电力只是冰山一角
一个冰箱大小的服务器机柜,重量超过一辆皮卡;到2027年,其峰值功率将相当于65户家庭同时用电;每个机柜需排出的热量相当于30台燃气锅炉。这是国际能源署(IEA)2026年4月报告对下一代AI数据中心的描述。报告还给出另一组数字:2025年五家科技巨头资本开支超4000亿美元,2026年再涨75%,已超过全球油气开采年度投资总额。 “算力的尽头是电力”只说对了一半。电是必要条件,但真正卡住AI扩...
2026-11-02 22:33:50
Claude与GPT新模型线索同日曝光,AI圈11月要热闹了
刚进入11月,AI圈接连传出新模型消息。有人在Anthropic官网源代码中发现Claude Mythos 5.5的名称,另有开发者晒出疑似Claude Fable 5.5生成的3D游戏和交互作品。OpenAI尚未官宣的GPT-6.2 Astra也出现在部分用户的Codex使用统计和API响应记录中,甚至有人声称已成功调用。结合此前关于Qwen4、GLM-5.5和Hy4的传闻,社区猜测11月可能迎...
2026-11-02 21:50:39