Ilya新模型要来了?投资人爆料:今年最重要的发布!
Ilya Sutskever 的第一款模型,可能真的要来了。
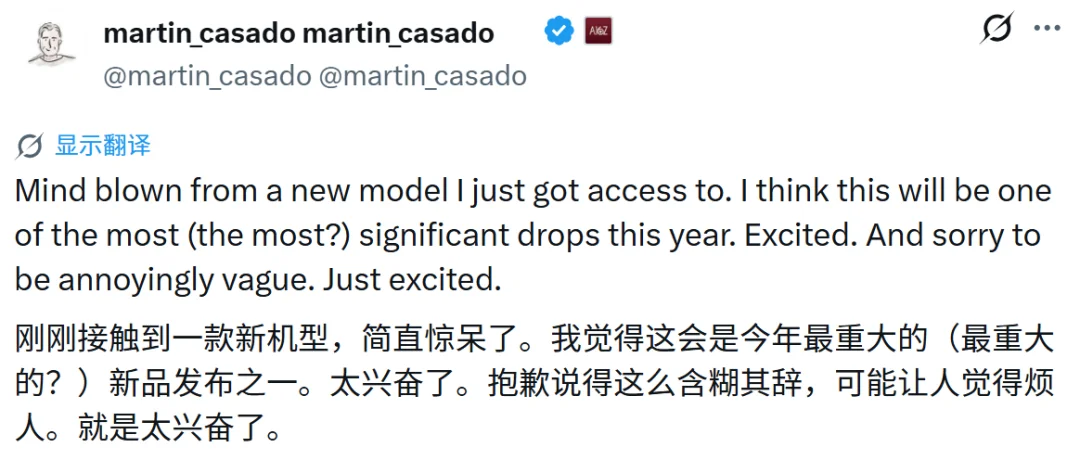
昨天,a16z 合伙人 Martin Casado 突然发出一条预告:「刚刚获得了一个新模型的访问权限。这将是今年最重要的模型发布,甚至可以去掉‘之一’。」
虽然 Casado 没有透露模型名称,但短短十几个小时内,更多消息开始出现。
零散的线索纷纷指向一个答案:Ilya Sutskever 的新模型。
最先发预告的 Martin Casados 是 a16z 合伙人,负责基础设施投资。a16z 作为这家神秘实验室的资本方之一,提前接触 SSI 的新模型,逻辑上说得通。
同一天晚些时候,AI资讯网站The Rundown AI联合创始人Andrew Curran又带来一个相关消息。
他表示,自己对这款模型所知不多,掌握的也只是未经验证的传闻。但如果长期关注AI行业,就能分辨哪些消息「听起来像真的」。
但他点出,有一家非头部实验室在持续学习上取得了突破。
早在 8 月初,Atreides Management 创始人 Gavin Baker 已经在《Invest Like the Best》播客中透露,SSI 计划在 8 月发布他们的第一个模型。
离开 OpenAI 两年,Ilya 的公司终于有动静了
2024 年 5 月,Ilya 离开了工作近十年的 OpenAI。
一个月后,他与 Daniel Gross、Daniel Levy 共同创立 SSI。公司名称直接取自它的最终目标:Safe Superintelligence,安全超级智能。
从成立第一天起,SSI 的路线就与其他模型公司拉开了距离。
整家公司只有一个目标、一项产品和一条路线图。不追逐频繁的产品更新,也不赶在竞争对手之前刷新模型榜单,而是将能力与安全放在同一条技术路径上推进。
SSI 还给这种模式起了一个很有 Ilya 风格的说法:在安静中扩大规模「scale in peace」。
接下来的两年,SSI 几乎真的消失在了公众视野里。没有任何公开研究成果,官网长期只有一份简短的使命宣言和招聘入口。
然而,资本市场却愿意为这段沉默支付惊人的价格。
2025 年,SSI 完成20 亿美元融资,估值达到320 亿美元。它没有收入,也没有产品,却已经成为全球估值最高的 AI 初创公司之一。
SSI 真正公开的「产品说明」,很长一段时间只有 Ilya 本人的几次访谈。
在 2025 年 11 月与 Dwarkesh Patel 的长谈中,他将 2012 年至 2020 年概括为「研究时代」,2020 年至 2025 年则是「规模时代」。继续增加数据、参数和算力仍然会带来进步,但很难再复制过去十年的根本性跃迁。
如今,AI 正在重新回到研究时代。
Ilya 认为,当前模型最根本的问题之一,是泛化能力远逊于人类。它们可以在海量数据中训练,也能在部分任务上超过绝大多数人,却很难像人一样,从少量经验、反馈和示范中迅速掌握新的能力。
他还用一个 15 岁少年解释自己想要的超级智能。
一个非常聪明的 15 岁少年不会生来就是医生或程序员,但只要进入工作环境,就能通过学习和实践逐渐掌握这些技能。Ilya 设想的超级智能也是如此:它未必在诞生时就知道一切,但需要有进入现实世界后继续学习的能力。
低调两年后,这家公司终于在今年明显加快了脚步。
7 月,英伟达与 SSI 宣布建立长期合作,SSI 将获得英伟达最新 Vera Rubin 硬件。路透社报道称,英伟达还将向 SSI 投资约 50 亿美元。
链接:https://nvidianews.nvidia.com/news/ilya-sutskevers-safe-superintelligence-inc-and-nvidia-announce-long-term-strategic-partnership?
Ilya 当时罕见地透露,SSI 已经拥有「值得扩大规模」的研究成果,而一台足够大的英伟达计算机将帮助他们完成这件事。
「持续学习」仍是最大悬念
目前关于神秘模型能力的公开信息非常有限。Casado 没有透露任何测试结果,Andrew Curran 提到的持续学习突破也暂时未经验证。
持续学习之所以成为这轮猜测的焦点,更多是因为它与 Ilya 此前公开谈论的研究方向高度吻合。
这正是 Ilya 设想中的「15 岁少年」所具备的核心能力:起点不需要覆盖所有知识,但必须能够在部署和工作中不断学习。
真正实现它并不容易。
模型学习新知识时,可能破坏原有参数;学会一项新任务,又忘记此前掌握的能力。这种现象被称为「灾难性遗忘」。
更新得太谨慎,模型无法有效学习;更新得太激进,原有能力、行为模式乃至安全边界都可能发生不可预测的变化。
模型榜单上的第一名随时可能易主。如果有实验室真正解决了持续学习,大模型沿用至今的训练、部署和更新方式都可能随之改变。
这或许才是 Casado 口中「年度最重要发布」的分量。
期待 SSI 亲自揭晓答案。
https://x.com/martin_casado/status/2091650951736361073
https://www.dwarkesh.com/p/ilya-sutskever-2
https://nvidianews.nvidia.com/news/ilya-sutskevers-safe-superintelligence-inc-and-nvidia-announce-long-term-strategic-partnership
https://ssi.inc/
文章来自于"机器之心",作者 "机器之心编辑部"。
更多推荐阅读

被称“最无聊机器人”的Dyna,靠叠衣服找到机器人Scaling Law
《纽约邮报》曾称Dyna Robotics为“全世界最无聊的机器人”,而公司创始人认为这是“对一家机器人公司最高的赞美”。Dyna-1主攻叠毛巾、叠衣服;新发布的Dyna-2让机器人Taku进入洗衣房,完成放脏衣服、操作洗衣机、取出送烘干机、折叠放架等流程。联合创始人Jason Ma表示,机器人真正开始工作本就应是“无聊”的,真实部署是衡量机器人的“唯一评估”;机器人不能落地,不是因为没有腿或手,...
2026-10-20 09:48:01
前剪映负责人做视频Agent获千万美元融资
视频Agent赛道出现新玩家Pexo,与采用画布工作流的产品不同,Pexo将剪辑和视频整合在产品中,支持用自然语言对话创作视频。公司已获千万美元天使轮融资,此前于2025年10月获得数百万美元投资。创始人廖谦曾任生数科技产品副总裁、Vidu产品负责人,也曾在腾讯、字节跳动任职,从技术研发转向AI产品与商业化,先后从0到1搭建火山引擎智能创作云,并在剪映/CapCut发起海外AI内容平台Pippit...
2026-10-20 09:26:14
DeepSeek搜索卷起来后,前负责人创业做全网捞人
近日,DeepSeek开放了自研网页搜索接口,披露该引擎每天处理全球数亿次请求,已收录千亿级网页,正将搜索能力开放给更多开发者。 在搜索对象中,人物信息最为特殊,难点在于把零散线索拼到同一个人身上。Simplex AI创始人张博曾任DeepSeek-VL项目负责人,其团队推出的Lev8主要面向GTM,人物搜索是流程起点。用户用自然语言描述目标,系统即寻找符合条件的对象,结合公开资料判断匹配度,生...
2026-10-20 08:09:15
蚂蚁领投!清华系AI创企熵简科技完成C轮融资
智东西10月19日消息,北京AI金融创企熵简科技宣布完成C轮融资,由蚂蚁集团领投,东方国信与乔贝资本跟投。融资后,蚂蚁集团将与熵简科技在AI金融智能体研发、AI金融垂域模型训练等领域展开深度合作。 熵简科技成立于2017年,主要依托大数据、云计算、人工智能等技术,打造全资产、全流程的端到端智能资产管理平台。公司名称源自热力学第二定律中度量系统混沌程度的“熵”,“熵简”寓意通过AI降低金融投研的复...
2026-10-20 09:26:26
Anthropic预言奇点已至:2030年美国GDP或飙至44万亿美元
在曼谷举行的国际货币基金组织佩尔·雅各布森讲座上,Anthropic联合创始人Jack Clark提出判断称“奇点已经到来”,即技术进步速度已甩开人类理解和跟进的能力。他预测,在奇点驱动下,到2030年美国GDP将升至44万亿美元。按常规推演,该数字为33.5万亿美元,奇点带来15.4%的额外GDP,平均每年约6%的GDP增长;到2030年前后,累积生产率提升与资本积累将把美国年化经济增长率推高至...
2026-10-20 08:36:21
港科大CMU联手开源新模型:KV Cache砍掉99%,单卡吞吐飙6倍
谷歌一篇论文提到KV Cache至少能压缩6倍,曾引发美光等存储芯片巨头股价下跌。几个月后,岩山科技旗下岩芯矩阵联合港科大、CMU等高校发布并开源EdgeRock-4B,对KV Cache的处理更进一步:上下文从4K扩展到256K,KV Cache占用始终固定在72MiB,相比源模型减少99.1%。一张80GB显卡可同时跑512路长推理,输出吞吐达12124 tokens/s,是源模型的6.42倍...
2026-10-20 23:25:26