四款大模型横评:同题实测七项任务,谁才是实干派?
近日大模型更新有点密,几乎每隔几天就有新版本亮相,但更新越多,用户越迷糊:到底谁更好用?打开排行榜,答案却相互打架。有人说 Qwen3.7-Max 已经力压 GPT-5.5,仅次于 Claude 系列;也有人言之凿凿地表示 GPT-5.5 已经登顶。普通人不看榜单还好,看了榜单反而更困惑——写文章该用哪个?数据分析该用哪个?写代码、审 PR、拆任务又该用哪个?
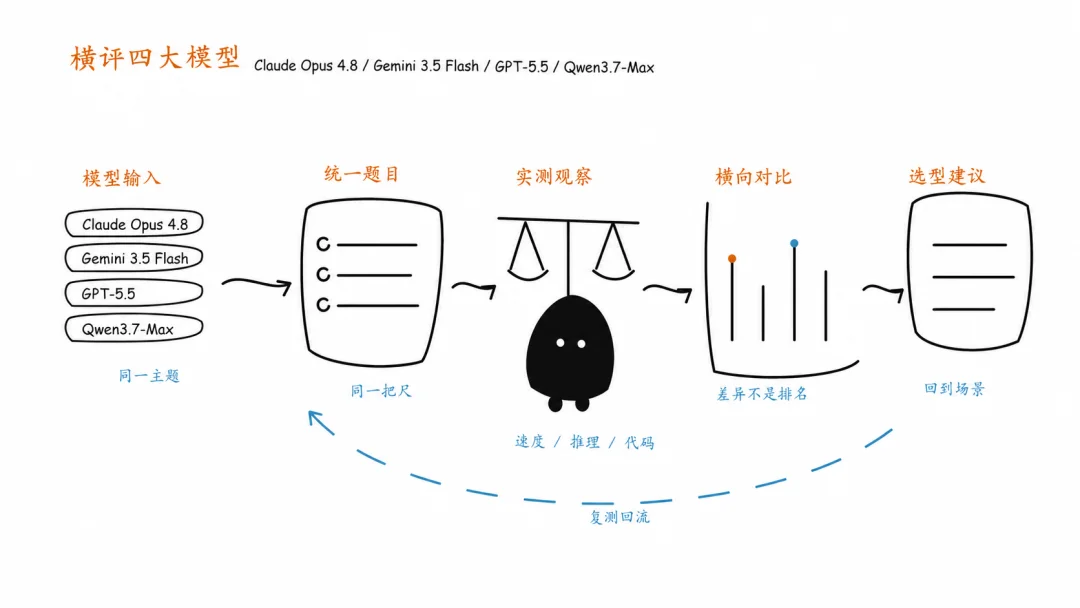
为了解开这团迷雾,我挑出四款近期讨论度极高的模型——Claude Opus 4.8、Gemini 3.5 Flash、GPT-5.5 和 Qwen3.7-Max,进行了一场横评。测评的重点不是跑分,而是真实任务里的交付表现:给同样的活儿,谁干得利索、干得准。
控制变量的测评:一份材料、一条提示词、一套标准
这场横评从一开始就设定了严格的规则。四款模型拿到的是同一份材料、同一条提示词、同一套评分标准,没有任何自由发挥的余地。换句话说,四个模型面对的是完全相同的“试卷”,任何表现差异只能来源于模型自身的能力,而不是提问方式的偏差。这样的设计让结果具有真正的可比性。
任务类型覆盖七项常见场景:长文档处理、任务规划、代码修复、中文写作、数据分析、格式遵循、SVG 生成。这七项几乎对应了办公族和开发者的日常刚需——读长报告、拆解复杂项目、修 bug、写文案、看数据、按要求排版、生成视觉元素。把四款模型丢进这七个真实战场,谁强谁弱,一测便知。
案例详解:长文档精读究竟在测什么
以其中最有代表性的“长文档精读”为例。这个 case 专门考察模型是不是真的读懂了材料,而不是逮住几个关键词就开始自行发挥。适用场景包括测试报告、会议纪要、投研材料、产品文档——全是信息密集、容易让人读睡着的长文本。
提示词一共四问。第一问:用 200 字以内总结材料核心结论,这考验的是提炼归纳能力;第二问:提取 5 条最重要事实,并且每条都要标注原文依据,这一下就堵死了“编造事实”的路;第三问:找出 3 个不确定点或数据缺口,考察的是审慎态度和批判性思维;第四问:判断作者结论是否被材料充分支持,给出“支持”还是“不支持”的明确判断。
这四问环环相扣,从信息压缩到细节溯源,从质疑再到价值判断,几乎复刻了专业分析师的阅读路径。哪个模型能在这一连串问题上给出逻辑严密、有据可查的回答,哪个就更可能在文档密集的工作流里成为可信赖的帮手。
横评的价值:不要让用户为榜单买单
排行榜有它的用处,但它的综合得分并不能回答“我该用哪个”。因为每个人的任务场景差异巨大——写文章看重中文表达的自然和文采,数据分析要求步骤清晰、格式严谨,代码修复则考验对上下文的敏感度。一个模型可能在长文档精读上惊艳全场,却在 SVG 生成上漏洞百出。这正是横评的意义所在:用相同的问题、相同的标准,把每个模型拉到聚光灯下逐项审视,让它们的优势、短板和真实水平自然暴露出来。
这场横评并没有预设谁强谁弱,也不为任何一家厂商站台。它只是把四款热门模型放到同样的任务面前,让结果说话。对于围观已久的普通用户来说,与其在五花八门的排行榜里反复纠结,不如关注这种基于真实任务的对比。毕竟,工具的价值从来不在参数表上,而在它能否帮你把活干完、干好。一场横评或许不会给出唯一答案,但至少能让选择变得更加清楚。
更多推荐阅读

被称“最无聊机器人”的Dyna,靠叠衣服找到机器人Scaling Law
《纽约邮报》曾称Dyna Robotics为“全世界最无聊的机器人”,而公司创始人认为这是“对一家机器人公司最高的赞美”。Dyna-1主攻叠毛巾、叠衣服;新发布的Dyna-2让机器人Taku进入洗衣房,完成放脏衣服、操作洗衣机、取出送烘干机、折叠放架等流程。联合创始人Jason Ma表示,机器人真正开始工作本就应是“无聊”的,真实部署是衡量机器人的“唯一评估”;机器人不能落地,不是因为没有腿或手,...
2026-10-20 09:48:01
前剪映负责人做视频Agent获千万美元融资
视频Agent赛道出现新玩家Pexo,与采用画布工作流的产品不同,Pexo将剪辑和视频整合在产品中,支持用自然语言对话创作视频。公司已获千万美元天使轮融资,此前于2025年10月获得数百万美元投资。创始人廖谦曾任生数科技产品副总裁、Vidu产品负责人,也曾在腾讯、字节跳动任职,从技术研发转向AI产品与商业化,先后从0到1搭建火山引擎智能创作云,并在剪映/CapCut发起海外AI内容平台Pippit...
2026-10-20 09:26:14
DeepSeek搜索卷起来后,前负责人创业做全网捞人
近日,DeepSeek开放了自研网页搜索接口,披露该引擎每天处理全球数亿次请求,已收录千亿级网页,正将搜索能力开放给更多开发者。 在搜索对象中,人物信息最为特殊,难点在于把零散线索拼到同一个人身上。Simplex AI创始人张博曾任DeepSeek-VL项目负责人,其团队推出的Lev8主要面向GTM,人物搜索是流程起点。用户用自然语言描述目标,系统即寻找符合条件的对象,结合公开资料判断匹配度,生...
2026-10-20 08:09:15
蚂蚁领投!清华系AI创企熵简科技完成C轮融资
智东西10月19日消息,北京AI金融创企熵简科技宣布完成C轮融资,由蚂蚁集团领投,东方国信与乔贝资本跟投。融资后,蚂蚁集团将与熵简科技在AI金融智能体研发、AI金融垂域模型训练等领域展开深度合作。 熵简科技成立于2017年,主要依托大数据、云计算、人工智能等技术,打造全资产、全流程的端到端智能资产管理平台。公司名称源自热力学第二定律中度量系统混沌程度的“熵”,“熵简”寓意通过AI降低金融投研的复...
2026-10-20 09:26:26
Anthropic预言奇点已至:2030年美国GDP或飙至44万亿美元
在曼谷举行的国际货币基金组织佩尔·雅各布森讲座上,Anthropic联合创始人Jack Clark提出判断称“奇点已经到来”,即技术进步速度已甩开人类理解和跟进的能力。他预测,在奇点驱动下,到2030年美国GDP将升至44万亿美元。按常规推演,该数字为33.5万亿美元,奇点带来15.4%的额外GDP,平均每年约6%的GDP增长;到2030年前后,累积生产率提升与资本积累将把美国年化经济增长率推高至...
2026-10-20 08:36:21
港科大CMU联手开源新模型:KV Cache砍掉99%,单卡吞吐飙6倍
谷歌一篇论文提到KV Cache至少能压缩6倍,曾引发美光等存储芯片巨头股价下跌。几个月后,岩山科技旗下岩芯矩阵联合港科大、CMU等高校发布并开源EdgeRock-4B,对KV Cache的处理更进一步:上下文从4K扩展到256K,KV Cache占用始终固定在72MiB,相比源模型减少99.1%。一张80GB显卡可同时跑512路长推理,输出吞吐达12124 tokens/s,是源模型的6.42倍...
2026-10-20 23:25:26