DeepSeek V4.1 Flash评测超Pro,官方却两次改口不下线
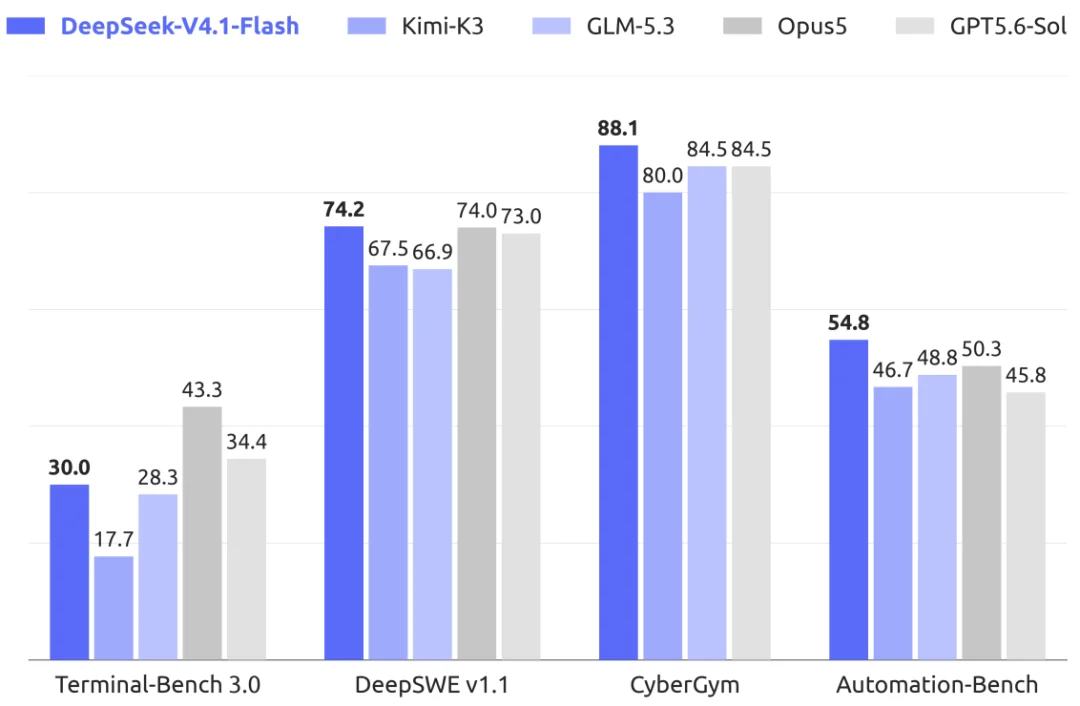
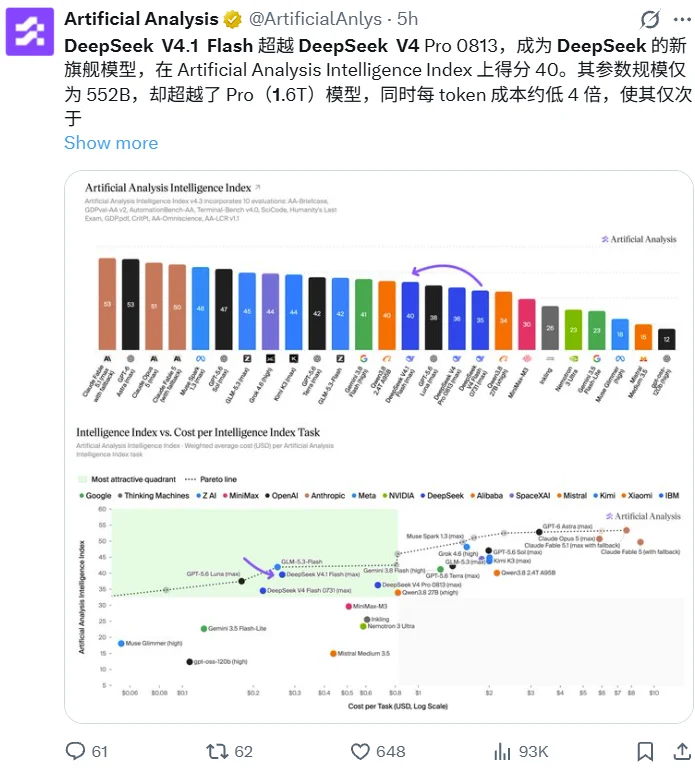
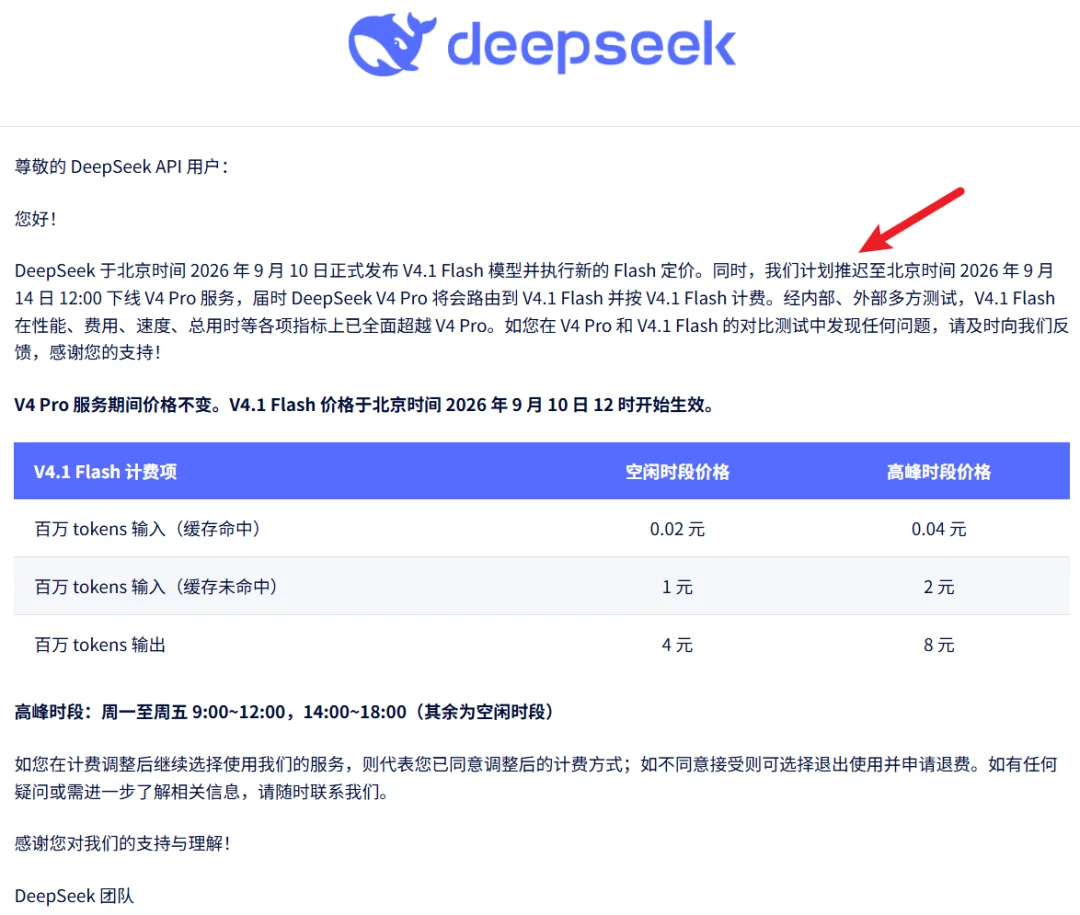
DeepSeek V4.1 Flash 正式上线后引发广泛关注。Artificial Analysis 测试给出 40 分指数评分,超过参数量更大的 DeepSeek V4 Pro。DeepSeek 曾两次调整决定,先延迟下线 V4 Pro,随后放弃下线并继续提供 API 服务。
评测显示,V4.1 Flash 在智能体能力和长上下文推理方面进步明显,以 69% 在 AutomationBench-AA 上排名第一,与 GPT-6 Astra 持平,略高于 Grok 4.6 的 67%。它也是测得冗长度最高的模型之一,每个 Intelligence Index 任务消耗 89k Tokens,但成本仅 0.27 美元,主要得益于低定价。Sebastian Raschka 认为其创新之大,应称为 DeepSeek V5。
技术报告标题为《DeepSeek-V4.1-Flash: Pushing the Limits of KV Cache Compression》,核心目标是压缩 KV 缓存。V4.1-Flash 全局 KV 缓存压至每 token 890 字节,约为 V4-Flash 的 1/4,相比 DeepSeek-V1 的 389,120 字节差距达 437 倍;持久化 KV 缓存压至 V4-Flash 的约 1/8。模型为 552B 主干参数加 196B Engram 参数的多模态 MoE,原生支持 100 万 token 上下文,在 45T token 多模态语料上预训练,prefill 阶段每 token 激活 8B 参数,decode 阶段激活 16B。
报告指出,稀疏注意力已降低长序列计算成本,但长程 agent 负载输入重,瓶颈转向存储与搬运:HBM 容量限制并发请求的全局 KV,SSD 和主机内存限制前缀缓存命中率,IO 与互联带宽限制缓存迁移加载速度。V4.1-Flash 从架构、精度、部署三层次同时下手。
架构上,语言主干 40 层分为前 20 层因果编码器和后 20 层解码器,即 CED 结构。解码器各层 KV 由第 20 层隐藏状态经各自投影矩阵映射得到,prefill 只需跑前 20 层,复杂度从 O(NL) 降至约 O(NL/2)。该思路继承自微软 YoCo,但 CED 为每层配置独立投影权重,扩大 KV 有效容量和生成深度。代价是 SWA 仍需逐层计算,DeepSeek 采用近似处理,只回放提示词最后 n_win 个 token,即 Decoder SWA Bounded Replay。
CSA2 负责存储压缩,将压缩空间归纳为条目大小、序列维度、层维度三个相乘维度。此前 IndexCache、YOIO、HySparse 均未覆盖全部三维,CSA2 为每个 CSA2 层静态分配 Full、Reindex、Reuse 三种模式之一,共同点是每层保留自己的全局 Q 和 SWA KV,避免层间表达能力被抹平。
精度上,V4 已对索引器 Q、K 做 FP4 量化感知训练,V4.1-Flash 将 FP4 推进到 main KV 缓存,采用 E2M1 配每 16 通道一个 E4M3 缩放因子,接近 NVFP4 但省去二级全局缩放。部署上则采用 SWA Bounded Replay,接受近似重建以降低生产部署代价。
更多推荐阅读

Rokid首款全彩AI眼镜亮相,4999元起
10月27日,乐奇Rokid在杭州发布第二代AI眼镜Rokid Glasses 2、首款全彩AI眼镜Rokid Color及智能戒指Rokid Ring三款新品。 Rokid Glasses 2佩戴更舒适、续航更长,搭载高通骁龙AR1+平台与6nm恒玄BES2900BP芯片的双芯架构,镜片彩虹纹降低60%、反射率降低70%,光效率提升30%,透光率达98%。镜腿更细但电池容量提升25%,整体续航...
2026-10-27 08:17:43
港大PhD兼小米大模型研究员:AI时代读博的10个关键问题
本周「十字路口」嘉宾是李磊,小米MiMo大模型后训练研究员、香港大学在读博士。他一边参与大模型训练,一边读PhD,面对AI带来的机会与飞速变化的节奏,既兴奋也焦虑。本期聊的主题是:AI时代PhD怎么拿到理想结果。 李磊2016年就读西安电子科技大学本科,2020年到北大计算语言学研究所读硕士,2023年到香港大学NLP Group读PhD。他提到读PhD的决定:如果10年后躺在床上可能后悔没去读...
2026-10-27 08:00:13
行元智能押注人类数据,破解具身智能Scaling燃料难题
具身智能不缺钱和演示,缺的是可复现的Scaling曲线。去年11月,北美Generalist发布GEN-0,称首次在机器人上观察到该曲线:预训练数据和算力越多,下游任务表现越稳定可预测地提升。支撑它的是超27万小时真实操作数据,每周新增上万小时。曲线已有人跑出,燃料却还没有。 今年4月,Generalist发布GEN-1,披露基础模型预训练未用机器人数据,而用低成本穿戴设备采集的人类数据。人类数...
2026-10-27 08:38:39
中国大模型立功!数学家攻克30年世界难题
困扰数学界30余年的三维Ghys猜想迎来破解。大湾区大学教授许地生团队借助中国科学多模态大模型,通过人机协同完成三维Ghys猜想证明。北京大学董彬教授、刘若川院士团队利用其开发的SHEAF框架对证明完成形式化验证,确认其正确性。这标志着中国科学家首次用中国大模型攻克世界级数学难题。相关论文已在arXiv发布,形式化代码在Github公开。 Ghys猜想由法国数学家艾蒂安·吉斯于1995年提出,猜...
2026-10-27 09:36:42
蚂蚁灵光2.0发布:AI能主动管事了
最近两个月,Personal Agent 从边缘话题变成普通用户手机上的新图标。Meta 9 月 8 日推出 Muse,40 天下载量破 1000 万;随后 OpenAI 推出 Dots,Anthropic 推出 Claude Duet。对国内用户来说,用上这些产品要折腾半天,加上翻车案例,把生活权限交给 AI 仍有顾虑。我在意的是,离开对话框后能不能放心让它帮我管事。 蚂蚁正式发布灵光 2.0...
2026-10-27 08:58:06
GPT-6.1 Terra发布:电脑操作比肩Astra,成本仅其1/10
OpenAI 发布最新模型 GPT-6.1 Terra,定位为“以更低价格,提供快速、强大的电脑操作能力”,将视觉推理、电脑操作与写作表现结合。Sam Altman 称其“将开启电脑操作的新时代”。相比 GPT-5.6 Terra,新模型在沟通和电脑操作任务上显著提升,可起草提案、解读技术图纸、填写表格、剪辑视频等。 标准 API 定价为:输入每百万 Token 1 美元,缓存输入每百万 0.0...
2026-10-27 08:12:33