DeepSeek工程师写完V4.1核心算子后自述被迫转业
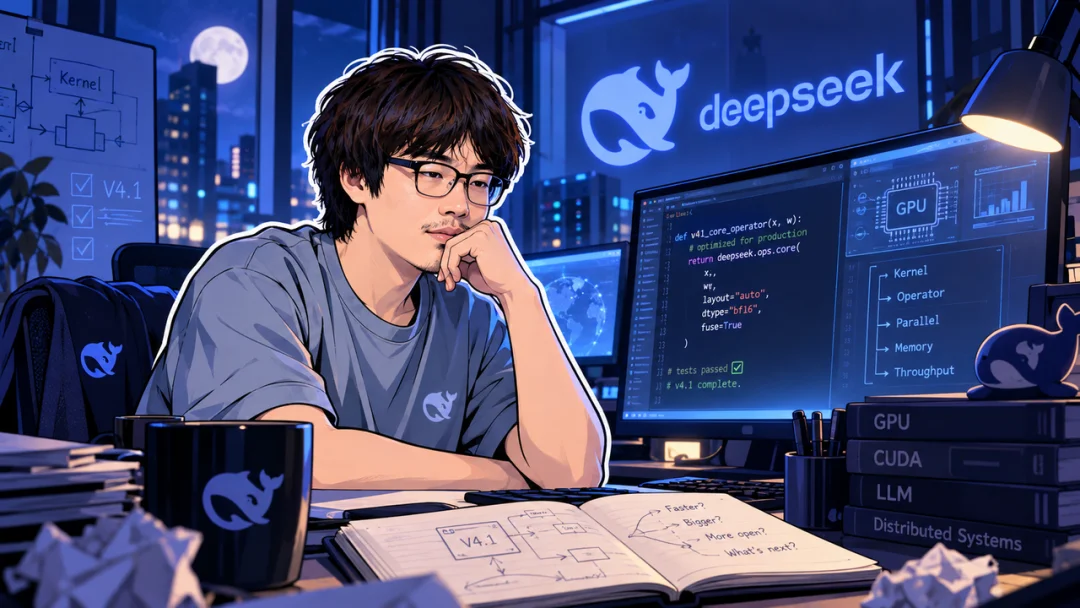
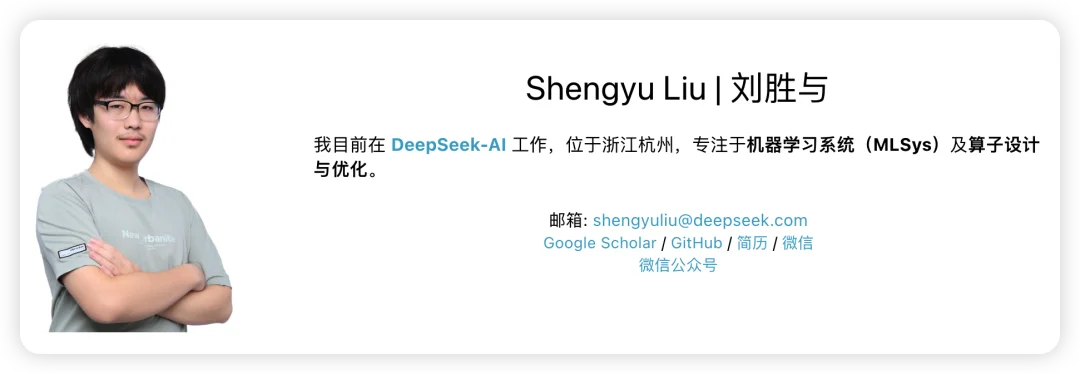
大模型狂飙半年,宏观叙事日趋极端,而AI开发一线的工程师正经历真实冲击。DeepSeek机器学习系统工程师刘胜与凌晨发布长文《我不得不把才华埋葬在昨天》。他刚为DeepSeek V4.1交付核心算子,却目睹模型攻入专业腹地,承认自己正加速被AI替代并被迫“转业”。
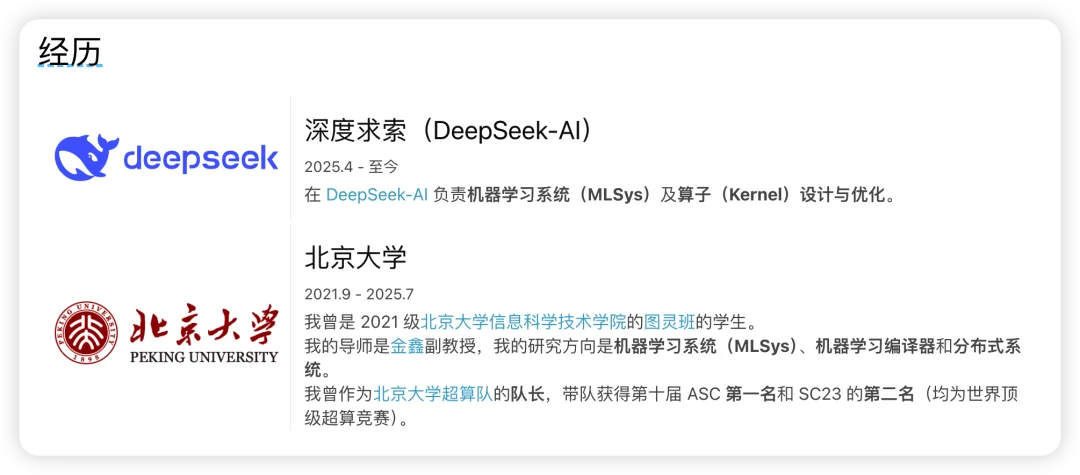
刘胜与是2021级北大图灵班成员,曾任北大未名超算队队长,代表学校出征国际大学生超算竞赛SC23。本科加入DeepSeek后,成为底层基础设施与高性能算子优化主力。其技术贡献包括:2025年2月参与DeepGEMM算子库开源,优化FP8极致性能GEMM算子;2026年4月参与DeepEP V2专家并行通信库升级,降低跨节点通信开销;2026年9月独立负责DeepSeek V4.1主Attention算子(head dim=512的MQA attention),支撑V4.1性能跃升。这些工作筑牢了DeepSeek成本控制与算力利用的护城河,也是国产模型在有限算力下压低成本的核心竞争力。
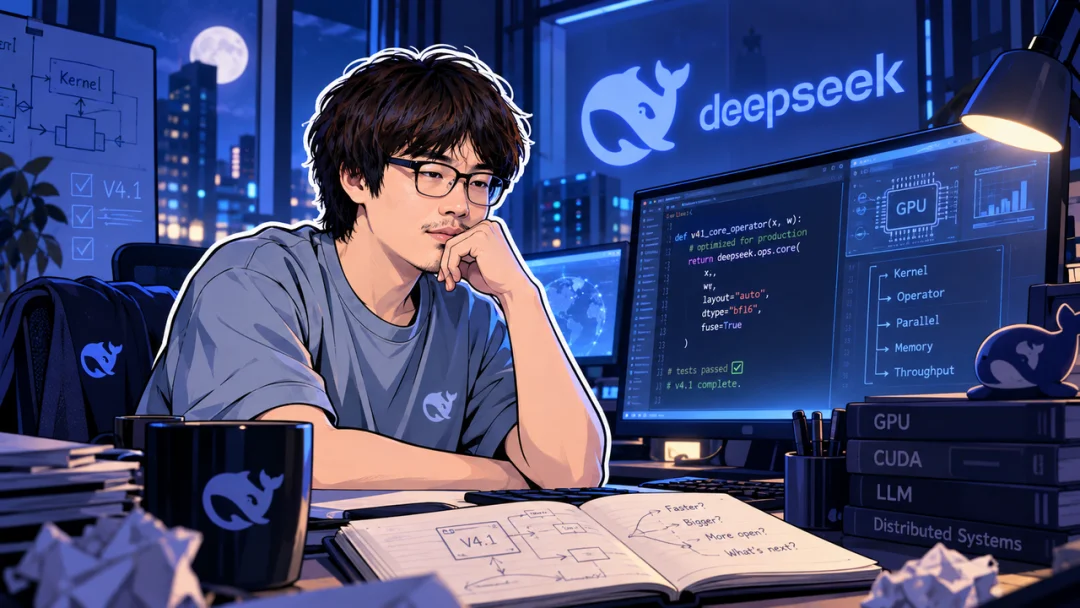
高性能GPU算子编写曾被认为最难被取代。它要求熟悉GPU微架构、内存层次,甚至深入PTX汇编与SASS机器码。但刘胜与指出,“AI成了算子大师”。他推断未来半年到一年,AI自主评估调度方案、设计端到端极致算子的能力,将大概率追平甚至超越顶级人类工程师。AI能一秒思考300个token、二十秒写完一份代码,且能在模型深度、思考强度、工具调用量、并行度上不断提升,而人不能。悖论在于:工程师把算子优化得越极致,模型迭代越快,他们被替代的周期越短。
为何仍倾尽全力?刘胜与说,一是纯粹的技术多巴胺,看到算子性能飙升、跑赢芯片大厂官方算子的成就感不亚于速通玩家破世界纪录;二是清醒认知:即便自己停手,全球其他团队仍会加速推进。他写道:“我当然希望自己不要被革命,但如果非被革命不可的话,我希望革我自己命的人是我自己。”
这种趋势已有案例。OpenAI推进定制AI芯片时,规模化调用Astra和Agent工具参与算子生成与编译栈搭建,将原本数十位资深专家耗时数月的周期压缩至极短。英伟达和Cursor曾公布实验:多Agent系统三周内自动优化235个面向Blackwell B200的CUDA算子,几何平均性能提升38%,19%任务提速超两倍。
刘胜与的判断不是“失业”,而是“转业”。顶尖工程师仍能留在牌桌上,但生产算子的范式彻底变了。他称之为做Agent的“机甲驾驶员”:机甲是拥有超高代码吞吐能力的AI Agent,人类退后一步,凭借对模型需求、硬件物理特性和全局系统工程的把控,给Agent下指令、设边界、评估方案。饭碗保住了,但手艺人打磨代码的快感被剥离。他感叹:“我的手中多了些齿轮,但心中少了些节拍。”
更深隐忧在于工程根基坍塌。大学与科研训练面临投机诱惑,效率捷径正抽空开发者的代码组织、系统构建、前瞻设计与抽象能力。这些能力会像“编写x86汇编”一样边缘化,还是像“理解整套计算机系统”一样成为永恒基石?若是后者,AI泛滥将带来系统性风险。刘胜与写道:“一个工程能力很差的人,搭配上AI后,产出屎山的效率可达先前数倍,给系统埋下祸患,让世界变得更草台。”他追问:“未来社会中,权力是不是会比技术或智商更加重要?”
他选择留在DeepSeek的深层动力是:“我们研究强大、快速、普惠的人工智能并将其开源,或许能把世界从2077那端拉回来一些。”
长文引发技术圈热议。读者“葫芦”坦言正借助Codex开发国产芯片Attention算子,“除了方案不能替我敲定,别的都可以帮助我完成,又快又好”。南京大学计算机学院某博导评论:“我相信系统设计的品味可以由RL有反馈信号,就看什么时候摸清数据构造和训练方法,那时候就真完犊子了。”热评第一的读者“N0W0N”自嘲:“那我们现在岂不是49年入国军。”有人怀疑文章是否大模型所写,刘胜与回复“这是我手写的”,成为对独立思考的捍卫。不少一线技术人员表示,在OpenAI与Anthropic日益封闭背景下,开源社区与国产前沿团队打破技术封锁的意义更加凸显。
商业社会生产力更迭只认效率与成本,不会因“手艺人”情怀放慢脚步。当昨日才华被埋葬,新的机甲已经启动。
更多推荐阅读

连拿四个第一力压Genie 4和Atlas!中国团队造出真物理世界模型
谷歌DeepMind发布实时世界模型Genie 4,实现每秒24帧实时生成、单帧延迟低至40毫秒、2分钟连贯记忆,可同时运行16路UR5机械臂仿真画面。李飞飞团队World Labs推出全模态世界模型Atlas,凭一两张参考照片还原精细3D空间并生成1分钟1440p漫游视频。但主流世界模型生成的三维场景虽逼真,却缺少底层刚体力学计算,画面中的纸箱算不出阻力和重量分布,洗衣机门没有铰链碰撞反馈,机器...
2026-10-31 16:17:03
AI零帧起手写算子,22.5小时反超DeepSeek人类巅峰9.8%
没有源码,没有论文,直接从零开始。今早,ForgeKernel——一个无人参与的Agent在无需参考DeepSeek原始实现的情况下,把DeepSeek最新核心算子写快了9.8%,全程直播仅用22.5小时,引来不少网友围观。 直播内容是一个Agent在英伟达B200上超越DeepSeek-V4.1的FlashMLA Prefill算子。FlashMLA是DeepSeek开源的注意力核心算子库,出...
2026-10-31 15:51:56
Mac藏了个免费本地大模型,终端敲fm就能聊
苹果在 macOS 27 中预装了一个本地大模型,在终端输入 fm 即可使用,无需安装软件、API Key 或付费。该功能早在 6 月 WWDC 上专门介绍过,但几乎未宣传,直到近日有网友在 X 上发帖称发现 MacBook 自带免费本地大模型,一夜之间八十多万人围观。 使用需同时满足:macOS 27、Apple 芯片 Mac、开启 Apple 智能、设备非中国大陆购买。国行 Mac 因硬件区...
2026-10-31 15:28:41
国产GPU现场随机出题PK英伟达,结果赢了
一家国产芯片公司天数智芯在活动现场用自家GPU与英伟达H200进行实机PK,题目由现场随机挑选人员当场给出。文生图任务“一只老虎把月亮踢飞”中,天垓300用时95.6秒,H200耗时112秒。随后天数智芯又用巴掌大的银色盒子彤央TY1200,在端侧断网条件下与英伟达Jetson Thor T5000对比,题目为“狮子和老虎单挑,谁会赢”,TY1200速度明显更快。同日,天数智芯还发布了用AI开发A...
2026-10-30 09:00:48
Fable 5.5内测曝光:Claude回答后竟执行隐藏指令
Gemini 4 Carbon 发布不久,Fable 5.5 被曝正在测试。有用户使用 Opus 5.5 时被路由到更新模型,效果明显更好,怀疑是 Fable 5.5 或下一代 Opus。此前 The Information 爆料称,Anthropic 准备推出更能读懂用户意图的模型,它更擅长跳出常规思维,例如修复 Bug 时会寻找底层问题并询问是否修复整个问题类别。 网友实测让 Opus 5....
2026-10-30 09:28:48
微软单季营收6152亿,Azure大涨48%
微软公布2027财年Q1业绩(对应自然年2026年Q3),营收、净利润均强劲增长并超华尔街预期。季度营收923亿美元,同比增长19%;GAAP净利润366亿美元,同比增长32%;稀释后每股收益4.92美元,同比增长32%。剔除对OpenAI投资影响,非GAAP净利润364亿美元,同比增长18%,稀释后每股收益4.89美元,同比增长18%。 云业务是核心支柱。Azure本季度营收同比大增48%至3...
2026-10-30 08:30:34