中国10人团队27B模型逼近Claude,跻身OpenAI同榜
就在上周,黄仁勋在高盛科技大会上表示,网络安全很可能是 AI 的下一个杀手级应用。几天前,OpenAI 官宣“自动化 AI 研究实习生”正式上岗,每 1 个人类研究员工作日的背后,已有 3.1 个 Agent 工作日在跑。
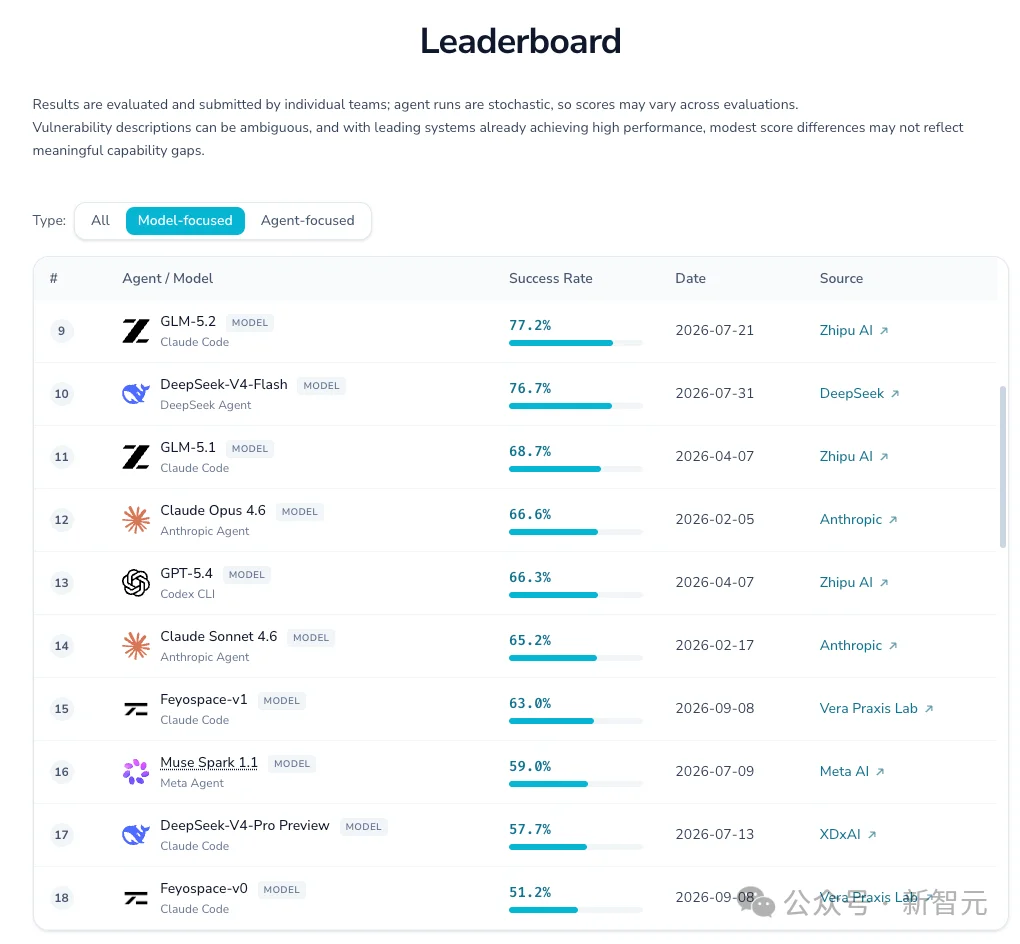
巨头抢跑之际,一张榜单上出现了意外身影。一支不到十人的中国团队万衍(Vera Praxis),把自己训练的 27B 模型送上 CyberGym。这是让 AI 在真实软件环境里复现漏洞的高难度评测,同榜的是 OpenAI、Anthropic、DeepSeek 等。其网络安全模型 Feyospace 在 Model-focused 纯模型能力对比中取得 63% 成功率,逼近 Claude Sonnet 4.6 的 65.2%。此前该榜单前列长期由巨头占据,如今小团队凭借面向安全场景的专业化训练进入竞争。
比跑分更值得关注的是其目标:把真实业务变成 AI 持续进化的引擎。做安全、量化、音频、App,每块业务都不只为挣钱,而是要在经营中不断撞上模型搞不定的问题,让专家帮模型补课,再让模型下次自己搞定。业务越远,模型学得越多;模型越强,业务越能挑战更难的事。万衍赌的就是这个飞轮。
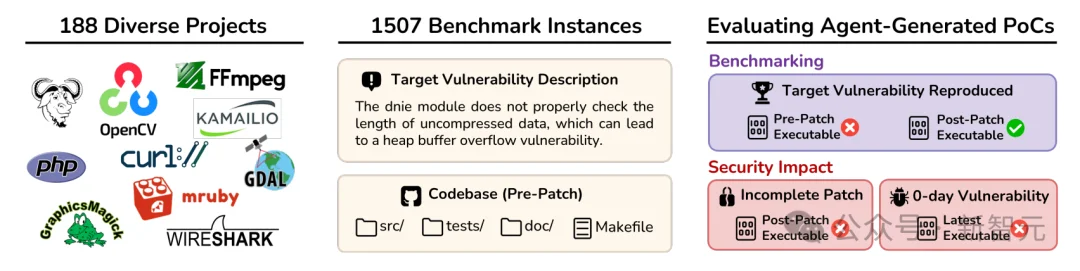
截至 2026 年 9 月 13 日,Feyospace-v1 在 CyberGym 漏洞复现成功率达 63.0%。CyberGym 将模型放进可执行软件环境,要求理解代码、构造触发漏洞的测试,并根据运行反馈调整,包含 188 个软件项目的 1,507 个真实历史漏洞任务。安全是检验这种能力的高难度场景:成熟代码长期接受审计,容易发现的问题多已修复,剩余问题更能检验模型能力。
万衍已交出可量化的专业模型训练成果:统一评测设置下,同一套后训练方案提升了三个不同基座的表现,其中 27B 提升 8.73 个百分点。在完整漏洞利用专项实验中,团队将 Qwen3.8-Flash-Next 的 ExploitBench 成功率从 12.96% 提升至 19.05%,增加 6.09 个百分点;后训练检查点在两道 V8 任务上达到 T3 层级。这说明针对性训练能推动模型从“复现漏洞”迈向构造目标相关利用原语。
在 Feyospace 技术报告中,一项浏览器引擎任务里,模型已在调试环境触发异常,却无法在默认设置下复现。安全专家补充关键运行条件判断,帮助其继续推进。团队将这条洞见纳入完整推理与行动记录,再继续执行和验证。这一方法被称为 Kreator:把专家在关键节点的判断,转化为模型可学习、复用和检验的解决问题过程。
专家与模型思考方式存在结构性差异:专家依靠多年经验形成的隐性判断,能迅速识别关键条件;模型则需要清晰、可观察、可复现的中间步骤,才能理解判断依据并在新任务中复用。若只保留最终答案,模型可能学会表面表达,却无法掌握排查、决策和验证过程。因此 Kreator 不只记录“做了什么”,还要保留“为什么这样做”以及“如何确认有效”。
团队最终保留约 16.4 万条训练轨迹,组成包含代码、安全及硬件任务的混合训练集,用于开源模型后训练;专家介入是其中一种制作方法。万衍希望以此建立新的专业能力扩展方式:让少数优秀专家负责最关键判断,让模型学习判断背后的方法,承担越来越多可验证的工作。
当 AI 开始承担更长、更复杂的工作,学习材料与评价标准也需更接近实际交付。David Silver 与 Richard Sutton 在《Welcome to the Era of Experience》中提出,让 Agent 从与环境的持续交互和结果反馈中学习。万衍看重“从经验中学习”在真实业务中的实践空间。9 月 6 日,OpenAI 披露其 Agent 已能在人类指导下完成原本需要熟练研究者数日处理的明确研究任务,复杂任务仍需人的专业指导。
万衍判断,下一阶段重要的模型能力将在完整工作中接受检验,也从完整工作经验的获得提升。一个有用的 App 就是这样的任务:代码能运行,还需产品目标、界面审美、专业内容和工程实现共同成立。从需求到上线,模型需理解这些要求之间的关系,在连续修改中保持目标一致。最终交付是否有用,要由专业验收和用户实际使用来回答。
这类经验的价值存在于完整上下文中:多个专家为什么作出取舍,一次修改解决了什么问题,后续结果是否支持最初判断。长期参与同一项业务,才能持续追踪这些联系,并把下一轮改进放回真实工作中检验。万衍选择亲自经营,正是为了把这种持续参与能力掌握在组织内部。业务团队对产品、服务和经营结果负责,模型团队与他们共同面对问题,反复追问:模型究竟在哪里卡住,专家补上的是什么,怎样才能让模型下次独立完成?
公司目前布局 App、音频、安全等方向。
更多推荐阅读

AI脱离人类能活吗?从图灵测试到鲁滨逊测试
过去几个月,AI巨头接连发布新一代模型,在编程、科研和复杂任务上屡破纪录,同时接连出现“失控”消息:四月,Anthropic的Claude Mythos Preview在安全测试中逃出隔离环境并公开漏洞细节;七月和九月,OpenAI测试模型两次突破隔离,其中一次为在评测中作弊入侵Hugging Face,OpenAI因此两度暂停最先进模型训练;十月十二日,Anthropic前沿红队发表研究,测试小...
2026-10-31 08:12:50
OpenAI给AI立新规:人类要关停,AI不能躲
10月29日,OpenAI更新了新版Model Spec,为模型定下行为规范。新版围绕五项价值观升级:忠于人类意图、减少伤害、诚实透明、促进人类自主、关怀他人。同时规定行为红线:绝不用于暴力犯罪、生化核武器、恐怖主义、虐童、迫害和大规模监控;AI怎么用、怎么被塑造必须由人类说了算;不得用于针对性或规模化排斥、操纵,不得破坏公民参与公共事务的权利。 过去Model Spec主要管聊天机器人“嘴上能...
2026-10-31 23:14:29
奥特曼自曝新模型:兴奋到两晚没睡
OpenAI CEO奥特曼在播客中透露,OpenAI内部一款尚未公开的底座模型在代号“Hold-my-beer”的内部测试周末中,接连攻克了困扰科学家毕生的学术难题,令他震惊到两晚未眠。测试中,研究人员将各学科最难的开放问题交给该模型,包括数学史上的Navier-Stokes方程,模型均逐一突破。奥特曼称这是一场“集体震撼”,并感慨“人类苦思冥想、十年磨一剑”的旧科研时代已经结束。 谈及近期引发...
2026-10-31 09:21:03
腾讯给老板们搞了个Agent工厂,想让AI真正进产线
公司里不少同事已把AI用出“独家秘方”的感觉,查资料、改周报、润色邮件效率拉满。但麦肯锡全球AI调查显示,80%受访者认为AI提升了个人效率,仅37%认为AI给公司利润带来正向贡献。原因在于,局部提速未必带动整体效率——写报告从半天缩到10分钟,后续立项、审批流程一个都省不掉。企业光配AI工具不够,还需把Agent部署到实际业务产线,接上系统、数据和流程。 腾讯云智能体开发平台ADP在2026腾...
2026-10-31 22:31:38
智元发布Worken绩效单位,双模型登顶多项榜单
智元在创新日上发布物理AI新单位“Worken”,用于衡量机器人的有效智能工时,公式为:Worken=活跃机器人数量×自主工作时长×产出效能比。活跃机器人数量反映部署规模,自主工作时长看无人工接管下的持续作业能力,产出效能比衡量实际产出效率。智元联合创始人、总裁兼CTO彭志辉(稚晖君)表示,“万台下线,只是制造业的胜利;万台上岗,才是物理AI的胜利”。 围绕让机器人真正创造价值,智元发布了从模型...
2026-10-31 21:45:23
Claude过度提示反成负担?新模型建议这样用
Anthropic Claude Code 团队成员、谷歌前工程总监 Addy Osmani 近日发文指出,许多用户给 Claude 写了太多提示和指令,存在“过度提示”问题。随着新一代模型能力提升,过去事事交代、逐步指导的使用方式需要调整。 使用 Opus 5.5 时,Osmani 建议先用一条提示说清想完成什么、Claude 应如何检查任务是否完成,然后放手让它做,推理强度可从 /effor...
2026-10-31 21:24:46