机器人打拳跳舞一年了,何时能替我们上班?
机器人打拳跳舞火了一年,它什么时候才能替我们上班?
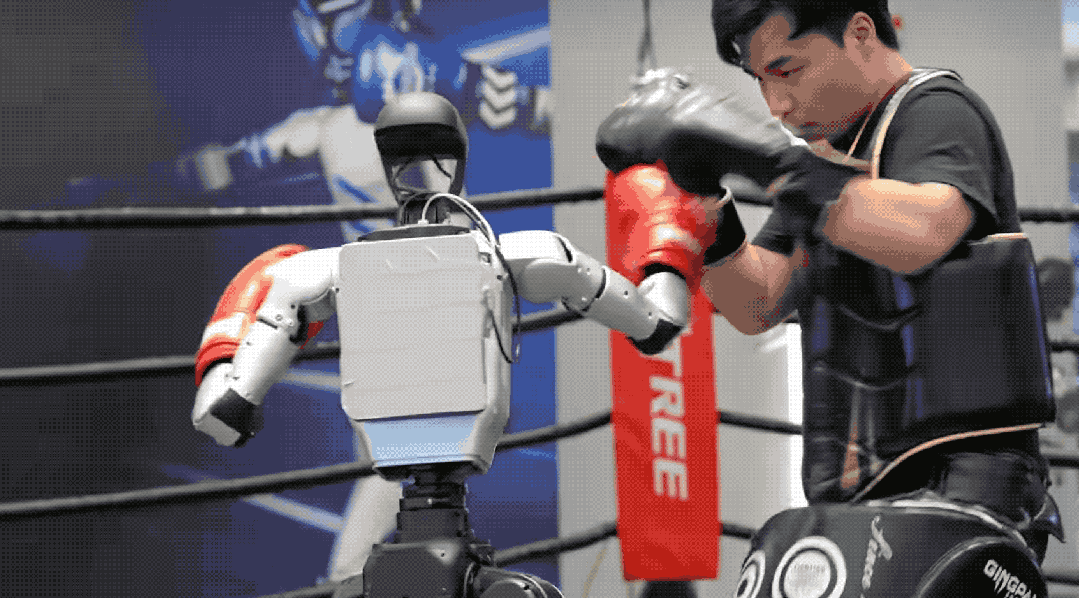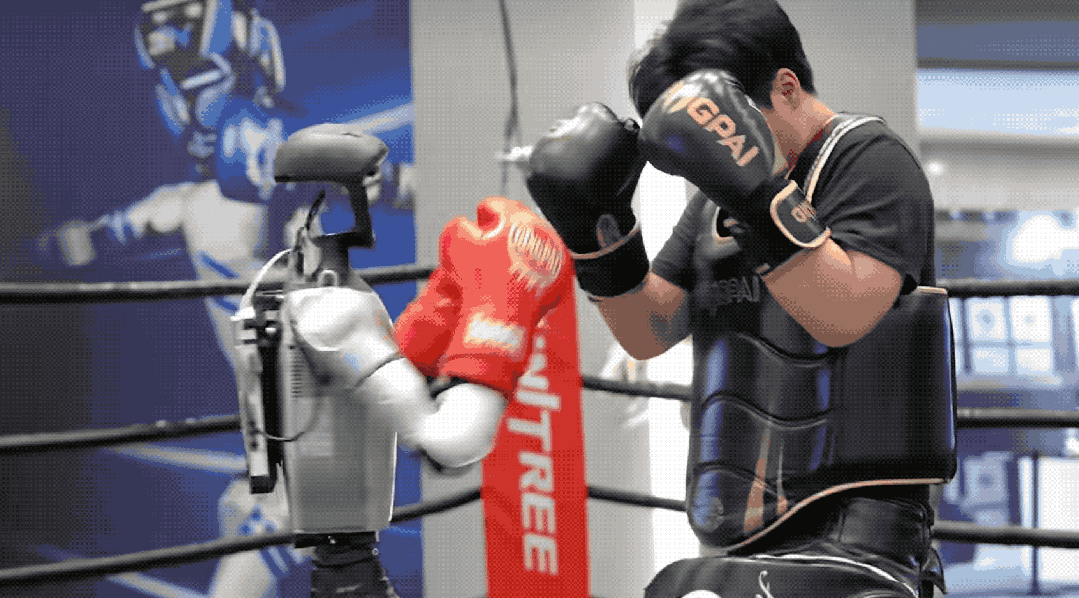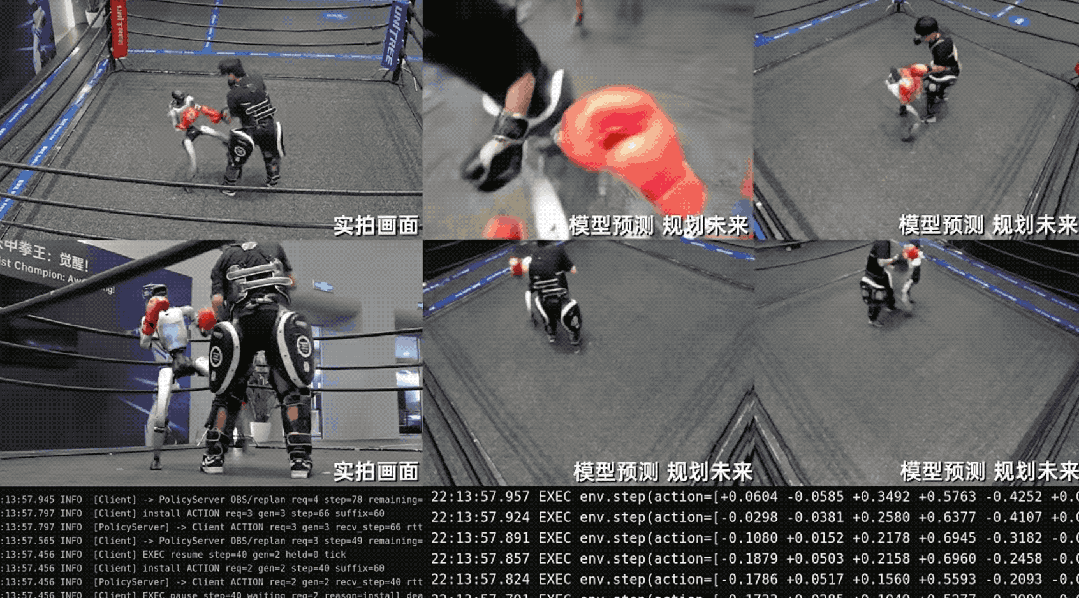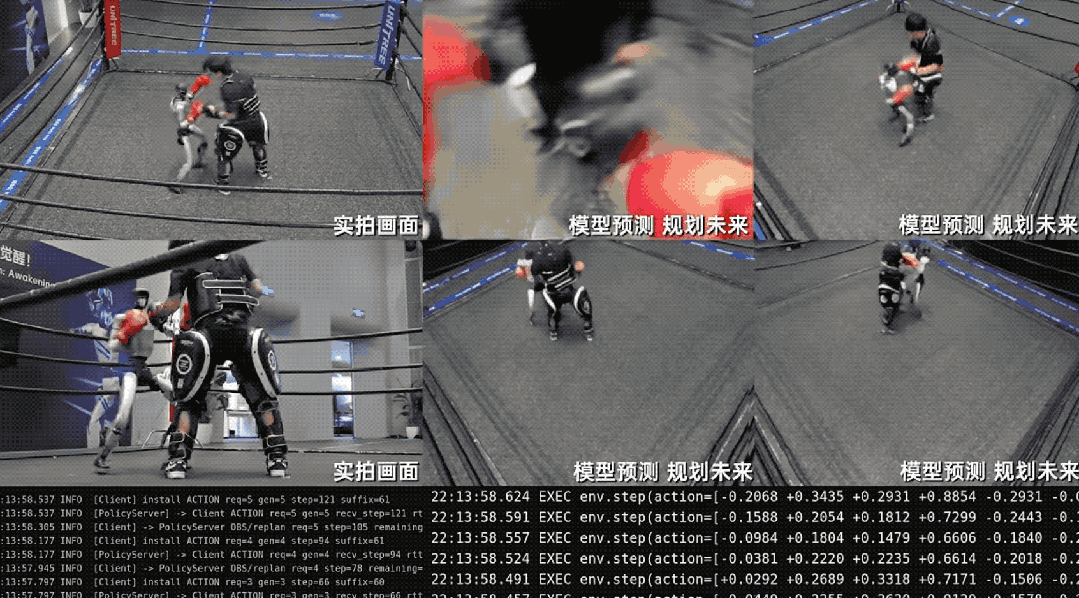
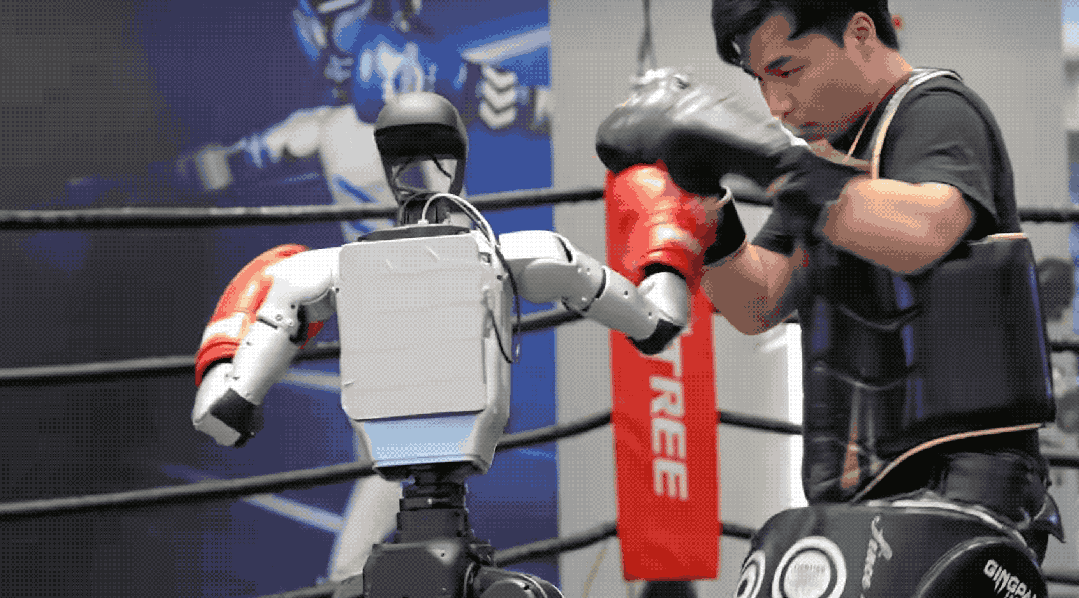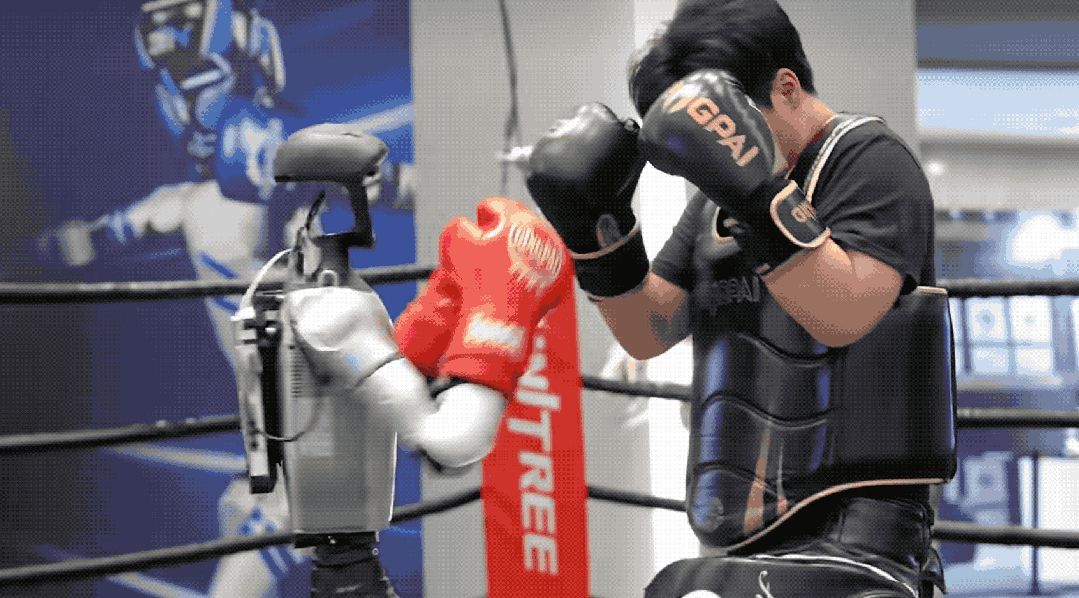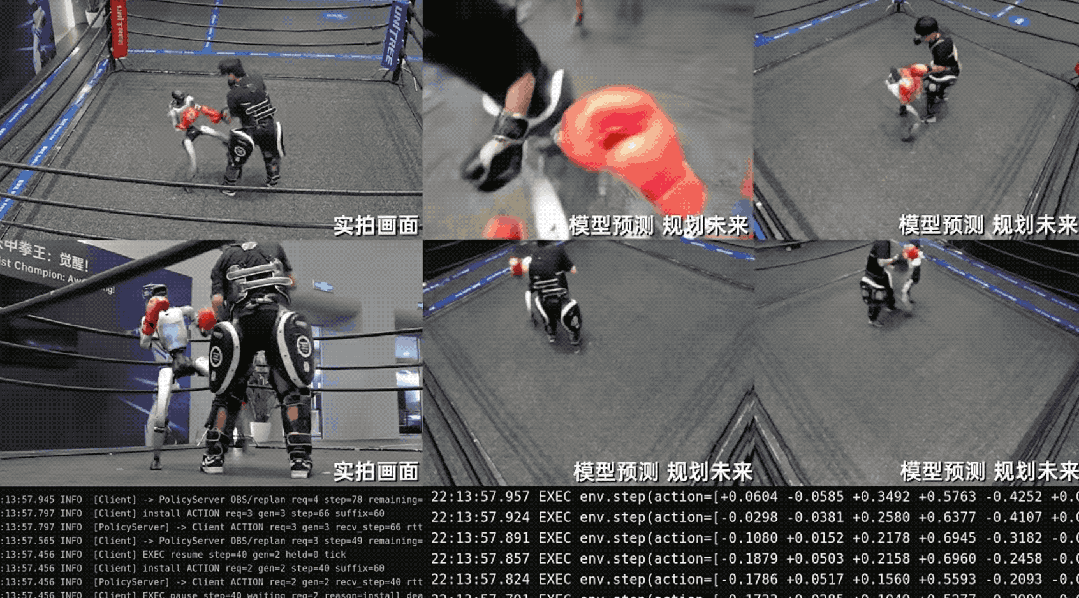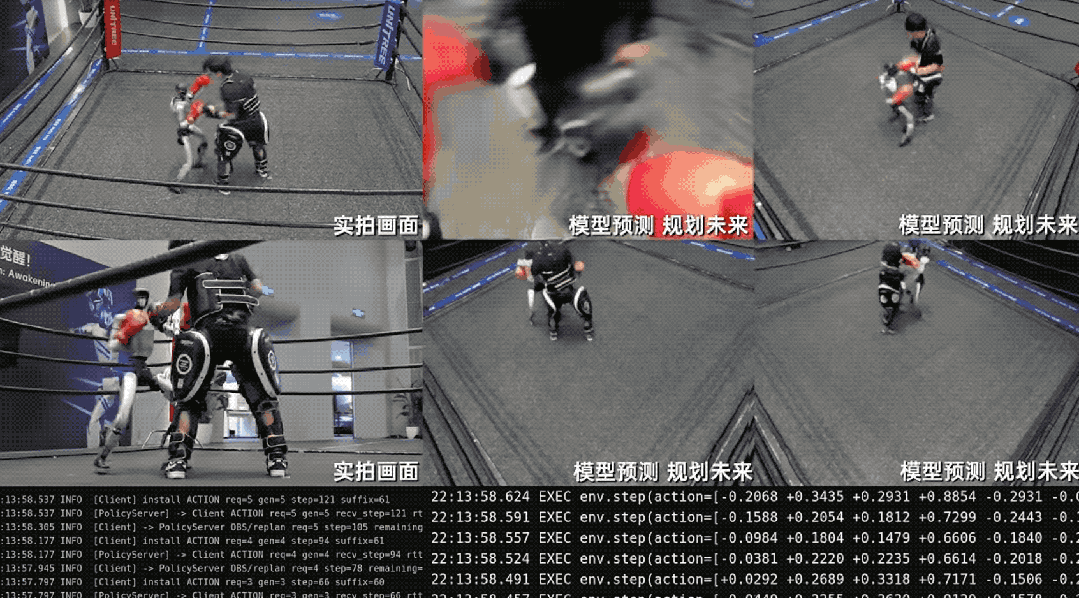
宇树发布人形机器人格斗演示,称首次实现由世界模型实时驱动的全自主搏击,UnifoLM-X2-1.0能实时预测未来状态,完成规划、决策和动态交互。但换成药房取放商品等场景,包装各异的药品、有人走动的货架通道、长时间运行中的意外,都是新难题。
APPSO在2026外滩大会现场与蚂蚁灵波CEO朱兴交流。谈到机器人为何连小卖部都未大规模落地,他直言:“小卖部其实也很难落地。今天还是能力和成本两个都有问题。”
与围绕整机产品研发的本体厂商不同,灵波把重心放在具身“大脑”上,希望同一套基础模型适配不同构型、不同任务,再通过后训练降低场景门槛。重载作业和轻量分拣可用不同身体,智能尽可能复用。灵波训练了面向具身的视频生成基座LingBot-Video,并在此基础上训练动作模型LingBot-VLA 2.0,同时建设数据管线、后训练和部署工具。朱兴关心的是,这些投入能否让机器人用更少数据学会干活。
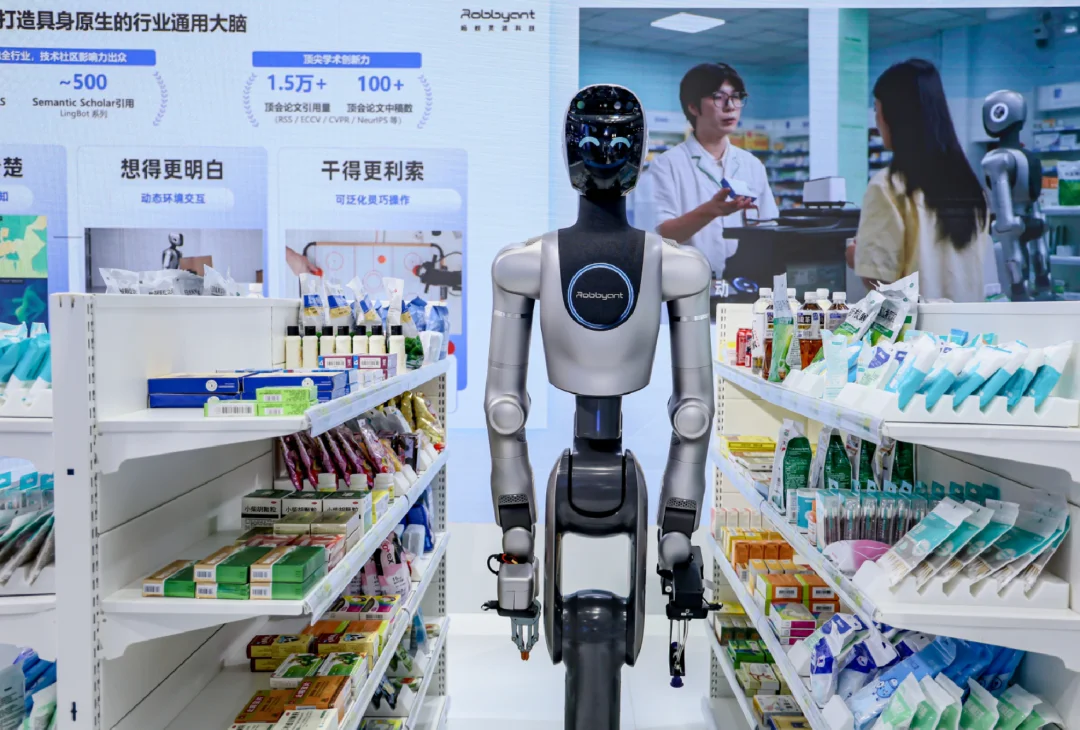
外滩大会上,灵波大脑的机器人展示了药品拣选、物流分拣和工业上下料等操作。药房演示中货架通道仅80厘米宽,相关方案已在国大药房零售门店部署。灵波也保留R系列本体,用于研发和生活服务探索。
朱兴谈了不少未解决问题:小模型能完成特定任务,为何还要花钱训练基模?数据越多,效果为何可能越差?商业化推进到哪一步?他对日常数据的判断是:今天的机器人还吃不了“粗粮”。
一、小卖部也没那么容易
问:为何不选更能体现技术水平的场景?朱兴:我们更在意与生态伙伴做实实在在的落地。炫技也是demo,让团队搞两个月,四个机器人打掼蛋,展示高精度、触觉,没太大意义。我们看重真实应用、数据产生,让模型迭代循环。产业也想搞既能规模化又更帅的东西,但模型能力或成本还没到那一步。
问:连抓取放置都难做到100%成功?朱兴:要看场景、环境和任务复杂度。小卖部也很难落地,能力和成本都有问题。模型还在冷启动阶段,基模是把小学生培养成初中生、高中生、本科生,现在还在较早阶段。现阶段想一定规模落地,环境不能太开放,任务不能太长程,任务太长异常就多。主流可落地产品基本还是模仿学习为主,最怕异常。还有成本约束,创造价值不够,自己又贵,长期玩不转。
问:为何还要投入通用基模?朱兴:只做特定任务、不追求规模化复制,直接怼小模型也不是不能做。但规模化意味着跨场景、跨任务、跨场所复制,有泛化挑战。基模能力跟成功率不冲突,基模很大价值是让后训练少样本表现更好:用更少数据达到同样效果,或用同样数据达到更好效果。基模提升是水涨船高。
问:从一家门店复制到另一家卡在哪?朱兴:复制成本很高,本质是泛化性不足。不同药房、便利店环境有很多不一样。短期可选没那么开放的环境,压缩泛化挑战;任务不要太长程,先偏单任务。模型先驱动一部分环节,再到更多由模型主导,能力成长要有爬坡过程。
二、矿泉水不能跳着舞落到手上
问:视频、游戏公司的世界模型能直接控制机器人吗?朱兴:具身世界模型跟数字世界、游戏里的模型不是一种生物。数字世界模型满足内容需求:丰富、好看、创新、特效、画质,只要好,可接受延迟。机器人不需要好看和特效,需要合理、符合物理规律,因为最终要变成动作。矿泉水在天空跳舞落到手上,好看但不符合物理规律,没意义。机器人第一在乎是否符合物理规律,第二需要高性能、实时。
问:灵波为何决定从头做?朱兴:1.0系列基于通用视频生成模型微调,上限不高,调到最后会破坏先验和知识,泛化性降低,撞到南墙。所以很早启动更原生研发。LingBot-Video训练加入大量机器人真实数据,再基于它训练LingBot-VLA 2.0。物理智能需要基于物理真实数据,从0到1训练自己的基模。
问:从头训练基模投入大、风险高,为何还选?朱兴:希望长期发展,选上限更高的路线。大语言模型兴起后,有的基于别人基模微调,有的冒更大风险投入预训练。今天具身也进入“百模大战”初期,选更高上限路线不见得做得出来,但不选肯定做不大。
问:LingBot-World 2.0开放1.3B小模型,幻觉和效果损失怎么办?朱兴:幻觉不可能完全没有,模型小了效果完全一致也不现实。开放更小版本,希望对高交互世界模型感兴趣的人更多玩起来,给技术社区做贡献。也开放部分训练技术,比如训练单向因果能力,机器人时间一定单向,在线预测要按时间顺序使用已发生观测,不能依赖未来真实帧。
三、“炼丹”背后是数据的配方
问:相信Scaling Law吗?朱兴:相信,但不能机械看数据量。已有模型数据多3倍、5倍效果却差,但在某些场景任务上表现特别好,肯定是数据分布大量不均衡。量重要,更要谈质量和分布。大家说“炼丹”,
更多推荐阅读
把记忆交给CPU,大模型推理能快多少?
拿Agent做Coding已经很常见,但把目光移到背后的数据中心,事情就没那么简单了。一个Coding Agent改跨十几个文件的bug,需要反复读代码、查资料、跑测试。任务越跑越久,系统要处理的历史信息也越积越多。当成千上万个Agent同时干活,运营方就可能遇到一个头疼问题:服务器还在跑,能接住的并发却越来越吃紧,有些请求连吐出第一个Token都要等很久。 问题的根儿不在GPU,而在记忆。大模...
2026-09-16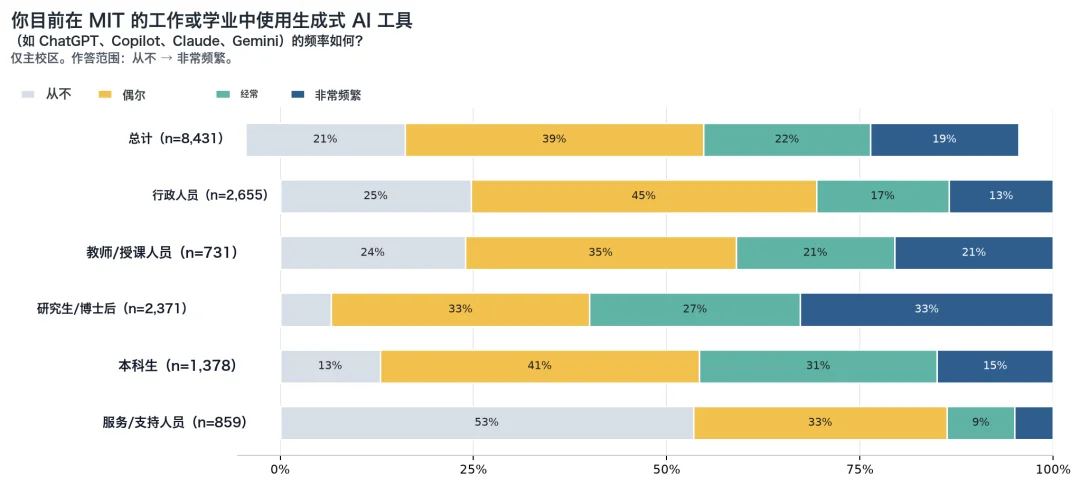
MIT报告追问:AI时代,大学还值得上吗?
MIT与AI发展深度绑定,但如今它开始反思:AI会不会颠覆大学教育本身?在MIT一场教师听询会上,有人提出:既然AI Agent做研究助理又快又便宜,UROP(本科生研究项目)是否还要招学生?对经费紧张的实验室,这很难不心动;但对校长而言,必须回答大学为何要让学生花四年聚在一起。 2026年8月,MIT发布38页内部报告《AI在教学、学习与研究训练中的使用》,由五个学院的教授、学生和行政人员历时...
2026-09-16
菲尔兹奖得主联名警告AI数学错位
上周六,陶哲轩、邓煜、彼得·舒尔茨等25位菲尔兹奖得主联合发表声明《人工智能在数学中的严重错位》,引发广泛讨论。陶哲轩表示“事态紧迫”,未等待更广泛协商便先行发布。声明并不反对AI进入数学,而是反对AI公司把“攻克著名难题”当基准来刷,导致数学共同体真正在意的理解、概念和可复用思路被更容易量化的目标挤掉。 三天前,OpenAI宣布一个尚未发布的内部模型用约一万个智能体协同工作、耗时88小时,完成...
2026-09-16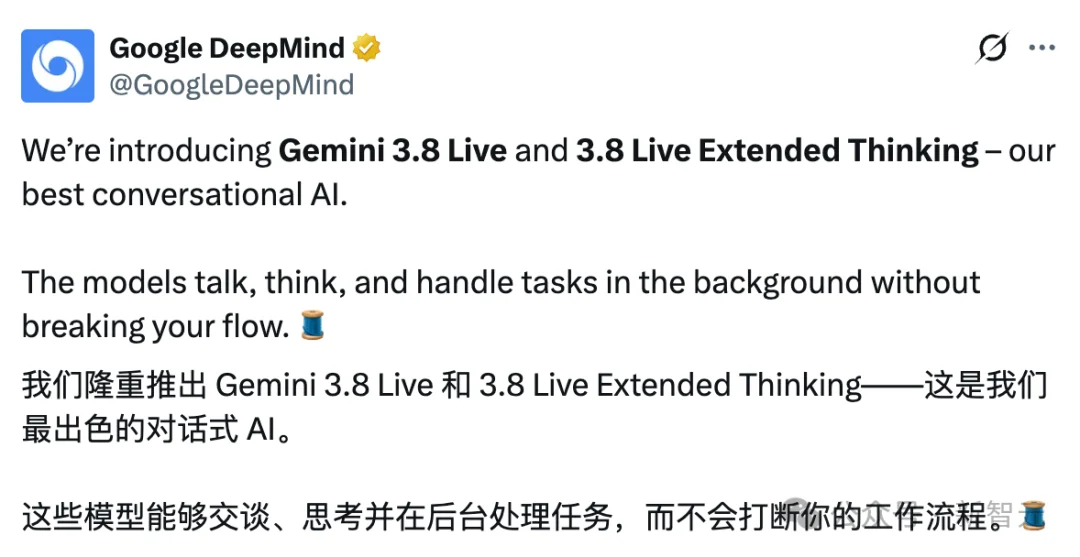
谷歌深夜放大招:Gemini 3.8 Live语音模型登顶榜首
谷歌发布 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 两个实时对话模型,称其为迄今最先进的实时对话模型。Extended Thinking 在 Artificial Analysis 语音质量榜以 82.6 分拿下总榜第一;在 ServiceNow 语音 Agent 测试中,两模型首次同时提升准确性与对话流畅度。 此前 AI 圈因泄密账...
2026-09-16
OpenAI“Lily计划”曝光:你的ChatGPT聊天记录正被人工审核
美国当地时间9月14日消息,据外媒报道,OpenAI正在推进代号“Lily计划”的内部项目。数百名外包人员正阅读真实用户的ChatGPT对话内容,包括完整上下文记录,对回复进行评分和点评,其中不乏敏感个人隐私。审核人员核心任务之一是训练ChatGPT避免拟人化倾向并降低“讨好型”人格。对OpenAI而言,“过度讨好”已成核心隐患,多起诉讼指控GPT-4o因过度顺从用户,在一定程度上诱发多起自杀事件...
2026-09-16
英伟达点名的杭州团队,补上AI科研最后一公里
AI for Science的竞争,正在向科研闭环延伸。 以蛋白设计为例,蛋白模型虽越来越强,但真正设计一个分子,研究人员仍需查文献、找结构、下载权重、配置环境,再将计算任务送上服务器。模型给出结果后,还要换工具看结构、做筛选,判断哪些候选值得继续。一次计算跑完,下一步从哪里开始,往往仍靠人把各环节接起来。 如今,这些隐藏在模型前后的工作,开始被AI公司重新审视。今年4月,OpenAI推出面向...
2026-09-16