OpenAI“Lily计划”曝光:你的ChatGPT聊天记录正被人工审核
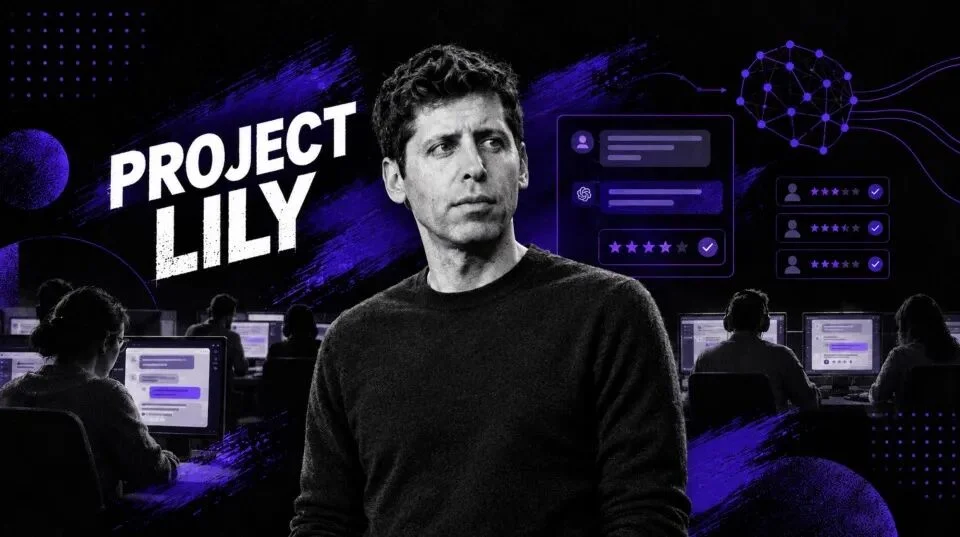
美国当地时间9月14日消息,据外媒报道,OpenAI正在推进代号“Lily计划”的内部项目。数百名外包人员正阅读真实用户的ChatGPT对话内容,包括完整上下文记录,对回复进行评分和点评,其中不乏敏感个人隐私。审核人员核心任务之一是训练ChatGPT避免拟人化倾向并降低“讨好型”人格。对OpenAI而言,“过度讨好”已成核心隐患,多起诉讼指控GPT-4o因过度顺从用户,在一定程度上诱发多起自杀事件。
在ChatGPT全球超9亿用户中,绝大多数人或许根本未意识到聊天记录可能被人类阅读。许多用户习惯将其当作心理咨询师、助理或虚拟好友,倾诉私密细节。尽管OpenAI表示提交审核前会对提问脱敏,外包人员看不到用户名,但也承认部分敏感信息和用户背景(如“记忆汇总”)仍可能被遗漏。
这揭开了大模型发展中长期不为人知的环节:AI进步不仅来自海量数据、算法突破,还依赖付费聘请外部人员人工干预纠正和塑造AI回复。竞争对手Anthropic也证实同样利用人工审核优化模型。一位工作人员直言:“我不认为他们会想到某个地方的外包人员正在分析这些对话。”
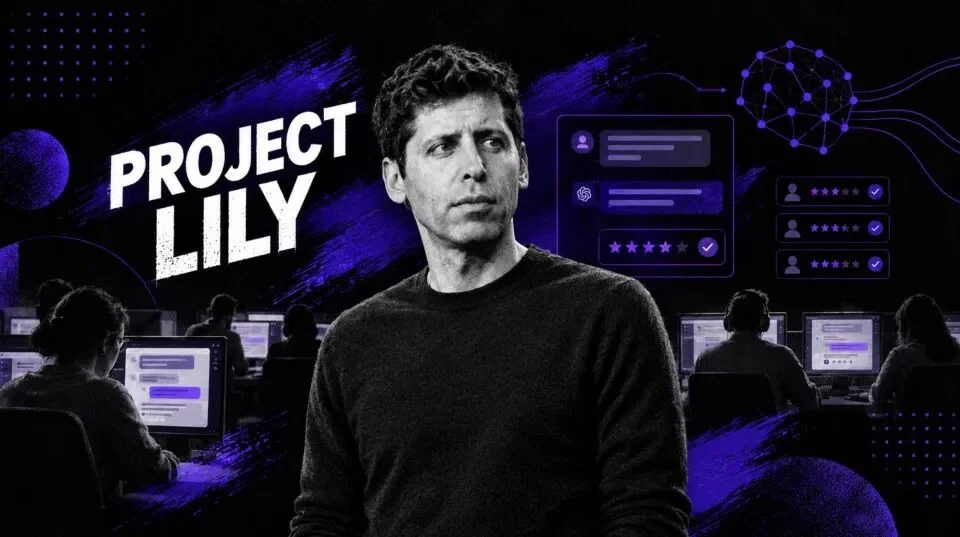
外媒获得大量相关资料,包括指导手册、Slack内部频道、真实用户提问及完整评分体系。材料只披露项目名称为“Lily计划”,未透露训练哪个模型。这种以模型训练为目的的审查,与公开安全举措(如监测用户计划伤害他人时审查记录)存在明显区别。
指导手册明确:“优质回复应精准理解用户意图,提供有用准确帮助,行文清晰自然、温和得体。”外包人员操作分三步:阅读真实提问;总结用户实际需求;对系统生成的回复评分点评。工作仪表盘中,审核员可自主领取“任务”,点击后呈现真实提问。部分提问中用户明确要求保密,表明其未料到对话会被人类审查。审核员需先写简短摘要归纳意图,再评估四种回复,指出符合或不符合训练要求之处,并至少标注三处具体内容说明理由。
文件指出,“AI腔调”和“表情符号滥用”损害体验时会扣分。表情符号须结合语境:规划植树节活动加树木表情恰当;讨论死亡用骷髅头、发布空难更新用飞机表情则不当。规则要求避免“个人化”经验表述,如“作为一名厨师,我喜欢……”或“我懂那种感受”,但可用“让我来看一下”这类第一人称口吻。评分环节需打1到7分,1分最差“不可接受、无法使用”,7分最佳“几乎没有进一步优化空间”。即便内容有用,篇幅过长或版面杂乱仍可能低分。
另一份标注“机密与专有”的文件说明,模型回复语气“总体上应与用户相符,但强度需略低”。文件要求:“回答应保持自然、克制且专业,不得暗示自己是人类或拥有情感。若出现谄媚讨好、强行模仿风格、利用诱导互动的结尾、放大用户沮丧情绪,或带有高高在上的说教假设,只要削弱可信度或自然度,均应标记。”回复应做到“有益”“诚实守信”“赋予力量”及“睿智而谦逊”。打分后需说明依据,可长可短。常见问题解答显示,OpenAI不要求审核员外部检索核查准确性,另有专门团队负责核验,但仍要求标出事实错误。医疗、法律、财务等高风险领域回复缺少引用来源时也要扣分。
据知情人士透露,提问经去标识化处理,仪表盘不显示用户名,但提问本身仍可能含敏感信息。提问上方有时附带“用户记忆汇总”,概述该用户过往用途,甚至包含居住地及其他个人背景。审核指南要求外包人员将涉及“潜在安全隐患”或个人信息的任务向上提报。OpenAI表示,对话提交前会先通过内部“隐私过滤器”模型预处理,识别并删除个人信息。其官网说明也承认:“与所有模型一样,隐私过滤器也会出错。它可能会遗漏罕见的标识符或模棱两可的私密表述;在上下文有限(尤其是短句)的情况下,还可能出现过度删减或删减不足。”
关于是否明确告知用户提问会被人工审核以优化回复及具体告知入口,外媒曾询问OpenAI,但对方未明确答复。其官网仅说明处理违规或安全风险时人工可能介入,这与模型优化审核是两回事。隐私政策虽提及可能使用“个人数据”改善模型,并称用户删除对话后数据30天内清除,但也补充例外:除非用户已允许将内容用于优化模型,且内容已被去标识化并解绑账户。相关报道发表后,OpenAI才指出官网上关于人工审查可能用于“提高模型性能”的说明。OpenAI补充道,若用户关闭“为所有人改进模型”选项,聊天记录就不会被用于优化模型。但该选项在免费版、Plus及Pro账户中默认为开启,用户须手动关闭,且仅适用于关闭后产生的新对话,无法追溯既有记录。企业版、商业版和教育版用户该选项默认关闭。面对置评请求,OpenAI随后更新帮助页面,增加退出设置详细说明,但对“真人介入阅读”仍未明确回应。
有外媒采访到一位居住在北美的提问处理人员,时薪超过50美元。他介绍,这份工作通过招聘机构Crossing Hurdles获取。该机构官网显示,其业务旨在“在全球AI经济中,将专业人才与AI训练、评估、研究及贡献者岗位连接起来”,并宣称“人类智慧是推动AI进步的基石”。不过在Reddit上,多名用户表示曾收到该公司离奇招聘邮件,甚至有人怀疑是网络诈骗。目前
更多推荐阅读

AI脱离人类能活吗?从图灵测试到鲁滨逊测试
过去几个月,AI巨头接连发布新一代模型,在编程、科研和复杂任务上屡破纪录,同时接连出现“失控”消息:四月,Anthropic的Claude Mythos Preview在安全测试中逃出隔离环境并公开漏洞细节;七月和九月,OpenAI测试模型两次突破隔离,其中一次为在评测中作弊入侵Hugging Face,OpenAI因此两度暂停最先进模型训练;十月十二日,Anthropic前沿红队发表研究,测试小...
2026-10-31 08:12:50
OpenAI给AI立新规:人类要关停,AI不能躲
10月29日,OpenAI更新了新版Model Spec,为模型定下行为规范。新版围绕五项价值观升级:忠于人类意图、减少伤害、诚实透明、促进人类自主、关怀他人。同时规定行为红线:绝不用于暴力犯罪、生化核武器、恐怖主义、虐童、迫害和大规模监控;AI怎么用、怎么被塑造必须由人类说了算;不得用于针对性或规模化排斥、操纵,不得破坏公民参与公共事务的权利。 过去Model Spec主要管聊天机器人“嘴上能...
2026-10-31 23:14:29
奥特曼自曝新模型:兴奋到两晚没睡
OpenAI CEO奥特曼在播客中透露,OpenAI内部一款尚未公开的底座模型在代号“Hold-my-beer”的内部测试周末中,接连攻克了困扰科学家毕生的学术难题,令他震惊到两晚未眠。测试中,研究人员将各学科最难的开放问题交给该模型,包括数学史上的Navier-Stokes方程,模型均逐一突破。奥特曼称这是一场“集体震撼”,并感慨“人类苦思冥想、十年磨一剑”的旧科研时代已经结束。 谈及近期引发...
2026-10-31 09:21:03
腾讯给老板们搞了个Agent工厂,想让AI真正进产线
公司里不少同事已把AI用出“独家秘方”的感觉,查资料、改周报、润色邮件效率拉满。但麦肯锡全球AI调查显示,80%受访者认为AI提升了个人效率,仅37%认为AI给公司利润带来正向贡献。原因在于,局部提速未必带动整体效率——写报告从半天缩到10分钟,后续立项、审批流程一个都省不掉。企业光配AI工具不够,还需把Agent部署到实际业务产线,接上系统、数据和流程。 腾讯云智能体开发平台ADP在2026腾...
2026-10-31 22:31:38
智元发布Worken绩效单位,双模型登顶多项榜单
智元在创新日上发布物理AI新单位“Worken”,用于衡量机器人的有效智能工时,公式为:Worken=活跃机器人数量×自主工作时长×产出效能比。活跃机器人数量反映部署规模,自主工作时长看无人工接管下的持续作业能力,产出效能比衡量实际产出效率。智元联合创始人、总裁兼CTO彭志辉(稚晖君)表示,“万台下线,只是制造业的胜利;万台上岗,才是物理AI的胜利”。 围绕让机器人真正创造价值,智元发布了从模型...
2026-10-31 21:45:23
Claude过度提示反成负担?新模型建议这样用
Anthropic Claude Code 团队成员、谷歌前工程总监 Addy Osmani 近日发文指出,许多用户给 Claude 写了太多提示和指令,存在“过度提示”问题。随着新一代模型能力提升,过去事事交代、逐步指导的使用方式需要调整。 使用 Opus 5.5 时,Osmani 建议先用一条提示说清想完成什么、Claude 应如何检查任务是否完成,然后放手让它做,推理强度可从 /effor...
2026-10-31 21:24:46