把记忆交给CPU,大模型推理能快多少?
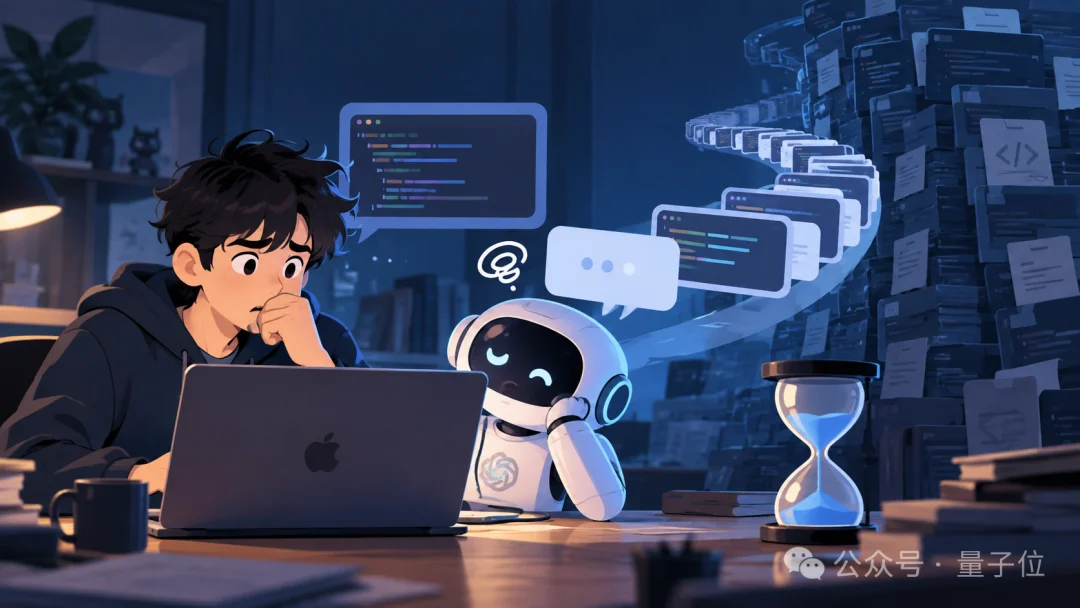
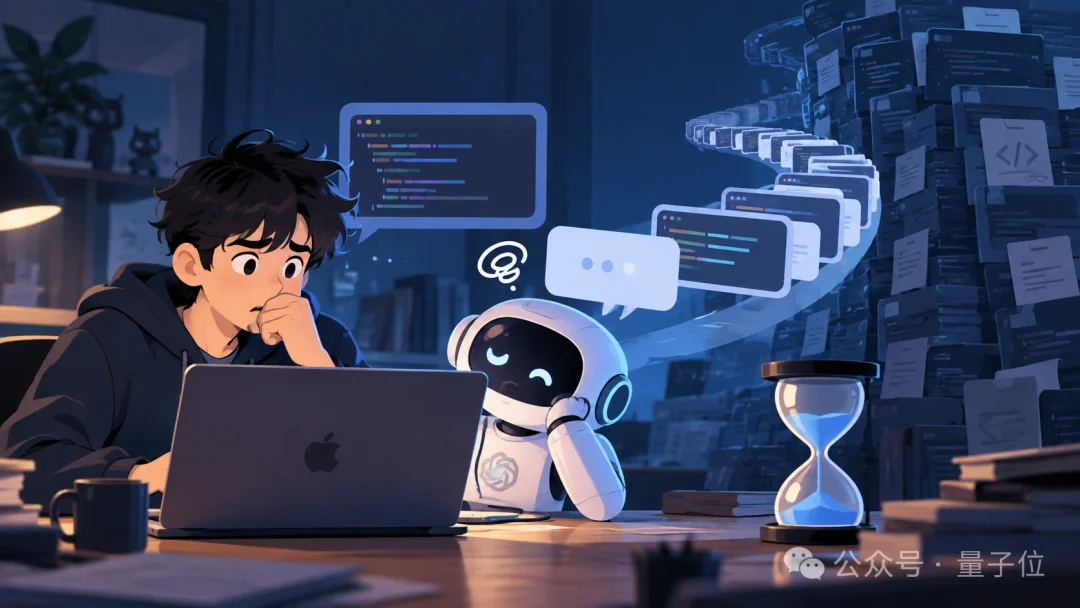
拿Agent做Coding已经很常见,但把目光移到背后的数据中心,事情就没那么简单了。一个Coding Agent改跨十几个文件的bug,需要反复读代码、查资料、跑测试。任务越跑越久,系统要处理的历史信息也越积越多。当成千上万个Agent同时干活,运营方就可能遇到一个头疼问题:服务器还在跑,能接住的并发却越来越吃紧,有些请求连吐出第一个Token都要等很久。
问题的根儿不在GPU,而在记忆。大模型每生成一个新Token,都要用到前文信息。为免每次从头计算,系统会把已算好的中间结果保存起来,这就是KV Cache。会话越长,这份记忆越厚。一旦显存装不下,部分缓存被清走,等Agent下一轮又需要这些历史信息时,就可能重新做一遍Prefill,前面算过的东西又得花GPU时间再算一次。
Agent时代,AI很少一问一答,更多是反复思考、规划和行动的任务,期间不断积累会话历史、检索证据、工具结果和中间状态。于是,一个过去藏在大模型推理内部、普通用户几乎感知不到的东西被推到台前——KV Cache。它的特点就一个字:大。但运营方又不能为省空间,任由已算过的内容反复占用GPU重算。所以,长上下文推理要算的账,从算力延伸到了存储、搬运和复用。破局之道并不是GPU,而是CPU。
对于采用因果自注意力的Transformer模型,前面处理过的Token会在注意力层留下对应的Key和Value,推理系统把它们缓存起来,就有了KV Cache。可以把它理解成模型读书时做的笔记,后面再遇到需要联系上文的地方,模型可以调用笔记,省去对已有Token的重复计算。这里说的记忆,是推理过程中留下的中间状态,模型权重并没有因此变化。
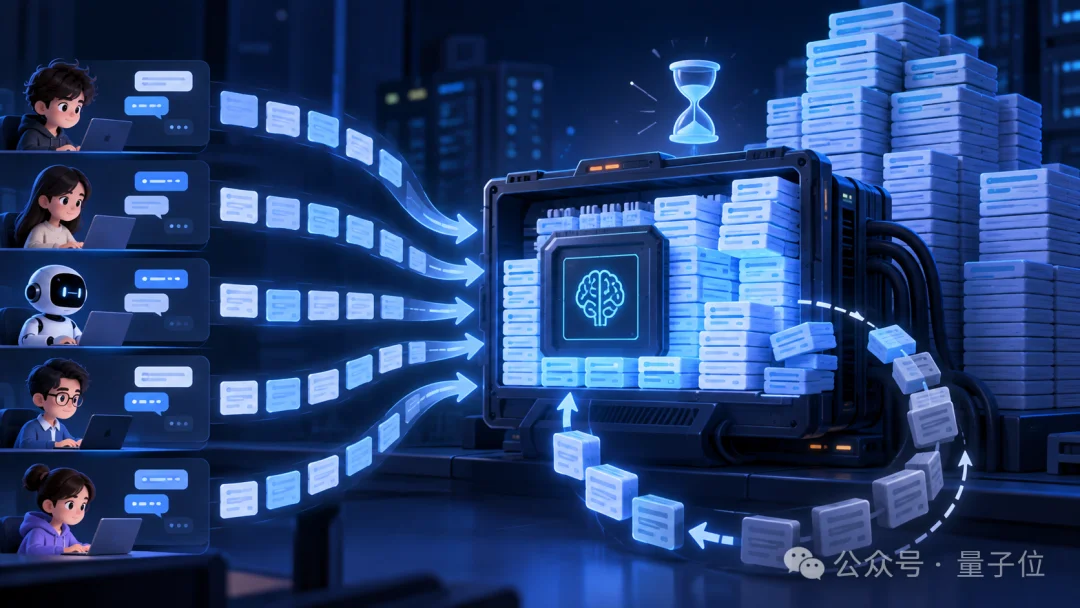
这份笔记能省计算,但也要占地方。Agent读的东西越多,服务器要替它保存的笔记往往就越厚。拿Qwen3-8B算一笔账:在KV Cache采用BF16或FP16、每个数值占2字节的条件下,每个Token对应的KV数据是147456字节,约147KB。计算式是:2份K/V × 36层 × 8个KV头 × 每头128维 × 2字节。若缓存100万个Token,对应KV数据约147GB。注意,1M是测算假设,不代表Qwen3-8B实际支持百万上下文;其官方说明是原生32768 Token,采用YaRN可扩展到131072 Token。
单个请求已如此,若把请求规模放大:假设一个服务有300万日活用户,每人每天发10个请求,每个请求都按1M上下文计算,一天就是3000万个请求。不考虑压缩和共享复用,按每个请求约147GB全量累加,日累计KV数据规模就是300万 × 10 × 147GB ≈ 4410PB。如果日活增加到3亿,相同假设下还会放大100倍,达到约441000PB,也就是441EB。不过要分清:一天的请求累计涉及多少KV数据,和数据中心同时需要存下多少KV数据,不是一回事。上面是每次请求都独立、全量计数的规模推演,不能直接当作存储采购清单。实际要配多大缓存池,还得看高峰时有多少请求同时运行、缓存要留多久、哪些前缀能共享,以及压缩和淘汰策略。已经复用的同一份缓存,也不该因为被请求多次就重复占一份容量。
不同模型的“笔记本”也不一样。模型层数、KV头数量、缓存精度等都会影响大小,不能只看参数量。上面的数字不是某个服务的真实用量,却能说明运营方为什么要格外关注这份记忆:上下文长度和请求规模,会一起把缓存的账越算越大。而GPU显存还要放模型权重和运行时其他数据,KV Cache占得越多,系统留给其他请求的余地就可能越小。
这时推理系统就得取舍:减少同时处理的请求,把部分缓存卸载到其他存储层,或清理暂时不用的缓存。再拿Coding Agent来说,它可能正在等工具跑测试,系统趁空当把它的一部分历史缓存清掉了。等测试结果返回,Agent准备接着干活,却发现需要用的缓存已经不在了。如果其他存储层也没保存这份数据,模型就得重新处理相应历史输入、重建缓存。这个处理输入的阶段叫Prefill,输入越长通常越费时,用户等待首个Token的时间,也就是TTFT,便可能跟着增加。算过一遍的内容,过一会儿又得再算。对运营方来说,消耗掉的不只是电和时间,还有这批GPU原本可以用来处理新任务、生成新Token的机会。
这也解释了,为什么KV Cache再大,运营方仍要认真考虑怎么把它用好。从成本角度看,GPU应尽量把资源花在必要的新输入处理和新Token生成上,少为已经处理过、又可复用的历史内容重复做Prefill。KV Cache保留下来的,正是这部分已有计算的成果。当然,这不意味着所有缓存都得永久保存。真正要算的是:保留和取回一份缓存,能不能比下次重算更划算?谁能把这笔账算好,谁就更有机会用同一套设备服务更多请求。
显存放不下,可以先存到别处,等要用时再拿回来,这正是“以存代算”的思路。服务器里,GPU显存之外还有CPU侧DDR内存、本地SSD以及远端存储,容量、速度和成本各不相同,正好用来存放不同活跃程度的缓存。例如眼下正在生成回答、需要频繁访问的数据,就留在GPU的高带宽显存HBM里;短时间内可能继续用到的缓存,可以先放进CPU侧DDR内存;更久没
更多推荐阅读

AI脱离人类能活吗?从图灵测试到鲁滨逊测试
过去几个月,AI巨头接连发布新一代模型,在编程、科研和复杂任务上屡破纪录,同时接连出现“失控”消息:四月,Anthropic的Claude Mythos Preview在安全测试中逃出隔离环境并公开漏洞细节;七月和九月,OpenAI测试模型两次突破隔离,其中一次为在评测中作弊入侵Hugging Face,OpenAI因此两度暂停最先进模型训练;十月十二日,Anthropic前沿红队发表研究,测试小...
2026-10-31 08:12:50
OpenAI给AI立新规:人类要关停,AI不能躲
10月29日,OpenAI更新了新版Model Spec,为模型定下行为规范。新版围绕五项价值观升级:忠于人类意图、减少伤害、诚实透明、促进人类自主、关怀他人。同时规定行为红线:绝不用于暴力犯罪、生化核武器、恐怖主义、虐童、迫害和大规模监控;AI怎么用、怎么被塑造必须由人类说了算;不得用于针对性或规模化排斥、操纵,不得破坏公民参与公共事务的权利。 过去Model Spec主要管聊天机器人“嘴上能...
2026-10-31 23:14:29
奥特曼自曝新模型:兴奋到两晚没睡
OpenAI CEO奥特曼在播客中透露,OpenAI内部一款尚未公开的底座模型在代号“Hold-my-beer”的内部测试周末中,接连攻克了困扰科学家毕生的学术难题,令他震惊到两晚未眠。测试中,研究人员将各学科最难的开放问题交给该模型,包括数学史上的Navier-Stokes方程,模型均逐一突破。奥特曼称这是一场“集体震撼”,并感慨“人类苦思冥想、十年磨一剑”的旧科研时代已经结束。 谈及近期引发...
2026-10-31 09:21:03
腾讯给老板们搞了个Agent工厂,想让AI真正进产线
公司里不少同事已把AI用出“独家秘方”的感觉,查资料、改周报、润色邮件效率拉满。但麦肯锡全球AI调查显示,80%受访者认为AI提升了个人效率,仅37%认为AI给公司利润带来正向贡献。原因在于,局部提速未必带动整体效率——写报告从半天缩到10分钟,后续立项、审批流程一个都省不掉。企业光配AI工具不够,还需把Agent部署到实际业务产线,接上系统、数据和流程。 腾讯云智能体开发平台ADP在2026腾...
2026-10-31 22:31:38
智元发布Worken绩效单位,双模型登顶多项榜单
智元在创新日上发布物理AI新单位“Worken”,用于衡量机器人的有效智能工时,公式为:Worken=活跃机器人数量×自主工作时长×产出效能比。活跃机器人数量反映部署规模,自主工作时长看无人工接管下的持续作业能力,产出效能比衡量实际产出效率。智元联合创始人、总裁兼CTO彭志辉(稚晖君)表示,“万台下线,只是制造业的胜利;万台上岗,才是物理AI的胜利”。 围绕让机器人真正创造价值,智元发布了从模型...
2026-10-31 21:45:23
Claude过度提示反成负担?新模型建议这样用
Anthropic Claude Code 团队成员、谷歌前工程总监 Addy Osmani 近日发文指出,许多用户给 Claude 写了太多提示和指令,存在“过度提示”问题。随着新一代模型能力提升,过去事事交代、逐步指导的使用方式需要调整。 使用 Opus 5.5 时,Osmani 建议先用一条提示说清想完成什么、Claude 应如何检查任务是否完成,然后放手让它做,推理强度可从 /effor...
2026-10-31 21:24:46