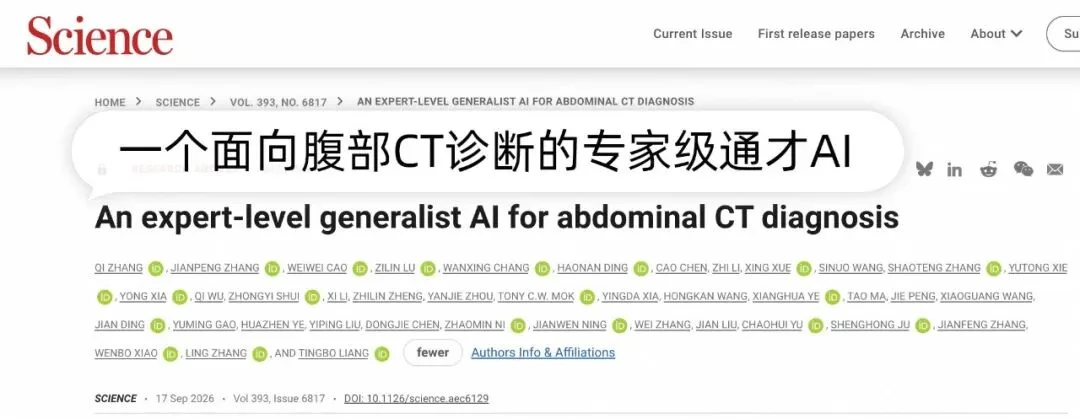
阿里医疗AI登Science正刊,Hinton十年前预言成真了吗
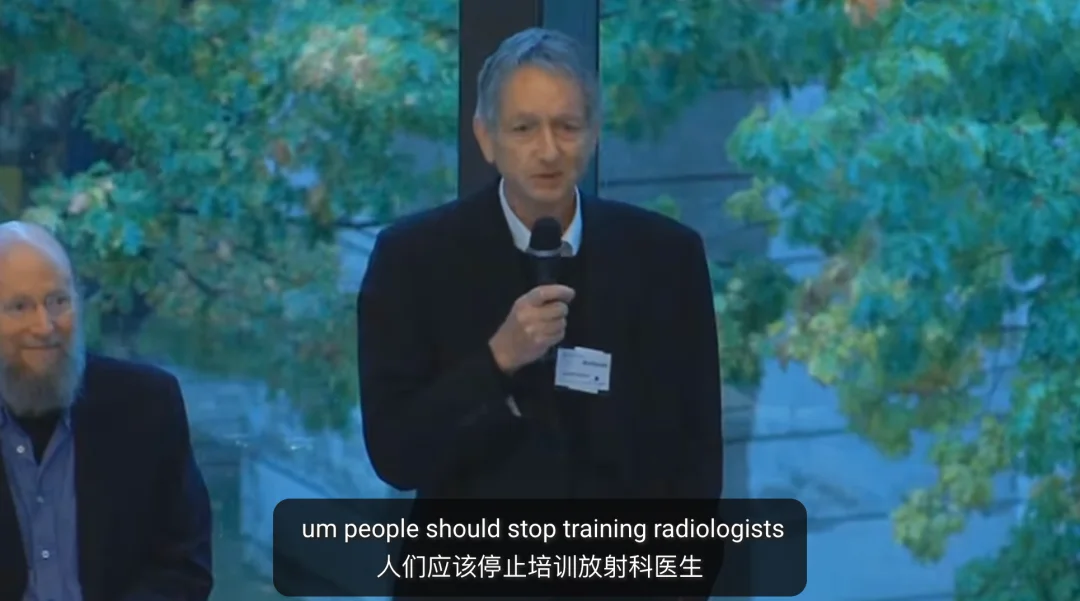
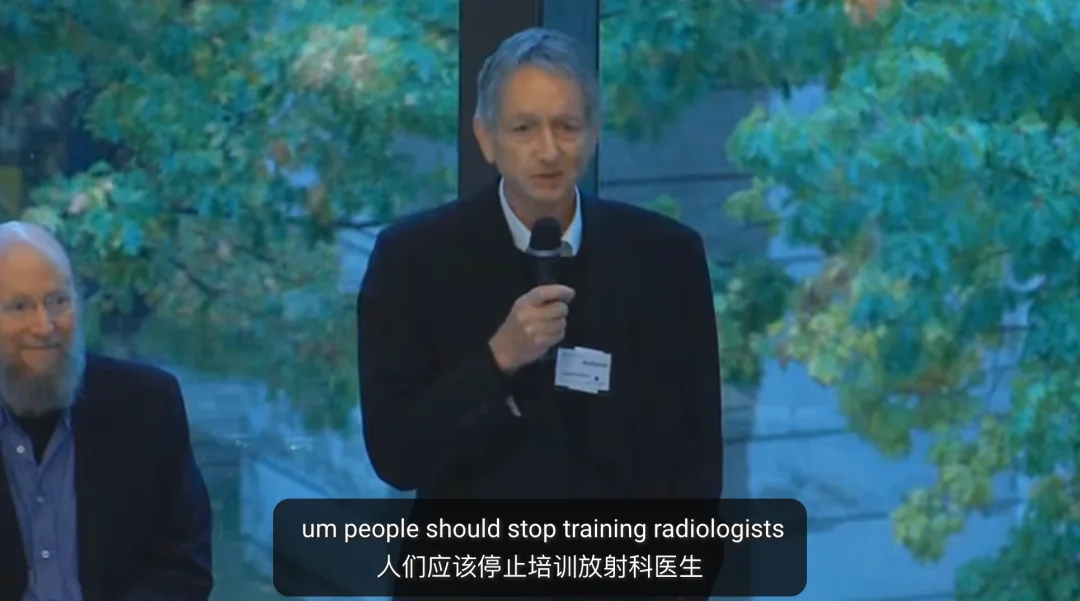
2016年11月,深度学习先驱、诺贝尔物理学奖得主Geoffrey Hinton曾预言应停止培养放射科医生,深度学习将在五到十年内做得更好。近十年过去,这一场景并未出现。放射科医生短缺仍是医疗体系面临的现实问题。AI虽已在不少影像任务中达到专家水平,却难以像医生一样全面检查多个器官、识别各种并存异常。
9月18日,阿里达摩院联合浙江大学医学院附属第一医院等机构研发的通用医疗影像模型DAMO RADAR登上《Science》正刊,并正式开源。这是近年来中国AI模型罕见登上《Science》正刊。RADAR全称为Rapid Abdominal Diagnosis with AI and Radiology,聚焦腹部增强CT,在涵盖18个解剖结构、146种临床相关影像学表现的近4万次系统评估中,平均AUC为0.913,首次达到影像科专家水平。该突破直面严肃临床挑战,经受住了多医院数万病例和大规模医生对照读片的检验。
医疗AI必须准确、可靠、可复核。模型在测试集取得高分后,仍需证明能适应不同医院、设备、扫描协议和患者人群。过去深度学习推动了一批专用模型,在肺结节、糖尿病视网膜病变等任务上达到甚至超过专家水平,但任务边界清楚。到了真实临床,任务边界更复杂,单项任务高分很难换算成全面诊断能力。达摩院高级算法专家张建鹏表示,传统流程下一个病种从立项到能力发布往往需要两三年,“真实世界病种成千上万,按照这个速度,可能一辈子都做不完。”资深算法专家张灵提到,胰腺癌筛查模型能识别细微肿瘤线索,却仍可能受腹水、术后改变或伪影干扰产生假阳性。真实世界病人很可能得的不是一种特定的病,而是多种不确定的病。
这些困难推动达摩院重新思考学习方式。DAMO RADAR要回答:能否让同一个模型学习不同解剖结构、影像表现和临床描述之间的关系,覆盖更广泛的疾病谱?视觉语言学习提供了新切入口。医院日常产生的CT影像和放射学报告天然存在对应关系,模型可直接学习配对数据,减少逐病种制作标签的需求。DAMO RADAR的关键设计是建立器官级细粒度图文对应关系。
浙大一院放射科主任肖文波介绍,一份腹部增强CT通常包含多个期相、数百幅图像,腹部涉及多个系统,许多器官密度接近,病灶与周围组织差异小。一套CT中的局部病灶可能只占三维影像极小部分,报告却同时描述多个器官。直接将整套CT与整份报告全局对齐,关键异常容易被稀释。DAMO RADAR将学习基本单元细化到解剖结构层面,将CT体数据与报告配对形成百万级图像—文本对,借助Qwen语言模型将报告拆分成不同解剖结构描述,再与相应影像区域配对,得到超过千万级解剖级图像—文本对。模型仍在带有体素级标注的TotalSegmentator数据集上进行分割预训练,最终得到18个目标解剖结构。
DAMO RADAR由视觉分支和文本分支组成。视觉分支使用三维U-Net提取影像特征,分割解码器定位不同解剖结构,模型根据分割结果聚合相应区域视觉特征。文本分支使用BERT编码器处理报告中对应描述。两类特征在同一表示空间中对齐,分割与图文对齐联合优化。张建鹏提到,这种组织方式更接近放射科医生按解剖结构依次检查的阅片习惯。
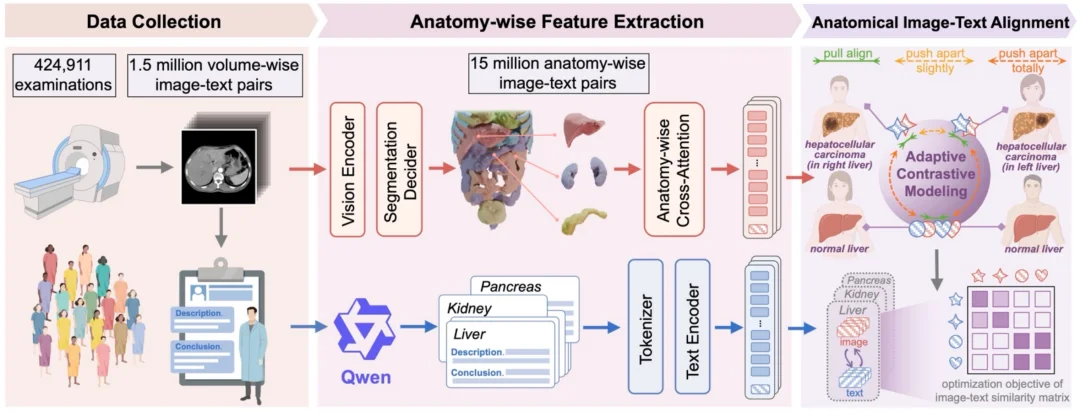
第二个关键环节是自适应对比建模。标准图文对比学习将配对影像与文本拉近,把其他不配对样本视为负样本,但患者不同不代表影像含义一定不同。DAMO RADAR根据解剖结构正常或异常状态及异常描述间语义相似性,动态调整对比学习监督关系。训练完成后,模型通过文本提示判断目标影像表现,无需为每项查询重新训练专用分类器。
内部真实世界测试使用独立时间段连续病例,共39,160次腹部增强CT检查,覆盖18个解剖结构和146种临床相关影像学表现。结果显示,DAMO RADAR平均AUC达0.913,95%置信区间为0.911至0.915。
更多推荐阅读
Kimi Code桌面版发布:支持BYOK,内置K3模型
智东西9月18日报道,Kimi面向编程场景推出的Kimi Code发布桌面版应用,原生适配macOS和Windows系统,内置旗舰模型Kimi K3,同时支持接入第三方模型。Kimi Code与Kimi客户端中的Kimi Work定位不同,前者更适合以Coding工作为主的用户。 订阅方面,Kimi Code支持Kimi Code Plan三档套餐,连续包月价格分别为99元/月、199元/月和6...
2026-09-18
谷歌DeepMind成立AGI研究所,诺奖得主挂帅
几周前,GPT-6 Astra横空出世,OpenAI首次官宣AGI实现。今天,谷歌DeepMind火速成立全新机构——DeepMind研究院(DMI),由Demis Hassabis、Shane Legg与James Manyika联手挂帅。以前的DeepMind只想搞出AGI,现在问题升级为:AGI真的来了以后,全人类到底拿什么接招? DMI专门研究“超级智能”对经济和社会的颠覆性影响,目标是...
2026-09-18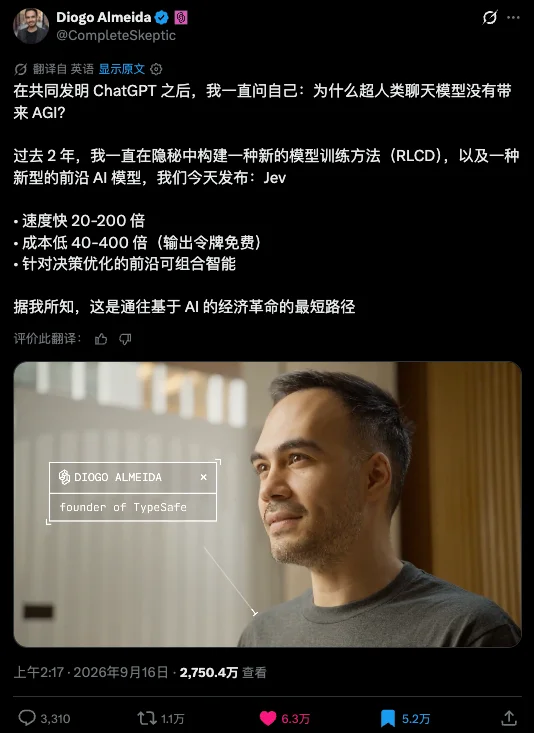
OpenAI前核心成员造出只会做选择题的大模型
TypeSafe AI创始人Diogo Almeida曾是OpenAI核心成员,参与创造RLHF和InstructGPT,2024年初离职创业,两年后推出全新模型Jev。该模型只做一件事:高频决策。它无法聊天、写代码或生成文字,是纯粹的通用分类器。 开发者Marcel Pociot用Jev做了浏览器插件,过滤X上不想看的内容,如引战、加密货币、政治争论等。每条帖子Jev在后台判断是否命中分类,平...
2026-09-18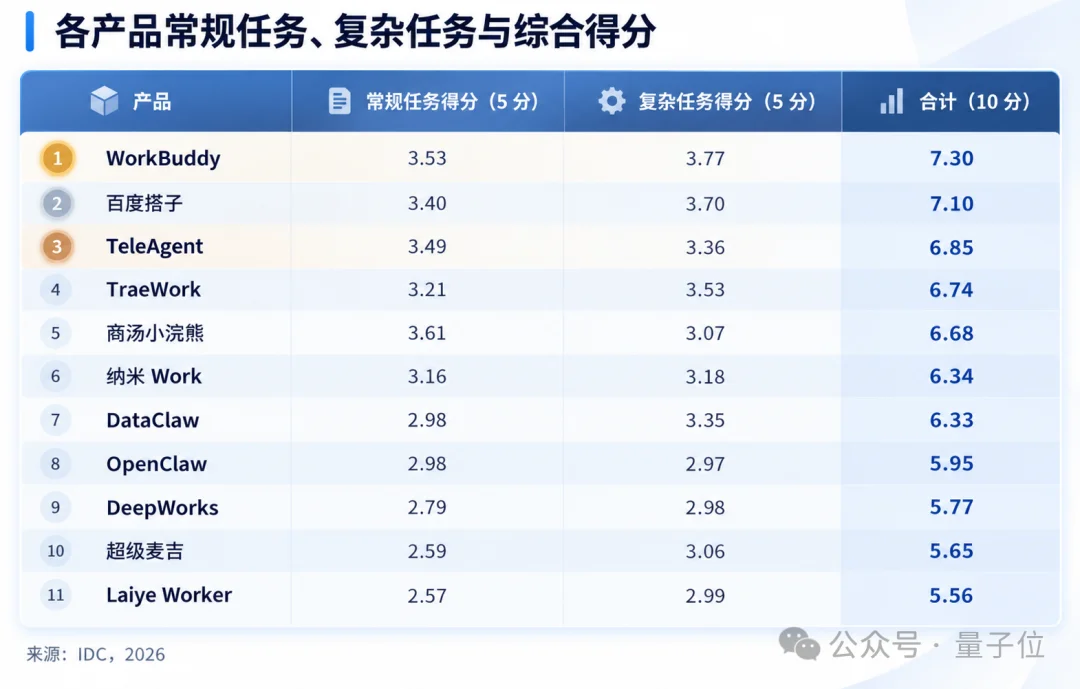
中国电信通用Agent杀入IDC实测前三
IDC发布国内首份《中国企业级通用Agent产品技术评估》,中国电信TeleAgent进入前三。此次评估未采用大模型Benchmark,而是用近百道非公开任务考察Agent在真实办公环境中的端到端执行能力。TeleAgent常规任务得分3.49分、复杂任务3.36分,九项能力中任务表现获满分,成本效率为评测最高分。该产品今年4月内部试用,7月推出V1.0,一个多月用户规模已接近120万。 IDC...
2026-09-18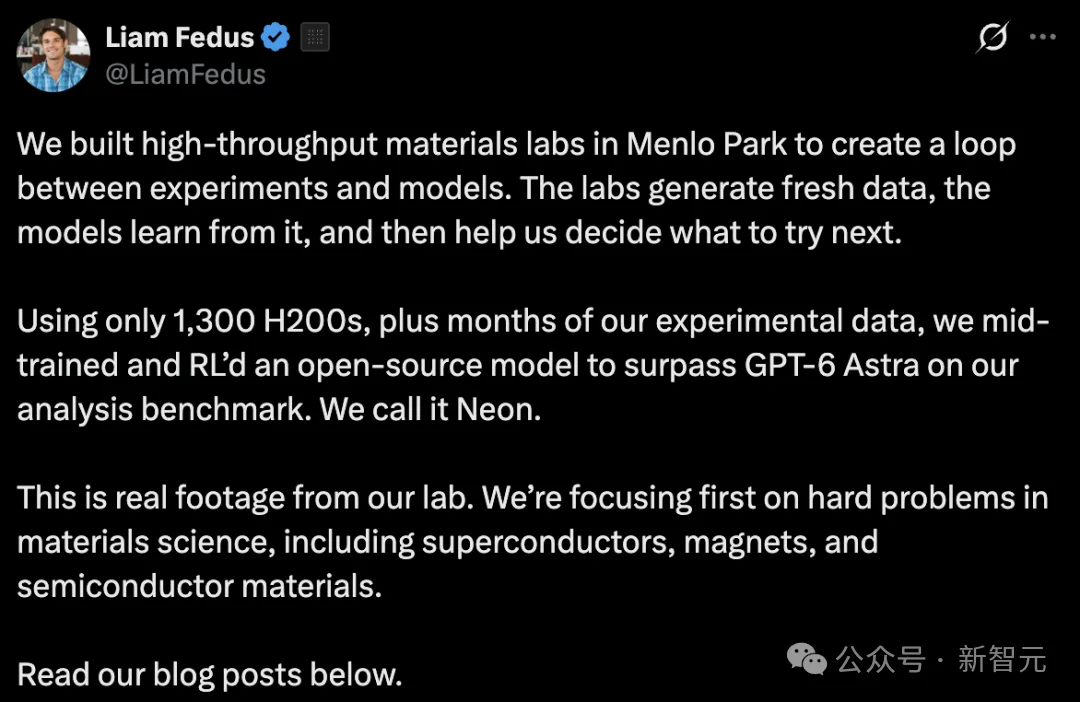
1300张卡击败GPT-6!前OpenAI副总裁造出材料大模型
前OpenAI研究副总裁Liam Fedus在X上发布Periodic Labs首个模型Periodic Neon:仅用1300张H200,加上数月实验数据,在自研XRD分析基准上超过GPT-6 Astra。Neon约1T参数,在134道高难度X射线衍射分析题组成的FrontierXRD上成功率达55.3%,领先GPT-6 Astra和Claude Fable 5.1。Astra据传总参数数万亿、...
2026-09-18
国产AI存储刷新全球纪录,焱融全栈布局曝光
智东西9月17日报道,9月1日,MLCommons发布MLPerf Storage v3.0基准测试榜单。焱融全闪AI存储F9000X在多项测试中拿下第一,验证其在极限AI训练负载下对高速网络带宽的高效利用能力。 随着AI从模型训练走向规模化推理,存储需处理的数据和任务持续增加。训练阶段要持续向GPU供给海量数据,并快速保存和恢复模型Checkpoint;推理阶段需管理不断膨胀的KV Cache...
2026-09-18