
DeepSeek“小更新”实测:许愿式编程能力大涨
DeepSeek将DeepSeek-V4.1-Flash更新为DeepSeek-V4.1-Flash-1017,看似只是加后缀的小迭代,实际能力提升明显。官方评测中,1017版本在终端操作和软件逆向上改进显著:Terminal-Bench 4.0从31.2分升至42.3分,ProgramBench从20.3分升至29.1分。与GPT-5.6 Sol相比,1017在9项测试中领先,终端操作和软件逆向...
精选 AI 新闻、神器与模型,一站式掌握人工智能前沿动态。
聚合 OpenAI、Anthropic、Google 等一手信源的最新动态
DeepSeek将DeepSeek-V4.1-Flash更新为DeepSeek-V4.1-Flash-1017,看似只是加后缀的小迭代,实际能力提升明显。官方评测中,1017版本在终端操作和软件逆向上改进显著:Terminal-Bench 4.0从31.2分升至42.3分,ProgramBench从20.3分升至29.1分。与GPT-5.6 Sol相比,1017在9项测试中领先,终端操作和软件逆向...

Kling 4.0全面上线,核心升级包括:30秒原生直出、最多15项素材参考、最多10张关键帧控制,以及强化高速运动与复杂运镜下的稳定性。 实测方面,网友用其生成小猫20秒一镜到底穿越多个场景、怪兽灾难片、复古街机风《侏罗纪公园》及30秒硅谷版《窃听风云》等视频,动态运动和参考输入表现受到认可。作者亲自测试暴雨夜屋顶特工逃亡,连续十余个高难度动作配合高速运镜,动作衔接利落、重心变化自然,但掏枪瞬...

AI 生图和改图已经很强,却依然救不了双 11 期间疯狂加班的设计师。AI 出图确实快,但出图之外的灵感、沟通协作和反复改稿才是耗时大头:团队要先理解客户品牌调性,换成 AI 仍要反复交代要求,项目一长还怕风格跑偏;下个类似项目,上次磨合好的经验又得从头教。老板和客户看不到这些隐形成本,只会问都有 AI 提速了,交付速度为何没成倍提升。现阶段的设计 AI 让人感觉本末倒置,过去指挥人,现在指挥 A...

OpenAI近日披露了一项Agent极限实测:10,000个Agent同时运行,连续工作36至48小时,每天消耗1万亿Token,单轮任务量相当于人类工程师41年的工作量。 完成这一测试的是横跨旧金山和纽约的初创公司Third Moment Research,首个试验田选在量化金融。团队在Docker隔离容器中部署了1TB历史行情数据、技术文档和量化代码库。起初用Codex配合GPT-5.6检查...

DeepSeek官方未发公告,但网友发现「deepseek-flash」接口输出结果发生变化。对比9月与10月12日API生成结果,新版在细节、动画流畅性和光影效果上均有提升,美学风格也有变化,但生成速度稍慢。网友猜测可能是DeepSeek-v4.2-flash、v4.1-flash新checkpoint,或v4.1-pro返场。有测试者将10月版与GPT 6 Luna对比制作Minecraft克...

谷歌Gemini 4 Argon正式发布,一度被认为掉队的谷歌重回第一梯队。跑分显示,它在文本、逻辑上与GPT-6 Astra和Claude Opus 5.5不相上下,价格仅为对手五分之一,速度快数倍。更关键的是,它是首个同时具备图像、视频、语言甚至物理直觉的通用物理推理模型。沃顿商学院教授Ethan Mollick评价称,Gemini 4与其他模型截然不同。 实测中,Argon能用傅里叶级数生...

传统多模态检索通常需要维护多套embedding模型,文本、图片、音频各用一套链路,再合并排序。Google最近开源的EmbeddingGemma 2(EG2)提供了更便捷的方案:740M参数,可将文本、图片、视频和音频编码到同一向量空间。相比ImageBind等统一多模态模型,EG2的特点在于模型规模和资源配置:完整模型仅740M参数,编码器可按模态加载,默认768维向量可裁剪到256维甚至12...

阶跃星辰推出 Step 5 Preview,官方定位是“往前推一步帕累托前沿”,即在能力相近的模型中追求最低成本。官方数据显示,同一任务成本约为 Claude Opus 5 的八分之一,是 GLM-5.3 和 Kimi K3 的 35%。10 月 8 日上线 OpenRouter,12 小时内登顶 Trending 第一。在 Artificial Analysis 智能指数上得分 44,官方称其位...

自从ChatGPT-6 Astra更新,社交平台就被它调用Blender建模的测试刷屏。用户用它搭建江南园林、做3D小游戏、生成《我的世界》,甚至操控机械臂削黄瓜皮、通关羊了个羊。官方宣传片本将亮点放在语音对话功能上,但用户更关注AI建模——这既是普通人难以触及的专业领域,又能直观看到结果。 实测Astra调用Blender建模、渲染,并调用Seedance 2.5生成AI视频后,结论是:某些基...

GPT-6 Sol和Luna上线,OpenAI给出的重点是价格。Sol的API输入每百万token 2美元、输出10美元;Luna输入0.1美元、输出0.5美元,均为对应GPT-5.6价格的一半,Luna成为本轮最便宜型号。 作者用同一网站复刻案例测试Luna High。该站首页以大面积黄色铺底,中间有金色唱片,鼠标移动会触发背景流动反馈,并含大量作品图片和动效。Luna自行整理公开品牌素材、字...

看来老马也知道,国庆前后基模圈不好混,所以先发先占坑——Grok 4.7来了。 更大的底模、上下文拉到50万Token,重点猛练Coding、Agent以及动辄跑上几个小时的复杂任务。软件工程、电气工程、长时办公、终端和法律任务全面开花。官方评测表中,电气工程基准测试以64%拿下第一,终端操作基准测试从20.3%跃升到38%。价格方面,输入2美元/百万Token,输出6美元/百万Token,加量...

一款能走进真实工作的生图模型。 在真实工作中,做图往往只是任务的一部分:公众号文章需要封面和多张配图,企业招聘需要海报、易拉宝、折页等整套物料,设计过程中还可能随时需要改文字、换服装、调整局部元素。这意味着办公场景的生图需求,对模型的要求已不只是画面效果,还需要理解上下文和用户意图,处理已有素材,组织图片中的信息与版式,并在发现问题后继续修改。信息要完整,设计要美观,修改要可控,缺一不可。 带...

Qwen推出全模态模型Qwen3.8-Omni-Flash,在WildClawBench-MM等30项评测中平均得分比上一代Qwen3.5-Omni-Plus高出26%,音频能力整体超越Gemini 3.8 Flash,音视频能力接近Gemini。API价格大幅下降:相比上一代,每小时音频输入价格下降超98%,每小时音视频联合输入价格下降超93%。现价为每百万Token输入0.8元、输出2.7元,...

AI NPC 开始趁用户下线,继续过自己的日子了。 以前开放世界能塞几百个角色,城市有昼夜,NPC 按日程吃饭上班睡觉,但这些行为大多提前写在程序里。用户不触发任务,故事便不会发生,用户一离开游戏,NPC 就集体趴窝。 大模型出现后,开发者开始尝试让 AI 参与角色决策和世界运行。 最早跑出来的是 AI 生成故事。2019 年,Latitude 推出 AI Dungeon,让 AI 当起「地...

最近,一个不会说话的大模型在网上火了。 它叫 Jev,不能写文章,不能写代码,也不能和你聊天。 这么一个哑巴模型,发布不到 36 小时就有 14 万开发者冲进去内测。 几天内造出了几百个玩法,恐怖如斯... 为什么这么多人上头?因为 Jev 只做判断,不生成文字。 少了逐字生成答案这一步,它反倒比大语言模型更快,也更便宜。 一次判断只要 70 到 500 毫秒,部分场景比大语言模型快近...
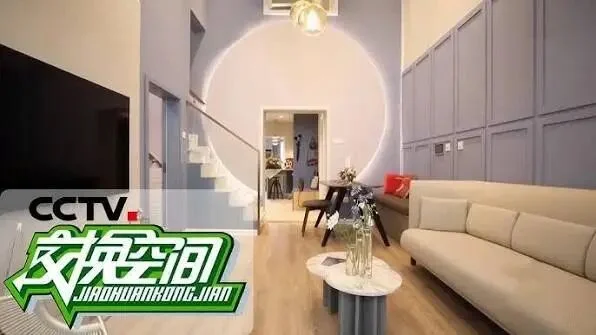
小时候看交换空间和梦想改造家,总觉得空间设计不难,脑子里自带3D渲染器。真到自己上手,光摆沙发茶几就难倒一大批人。 最近我搬家后空出一个房间想做拍摄间,想做成包豪斯风格,TB收藏夹塞满了家具,却迟迟没下单——对空间和物体尺寸没把握,怕最后转身都困难。 正好GPT-6 Astra来了,我用它和Aholo Lux3D把拍摄间布局全设计好了。思路是:先让GPT-6做场景灰模,Aholo Lux3D按...
世界模型近期密集出现,但多数仍是研究预览版。最近一两个月,多家厂商开放实测,包括蚂蚁LingBot-World 2.0、阿里HappyOyster 1.0、腾讯混元HY-World 2.1、爱诗R1,以及8月26日开源的Zing-0.5。本次评测选取这五款可上手的产品,InSpatio-World因未开放完整入口未纳入。 实测发现,五家玩法差异明显,可归纳为三类能力:漫游、导演、联合控制。Lin...
智东西9月9日报道,匿名模型Omen Alpha近日突然出现,凭借超高性价比迅速引发热议。上线5天后,在免费模型Muse Spark 1.3 Contributor冲击下,仍高居OpenCode调用量榜单第七,被网友称为“又是来自东方的神秘模型”。社区测试中,开发者普遍反馈“快”,有人仅用1小时30分钟完成简易3D世界建模,而用GLM 5.3 Flash和GPT 5.6 Luna以同样提示词开发用...
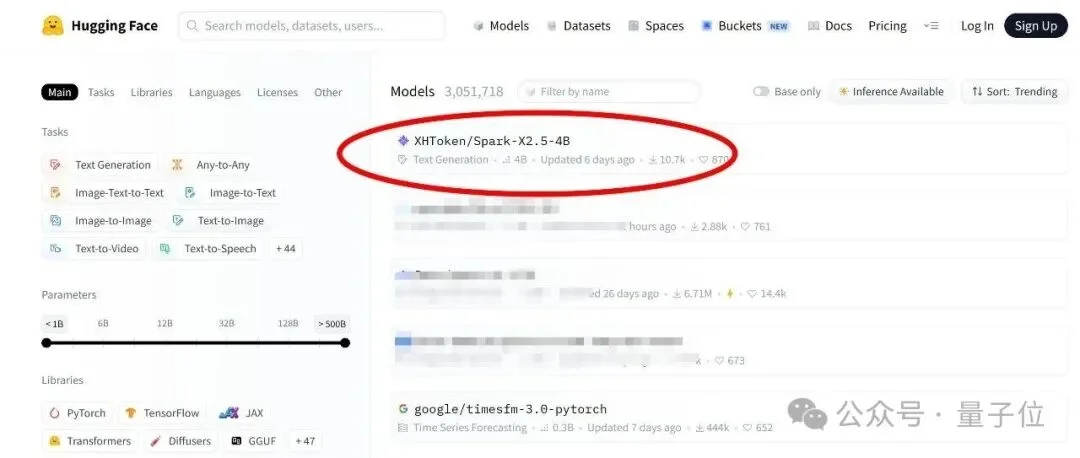
最新消息,参数293B的讯飞星火X2.5上线。此前讯飞开源了星火X2.5两款端侧模型,4B和1.7B,均能在端侧原生跑100万Token上下文。社区将其量化、移植到Mac、T4和WebGPU,还有人接入Agent工作流,把4B模型送上Hugging Face趋势榜第一。 星火X2.5为MoE大模型,参数293B-A30B,重点提升代码、智能体能力,覆盖200余种语言。现已上线讯飞开放平台,API...
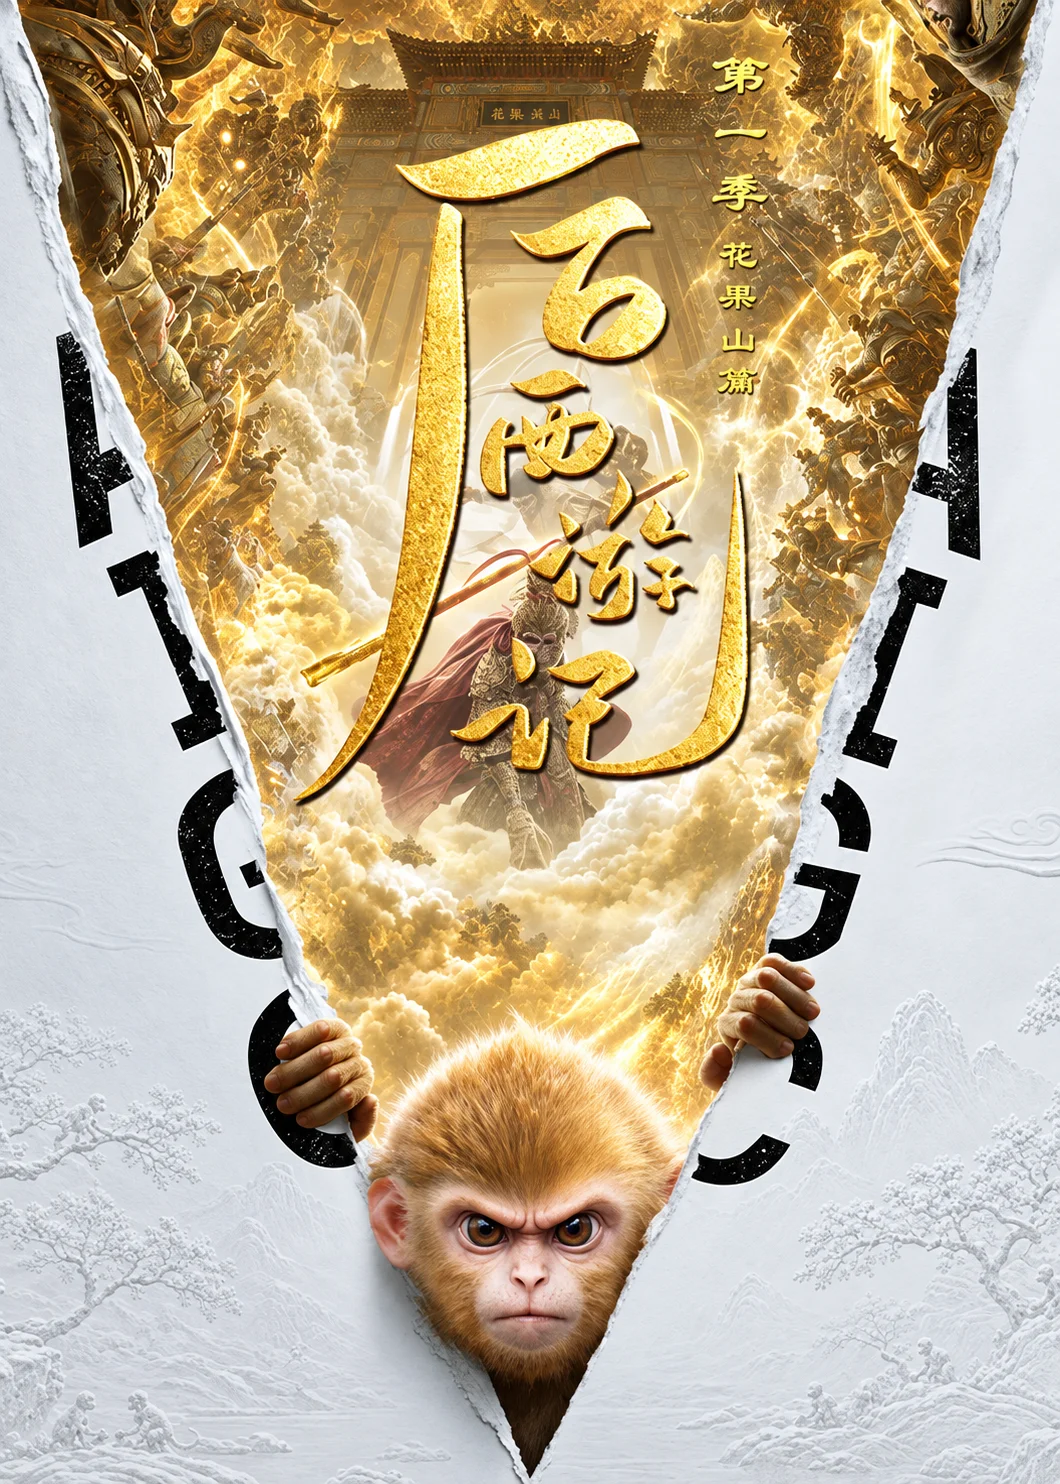
上周,《后西游记》在湖南卫视黄金档上映,全程采用AIGC参与制作,并可根据观众反馈调整未播内容。首播后,该剧拿下同时段省级卫视收视第一,制作成本约为真人剧的十分之一,芒果TV官方播放量达1.1亿次。 AI视频正进入新阶段:过去AI多承担单镜头、单图片生成,如今行业开始探索AI参与完整内容生产流程。2026世界人工智能大会期间,智象未来发布全球首个无限时长内容创作智能体vivago R1,现已全球...
精选提升效率的 AI 工具,按场景分类快速找到合适工具
追踪国内外主流大模型与垂直领域模型最新进展
扫码关注公众号「60秒看懂AI」
微信搜索「60秒看懂AI」也可关注